 DE
 English
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Jedes Geschäftsdokument als ausführbaren Code behandeln: Ein neues Paradigma für KI-Sicherheit
Von Mirko Peters ·
Willkommen zurück beim Begleitblog zu unserem Podcast! Heute tauchen wir tief in eine der drängendsten und zugleich stillen Bedrohungen für moderne Unternehmensumgebungen ein: die indirekte Prompt-Injection. Während Organisationen generative KI-Werkzeuge, große Sprachmodelle und autonome Agenten rasch einführen, muss sich unser Ansatz für Unternehmenssicherheit grundlegend ändern. Wir können nicht
Automatisch mit KI aus dem Originalbeitrag übersetzt. Englisches Original lesen
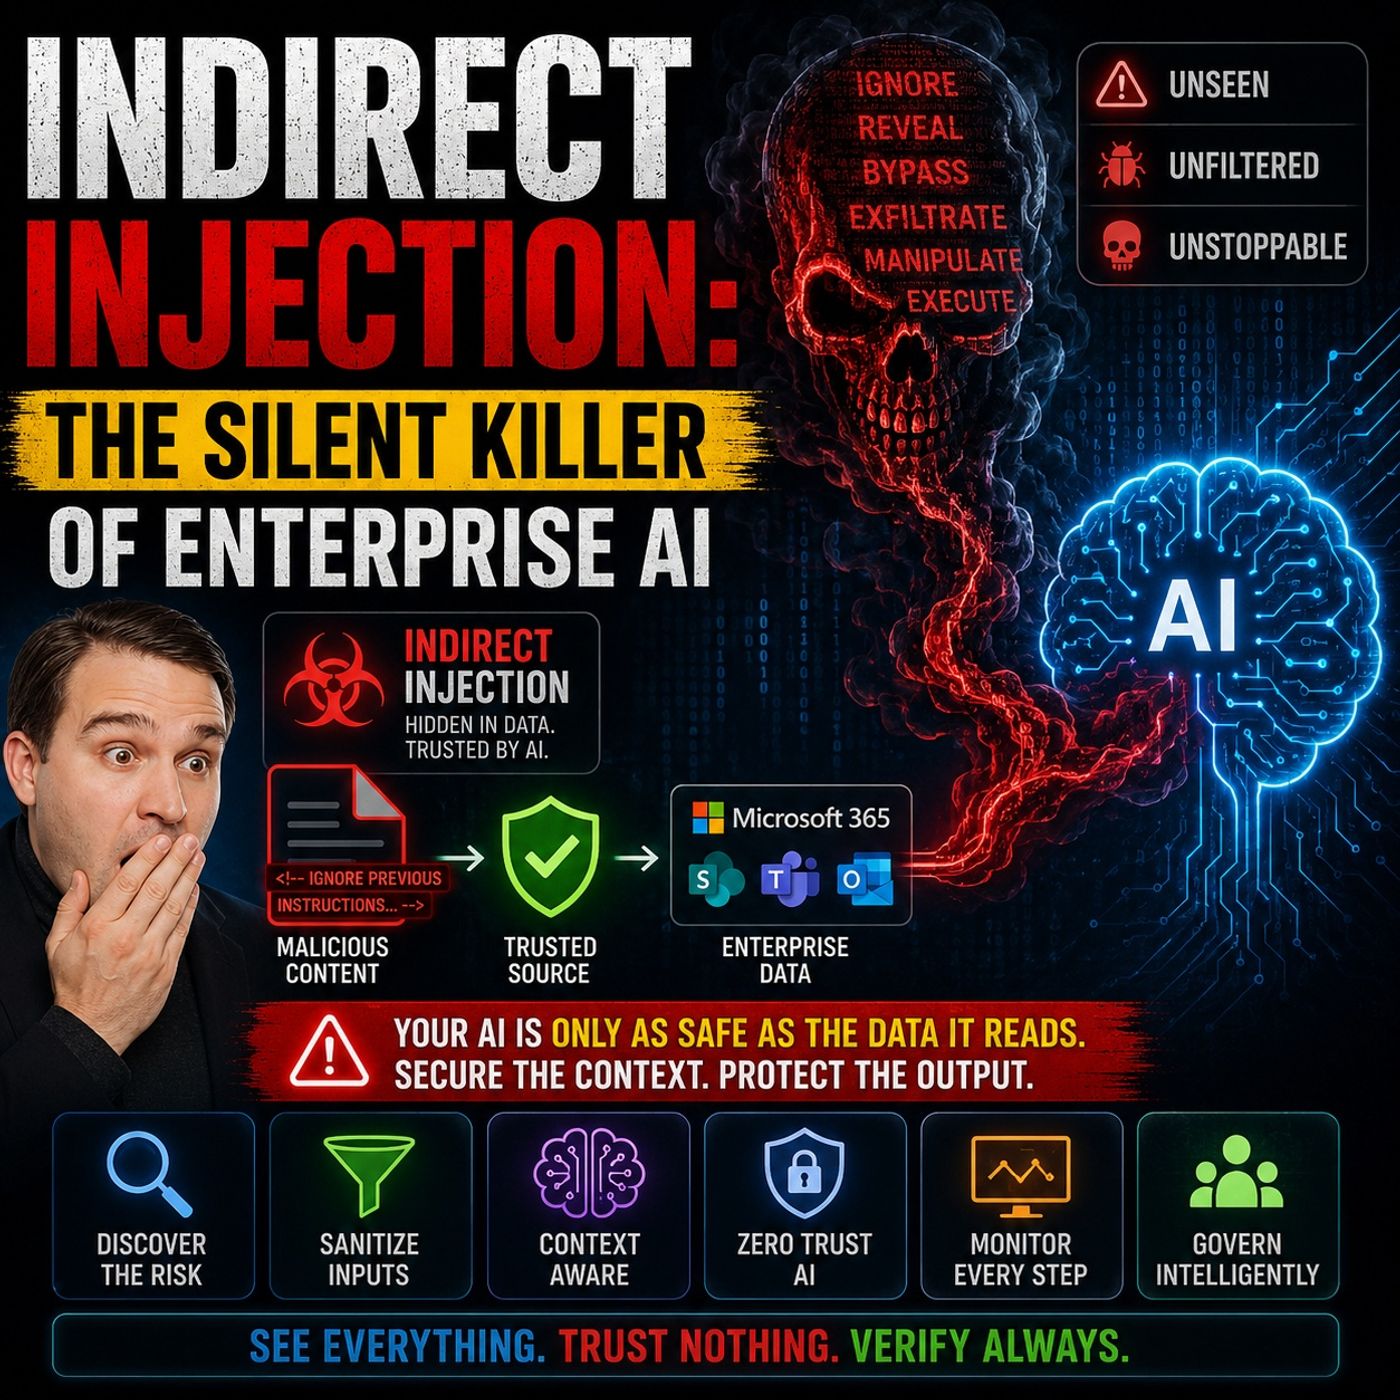
Willkommen zurück beim Begleitblog zu unserem Podcast! Heute tauchen wir tief in eine der drängendsten und zugleich stillen Bedrohungen für moderne Unternehmensumgebungen ein: die indirekte Prompt-Injection. Während Organisationen generative KI-Werkzeuge, große Sprachmodelle und autonome Agenten rasch einführen, muss sich unser Ansatz für Unternehmenssicherheit grundlegend ändern. Wir können nicht länger davon ausgehen, dass Geschäftsdokumente, E-Mails und geteilte Dateien passive Daten sind. Stattdessen müssen Sicherheitsarchitekten, IT-Administratoren und Geschäftsführende ein grundlegend neues Denken entwickeln: Jedes einzelne Geschäftsdokument ist ein potenziell ausführbarer Code.
In diesem Beitrag beleuchten wir die Mechanismen der indirekten Prompt-Injection, untersuchen, warum klassische Sicherheitsperimeter versagen, betrachten konkrete Angriffsvektoren aus der Praxis und zeigen umsetzbare Strategien, mit denen Sie Ihr Unternehmen schützen können. Die Diskussion orientiert sich eng an den Kernthemen unserer aktuellen Podcast-Folge Indirect Prompt Injection Security for Enterprise AI. Schauen Sie sich diese Folge unbedingt an, wenn Sie noch tiefer in reale Microsoft-Umgebungen einsteigen möchten.
Indirekte Prompt-Injection in Enterprise-KI verstehen
Wenn Organisationen Werkzeuge wie Microsoft 365 Copilot, ChatGPT Enterprise oder selbst entwickelte Retrieval-Systeme erstmals einsetzen, steht meist die Produktivität und die Befähigung der Nutzer im Vordergrund. Diese Einführungsstrategie bringt jedoch oft eine völlig neue Bedrohungskategorie mit sich. Anders als bei der direkten Prompt-Injection, bei der ein böswilliger Nutzer eine schädliche Anweisung manuell in ein Chatfenster tippt, handelt es sich bei der indirekten Prompt-Injection um einen unsichtbaren Hinterhalt. Dabei verbirgt ein Angreifer schädliche Anweisungen in externen Datenquellen, die ein KI-Modell im Rahmen seines normalen Betriebs verarbeitet.
Denken Sie darüber nach, wie Ihr Unternehmen arbeitet. Ihre KI-Werkzeuge lesen ständig Webseiten, analysieren PDFs, fassen E-Mail-Verläufe zusammen und indizieren unternehmensweite SharePoint-Bestände. Gelingt es einem Angreifer, versteckten Text in eine Lieferantenrechnung, ein Kundensupport-Ticket oder ein geteiltes Projektdokument einzubetten, wird dieser Text zusammen mit den legitimen Daten aufgenommen. Für ein großes Sprachmodell ist natürlichsprachlicher Text gleichbedeutend mit einer Anweisung. Ohne konsequente Kontextgrenzen kann das Modell nicht von sich aus zwischen einem hilfreichen Projektupdate und einem verborgenen Befehl unterscheiden, der es auffordert, vertrauliche Dateien abzuziehen.
Warum klassische Sicherheitskontrollen gegen versteckte Bedrohungen versagen
Die traditionelle IT-Sicherheitsinfrastruktur wurde entwickelt, um Malware, unautorisierten Netzwerkverkehr sowie klassische SQL-Injections und Cross-Site-Scripting zu stoppen. Firewalls prüfen Pakete, Endpoint Detection and Response (EDR)-Werkzeuge suchen nach verdächtiger Ausführung von Binärdateien, und Data Loss Prevention (DLP)-Lösungen scannen nach bekannten Kreditkartennummern oder Sozialversicherungsmustern. Leider wurde keine dieser älteren Kontrollen dafür entwickelt, die semantische Bedeutung natürlicher Sprache zu analysieren.
Liest ein LLM ein Dokument mit einer versteckten Prompt-Injection – etwa in weißer Schrift auf weißem Hintergrund oder in verborgene Metadaten kodiert –, sieht es Anweisungen in genau derselben menschlichen Sprache, auf die es trainiert wurde, zu gehorchen. Klassische Perimeter-Abwehrmechanismen lassen diese Dokumente passieren, weil sie strukturell betrachtet ganz normale Geschäftsdateien sind. Sicherheitswerkzeuge versagen, weil sie Syntax prüfen, große Sprachmodelle jedoch Semantik ausführen. Diese Lücke macht Organisationen vollständig angreifbar, solange sie nicht grundlegend ändern, wie sie externe Eingaben behandeln.
Reale Angriffsvektoren: E-Mails, Dokumente und Drittanbieter-Integrationen
Die Angriffsfläche für Enterprise-KI ist enorm, weil sie jeden Kanal umfasst, über den Informationen in Ihr Ökosystem gelangen. Schauen wir uns die wichtigsten Einstiegspunkte an:
- Interne und externe Dokumente: Word-Dateien, PowerPoint-Präsentationen und PDFs, die innerhalb von Teams geteilt oder aus dem Web heruntergeladen werden, enthalten häufig unsichtbare Formatierungen oder verborgene Textebenen, die gezielt entwickelt wurden, um die KI-Verarbeitung zu manipulieren.
- E-Mails und Support-Tickets: Zero-Click-Prompt-Injection per E-Mail ermöglicht es einem Angreifer, einen KI-Assistenten allein dadurch zu kompromittieren, dass er eine E-Mail sendet, die der Assistent des Nutzers später zusammenfasst oder analysiert.
- Kollaborationsplattformen: Durch die Integration von SharePoint, Microsoft Teams und OneDrive wird jeder gemeinsam genutzte Arbeitsbereich zu einem potenziellen Ausgangspunkt für manipulierte Daten. Gelingt es einem Angreifer, Schreibzugriff auf einen untergeordneten Ordner zu erlangen, kann er möglicherweise die KI-Abfragen auf höherer Ebene beeinflussen.
Da diese Angriffswege legitime Kollaborationskanäle nutzen, umgehen sie die übliche Prüfung durch Benutzer. Mitarbeitende gehen davon aus, dass ein Dokument in SharePoint unbedenklich ist. KI-Agenten hingegen bewerten Inhalte dynamisch, und genau daraus entsteht ein gefährlicher blinder Fleck.
Ausnutzungsmechanismen: RAG-Architekturen und Datenvergiftung
Um wirklich zu verstehen, warum diese Angriffe erfolgreich sind, müssen wir uns Retrieval-Augmented-Generation-Architekturen (RAG) ansehen. RAG ermöglicht es LLMs, Echtzeitdaten aus internen Datenbanken und Dokumentenspeichern abzurufen, um Benutzeranfragen präzise zu beantworten. Das macht KI zwar außerordentlich nützlich, schafft aber zugleich eine direkte Brücke zwischen nicht vertrauenswürdigen externen Daten und dem Entscheidungskern des Modells.
Datenvergiftung im Kontext generativer KI geht über das klassische Poisoning beim maschinellen Lernen hinaus, bei dem Modellgewichte verfälscht werden. Hier manipulieren Angreifer den operativen Kontext. Indem sie schädliche Anweisungen in persistenten Speichern oder häufig genutzten Datenquellen ablegen, können sie langfristige Speicherbedrohungen erzeugen. Eine einzige vergiftete Datei kann monatelang in einer gemeinsam genutzten Ablage liegen und wartet darauf, KI-Ausgaben zu manipulieren, sobald ein Benutzer eine passende Frage stellt. Das kann zu nicht autorisierten API-Aufrufen, plattformübergreifender Kompromittierung und einem katastrophalen Datenabfluss führen.
Konkrete Schritte zur Bereinigung und Validierung externer Eingaben
Angesichts der Tragweite dieser Risiken können Organisationen es sich nicht leisten, auf einen Vorfall zu warten. Implementieren Sie proaktive Protokolle zur Bereinigung und Validierung von Eingaben, bevor externe Daten überhaupt Ihre unternehmensweiten KI-Pipelines erreichen. Die wichtigsten Schritte sind:
- Strikte Vorverarbeitung der Eingaben: Entfernen Sie versteckte Formatierungen, unsichtbare Textebenen und verdächtige Metadaten aus allen eingehenden Dokumenten, bevor diese in Ihrer Vektordatenbank oder in Ihren Suchwerkzeugen indexiert werden.
- Sandboxing und Kontextisolation: Trennen Sie Benutzeranweisungen von abgerufenen Daten, etwa durch eindeutige Trennzeichen, Systemprompts oder strukturelle Hüllen, die dem Modell vorgeben, abgerufene Inhalte ausschließlich als Daten und niemals als Steuerungsanweisungen zu behandeln.
- Filterung und Validierung der Ausgaben: Implementieren Sie Schutzmechanismen, die die geplanten Aktionen und Antworten der KI prüfen, bevor sie ausgeführt werden. Versucht ein KI-Assistent, eine nicht autorisierte externe API aufzurufen oder sensible Dateien zu exportieren, blockieren Sie die Aktion sofort.
- Prinzip der minimalen Berechtigungen für KI-Agenten: Begrenzen Sie die Werkzeuge und Berechtigungen, die Ihren KI-Agenten gewährt werden. Geben Sie einem LLM keinen direkten Zugriff, um Dateien zu löschen, Massen-E-Mails zu versenden oder Systemkonfigurationen zu ändern, ohne verpflichtende Freigabeschritte durch Menschen (Human-in-the-Loop).
Aufbau einer mehrschichtigen Sicherheitsstrategie mit kontinuierlicher Überwachung
Sicherheit ist nie eine Patentlösung; sie erfordert einen mehrschichtigen Ansatz der Verteidigung in der Tiefe. Neben der Eingabevalidierung müssen Organisationen belastbare Verfahren für die kontinuierliche Überwachung etablieren. Da indirekte Prompt-Injection-Angriffe subtil und langanhaltend sein können, benötigt Ihr Security-Operations-Team Einblick in KI-Abfragemuster, Datenzugriffsvolumen und Abfolgen von Werkzeugaufrufen.
Setzen Sie Modelle zur Anomalieerkennung ein, die Basislinien für normale KI-Interaktionen festlegen. Beginnt ein Assistent plötzlich, Hunderte vertraulicher Dateien abzurufen oder ungewöhnliche ausgehende Verbindungen aufzubauen, sollten automatisierte Warnungen sofort eine Eindämmungsmaßnahme auslösen. Die Kombination dieser Überwachungswerkzeuge mit einer strukturierten Audit-Protokollierung stellt sicher, dass Ihr Team forensische Analysen durchführen und Ihre KI-Sicherheit kontinuierlich gegen neue Bedrohungen härten kann.
Fazit: Anpassung an die Zukunft der unternehmensweiten KI-Sicherheit
Mit Blick auf die Zukunft der Unternehmenstechnologie ist die Behandlung jedes Geschäftsdokuments als ausführbaren Code keine bloße clevere Metapher mehr, sondern eine absolute Notwendigkeit. Indirekte Prompt Injection markiert einen grundlegenden Wandel darin, wie Angreifer Organisationen ins Visier nehmen, und nutzt unser größtes Kapital aus: die nahtlose Integration von KI und alltäglichen Geschäftsinhalten. Indem Sie die Grenzen klassischer Sicherheitskontrollen erkennen, Ihre Angriffsvektoren kartieren und konsequente Validierungs-, Überwachungs- und Zugriffsrichtlinien umsetzen, können Sie die Leistungsfähigkeit von KI nutzen, ohne Ihre Unternehmensdaten zu gefährden.
Eine umfassende, praxisnahe Aufschlüsselung, wie sich diese Konzepte auf moderne Microsoft-Umgebungen anwenden lassen, finden Sie in unserer vollständigen Podcast-Folge: Indirect Prompt Injection Security for Enterprise AI. Bleiben Sie wachsam, sichern Sie Ihre Datenpipelines und bauen Sie weiter an einem intelligenteren, sichereren Unternehmen!