 NL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Elk zakelijk document behandelen als uitvoerbare code: een nieuw paradigma voor AI-beveiliging
By Mirko Peters ·
Welkom terug bij de podcast-companionblog! Vandaag duiken we diep in een van de meest urgente en stille bedreigingen voor moderne bedrijfsomgevingen: indirecte prompt injection. Naarmate organisaties in rap tempo generatieve AI-tools, large language models en autonome agents adopteren, moet onze aanpak van bedrijfsbeveiliging fundamenteel veranderen. We kunnen er niet langer van uitgaan dat zakeli
Automatically translated with AI from the original post. Read the English original
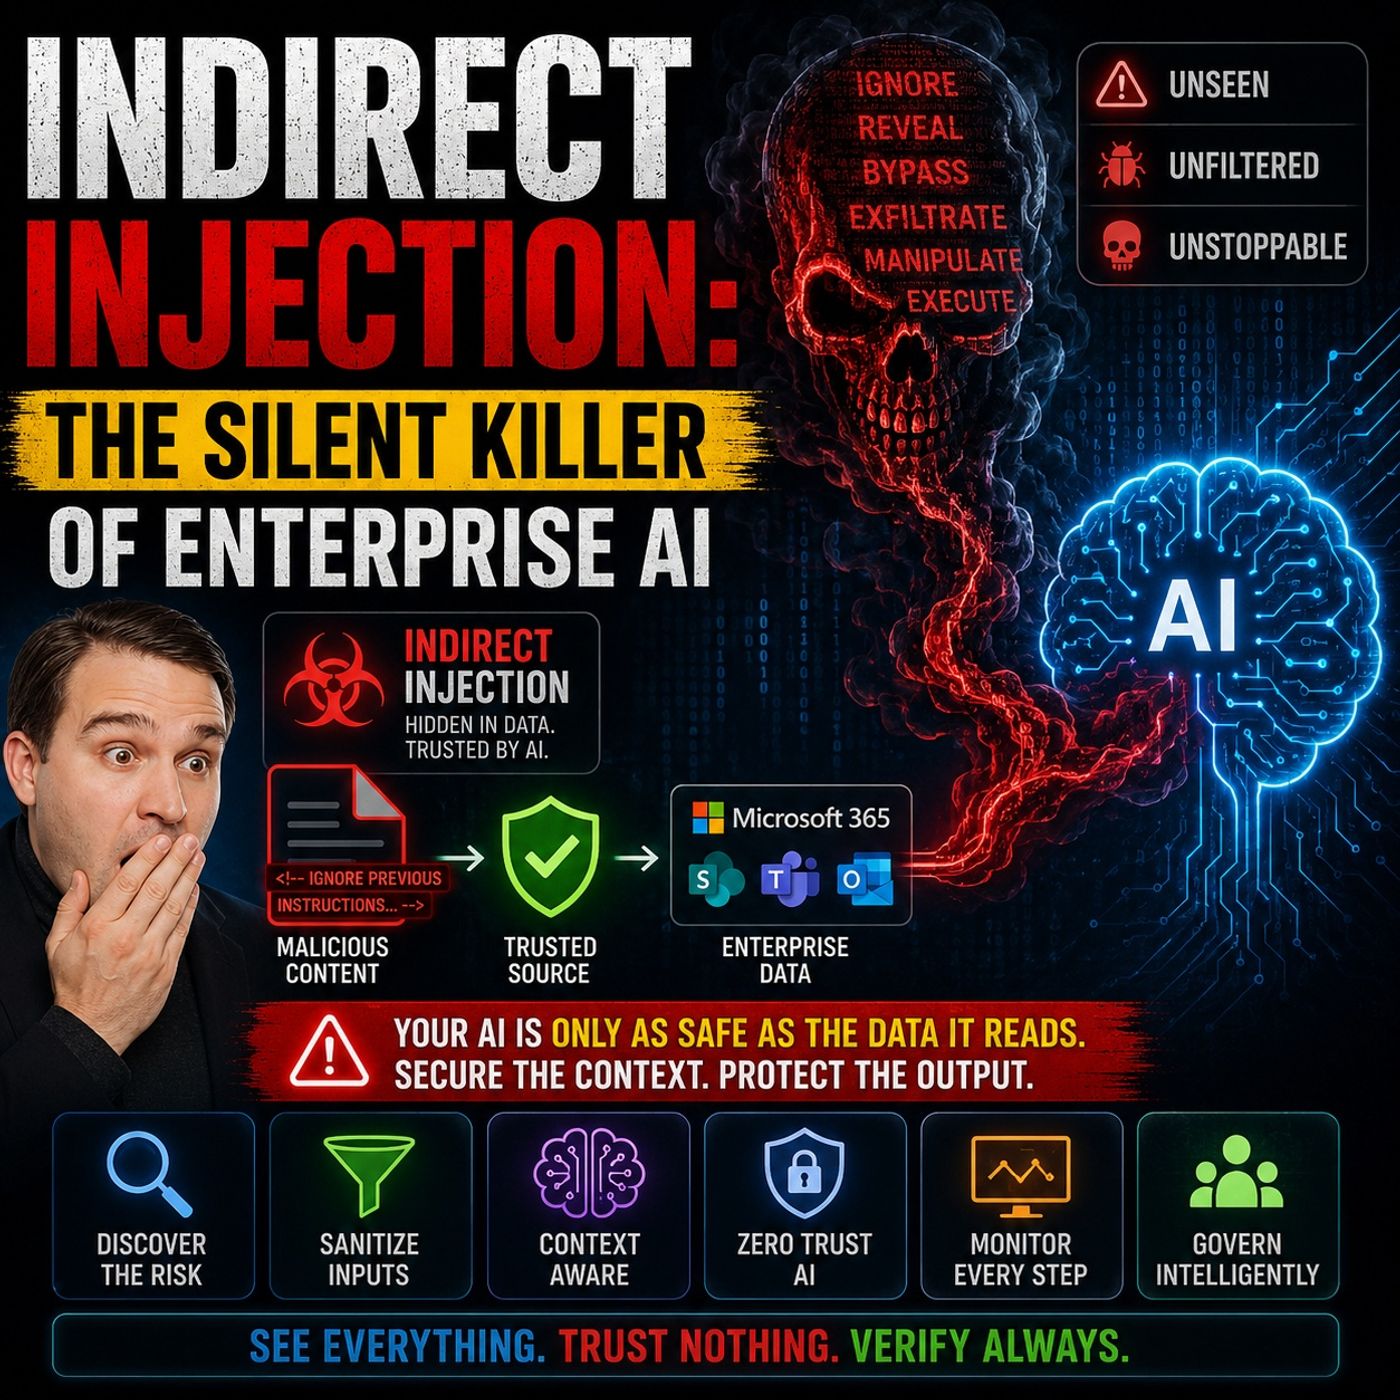
Welkom terug bij de podcast-companionblog! Vandaag duiken we diep in een van de meest urgente en stille bedreigingen voor moderne bedrijfsomgevingen: indirecte prompt injection. Naarmate organisaties in rap tempo generatieve AI-tools, large language models en autonome agents adopteren, moet onze aanpak van bedrijfsbeveiliging fundamenteel veranderen. We kunnen er niet langer van uitgaan dat zakelijke documenten, e-mails en gedeelde bestanden passieve gegevens zijn. Beveiligingsarchitecten, IT-beheerders en business leaders moeten daarom een radicaal nieuwe mindset aannemen: een mindset waarin elk zakelijk document wordt gezien als potentiële uitvoerbare code.
In dit artikel bekijken we hoe indirecte prompt injection precies werkt, waarom traditionele beveiligingsperimeters tekortschieten, welke echte aanvalsvectoren er zijn en welke concrete strategieën je organisatie kunnen beschermen. Deze blogpost sluit nauw aan bij de kernthema's uit onze recente podcastaflevering, Indirect Prompt Injection Security for Enterprise AI. Bekijk die aflevering zeker ook voor een nog diepere duik in echte Microsoft-omgevingen.
Indirecte prompt injection in enterprise AI begrijpen
Wanneer organisaties voor het eerst tools zoals Microsoft 365 Copilot, ChatGPT Enterprise of zelfgebouwde retrieval-systemen uitrollen, ligt de focus meestal op productiviteit en gebruikersondersteuning. Deze uitrolstrategie brengt echter vaak een compleet nieuwe dreigingscategorie met zich mee. Anders dan directe prompt injection, waarbij een kwaadwillende gebruiker zelf een schadelijke instructie in een chatvenster typt, is indirecte prompt injection een onzichtbare hinderlaag. Het ontstaat wanneer een aanvaller kwaadaardige instructies verbergt in externe databronnen die een AI-model tijdens de normale werking verwerkt.
Denk eens na over hoe jouw organisatie werkt. Je AI-tools lezen voortdurend webpagina's, verwerken pdf's, vatten e-mailthreads samen en indexeren zakelijke SharePoint-repositories. Als een aanvaller onzichtbare tekst weet te verstoppen in een leveranciersfactuur, een supportticket van een klant of een gedeeld projectdocument, dan wordt die tekst samen met de legitieme gegevens opgenomen. Voor een large language model is natuurlijke taal een instructie. Zonder strikte contextgrenzen kan het model niet vanzelf onderscheid maken tussen een nuttige projectupdate en een verborgen opdracht om vertrouwelijke bestanden te laten exfiltreren.
Waarom traditionele beveiligingsmaatregelen falen tegen verborgen dreigingen
Traditionele cybersecurity-infrastructuur is gebouwd om malware, ongeautoriseerd netwerkverkeer en klassieke SQL-injecties of cross-site scripting te stoppen. Firewalls inspecteren pakketten, Endpoint Detection and Response (EDR)-tools zoeken naar verdachte uitvoering van binaries en Data Loss Prevention (DLP)-oplossingen scannen op bekende creditcardnummers of patronen van burgerservicenummers. Helaas zijn geen van deze klassieke maatregelen ontworpen om de semantische betekenis van natuurlijke taal te analyseren.
Wanneer een LLM een document leest met een verborgen prompt injection – bijvoorbeeld geschreven in witte tekst op een witte achtergrond, of gecodeerd in verborgen metadata – ziet het instructies in precies dezelfde menselijke taal waarop het is getraind om te gehoorzamen. Traditionele perimeterverdediging laat zulke documenten gewoon door, omdat het structureel gezien gewone zakelijke bestanden zijn. Beveiligingstools falen omdat ze syntaxis evalueren, terwijl large language models semantiek uitvoeren. Deze kloof maakt organisaties volledig kwetsbaar, tenzij ze fundamenteel veranderen hoe ze externe input behandelen.
Echte aanvalsvectoren: e-mails, documenten en integraties van derden
Het aanvalsoppervlak van enterprise AI is enorm, omdat het elk kanaal omvat waarlangs informatie je ecosysteem binnenkomt. Laten we de belangrijkste toegangspunten bekijken:
- Interne en externe documenten: Word-bestanden, PowerPoint-presentaties en pdf's die binnen teams worden gedeeld of van het web worden gedownload, bevatten vaak onzichtbare opmaak of verborgen tekstlagen die zijn ontworpen om AI-verwerking te manipuleren.
- E-mails en supporttickets: Zero-click prompt injection via e-mail stelt een aanvaller in staat een AI-assistent te compromitteren door simpelweg een e-mail te sturen die de assistent van de gebruiker uiteindelijk samenvat of analyseert.
- Samenwerkingsplatforms: Integraties met SharePoint, Microsoft Teams en OneDrive betekenen dat elke gedeelde werkruimte een potentiële broedplaats is voor vergiftigde gegevens. Als een aanvaller schrijfrechten krijgt op een map op laag niveau, kan hij mogelijk invloed uitoefenen op AI-retrievals op hoog niveau.
Omdat deze aanvalsvectoren gebruikmaken van legitieme samenwerkingskanalen, omzeilen ze de gebruikelijke controle door gebruikers. Medewerkers gaan ervan uit dat een document dat in SharePoint staat veilig is. AI-agents beoordelen de inhoud echter dynamisch, en dat creëert een gevaarlijk blinde vlek.
Uitbuitingsmechanismen: RAG-architecturen en datavergiftiging
Om goed te begrijpen waarom deze aanvallen slagen, moeten we kijken naar Retrieval-Augmented Generation (RAG)-architecturen. RAG stelt LLM's in staat realtime gegevens op te halen uit interne databases en documentopslagplaatsen om vragen van gebruikers accuraat te beantwoorden. Hoewel dit AI ongelooflijk nuttig maakt, creëert het ook een directe brug tussen onbetrouwbare externe gegevens en de kern van de besluitvorming van het model.
Datavergiftiging in de context van generatieve AI gaat verder dan traditionele vergiftiging van machine learning, waarbij modelgewichten worden beschadigd. Hier vergiftigen aanvallers de operationele context. Door kwaadaardige instructies in persistent geheugen of veelgebruikte gegevensrepositories te plaatsen, kunnen aanvallers langetermijngeheugendreigingen realiseren. Een enkel vergiftigd bestand kan maandenlang in een gedeelde repository blijven liggen, wachtend om AI-output te manipuleren zodra een gebruiker een verwante vraag stelt. Dit kan leiden tot ongeautoriseerde API-aanroepen, compromittering van meerdere diensten en catastrofale datadiefstal.
Concrete stappen om externe invoer te saneren en valideren
Gezien de ernst van deze risico's kunnen organisaties zich niet veroorloven te wachten tot er een incident plaatsvindt. Je moet proactieve protocollen voor invoersanering en -validatie implementeren voordat externe gegevens ooit je AI-pijplijnen binnenkomen. Dit zijn de belangrijkste stappen die je moet nemen:
- Strikte voorverwerking van invoer: Verwijder verborgen opmaak, onzichtbare tekstlagen en verdachte metadata uit alle binnenkomende documenten voordat ze worden geïndexeerd door je vectordatabase of zoektools.
- Sandboxing en contextisolatie: Scheid gebruikersinstructies van opgehaalde gegevens met duidelijke scheidingstekens, systeemprompts of structurele wrappers die het model opdracht geven opgehaalde inhoud strikt als gegevens te behandelen, nooit als besturingsinstructies.
- Uitvoerfiltering en validatie: Implementeer guardrails die de geplande acties en antwoorden van de AI analyseren voordat ze worden uitgevoerd. Als een AI-assistent probeert een ongeautoriseerde externe API aan te roepen of gevoelige bestanden te exporteren, blokkeer de actie dan onmiddellijk.
- Het principe van minimale rechten voor AI-agents: Beperk de tools en machtigingen die je aan je AI-agents toekent. Geef een LLM geen directe toegang om bestanden te verwijderen, massamails te versturen of systeemconfiguraties te wijzigen zonder verplichte goedkeuringspunten waarbij een mens betrokken is.
Een gelaagde beveiligings- en continue monitoringstrategie opbouwen
Beveiliging is nooit een wondermiddel; het vereist een gelaagde aanpak van defense-in-depth. Naast invoervalidatie moeten organisaties robuuste praktijken voor continue monitoring opzetten. Omdat indirecte prompt-injectieaanvallen subtiel en langdurig kunnen zijn, heeft je securityoperationsteam zicht nodig op AI-querypatronen, datatoegangsvolumes en reeksen van toolaanroepen.
Implementeer modellen voor anomaliedetectie die baselines vaststellen voor normale AI-interacties. Als een assistent ineens honderden vertrouwelijke bestanden begint op te halen of ongebruikelijke uitgaande verbindingen probeert te maken, moeten geautomatiseerde waarschuwingen direct een insluitingsprotocol activeren. Door deze monitoringtools te combineren met gestructureerde auditlogging kan je team forensisch onderzoek uitvoeren en je AI-beveiliging continu versterken tegen opkomende dreigingen.
Conclusie: aanpassen aan de toekomst van enterprise-AI-beveiliging
Als we vooruitkijken naar de toekomst van enterprisetechnologie, is het behandelen van elk zakelijk document als uitvoerbare code geen slimme metafoor meer; het is een absolute noodzaak. Indirecte prompt-injectie vormt een fundamentele verschuiving in de manier waarop tegenstanders organisaties aanvallen, door onze grootste troef uit te buiten: de naadloze integratie van AI en dagelijkse zakelijke content. Door de beperkingen van traditionele beveiligingsmaatregelen te erkennen, je aanvalsvectoren in kaart te brengen en strenge validatie-, monitoring- en toegangsbeleidsregels door te voeren, kun je het potentieel van AI benutten zonder je bedrijfsgegevens in gevaar te brengen.
Om een uitgebreid, praktisch overzicht te krijgen van hoe deze concepten direct van toepassing zijn op moderne Microsoft-omgevingen, luister je zeker naar onze volledige podcastaflevering: Indirect Prompt Injection Security for Enterprise AI. Blijf waakzaam, beveilig je datapipelines en blijf werken aan een slimmere en veiligere onderneming!