 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Trattare ogni documento aziendale come codice eseguibile: un nuovo paradigma per la sicurezza dell'IA
By Mirko Peters ·
Bentornato sul blog di accompagnamento al podcast! Oggi approfondiamo una delle minacce più pressanti e silenziose per gli ambienti aziendali moderni: la prompt injection indiretta. Man mano che le organizzazioni adottano rapidamente strumenti di IA generativa, modelli linguistici di grandi dimensioni e agenti autonomi, il nostro approccio alla sicurezza aziendale deve cambiare radicalmente. Non p
Automatically translated with AI from the original post. Read the English original
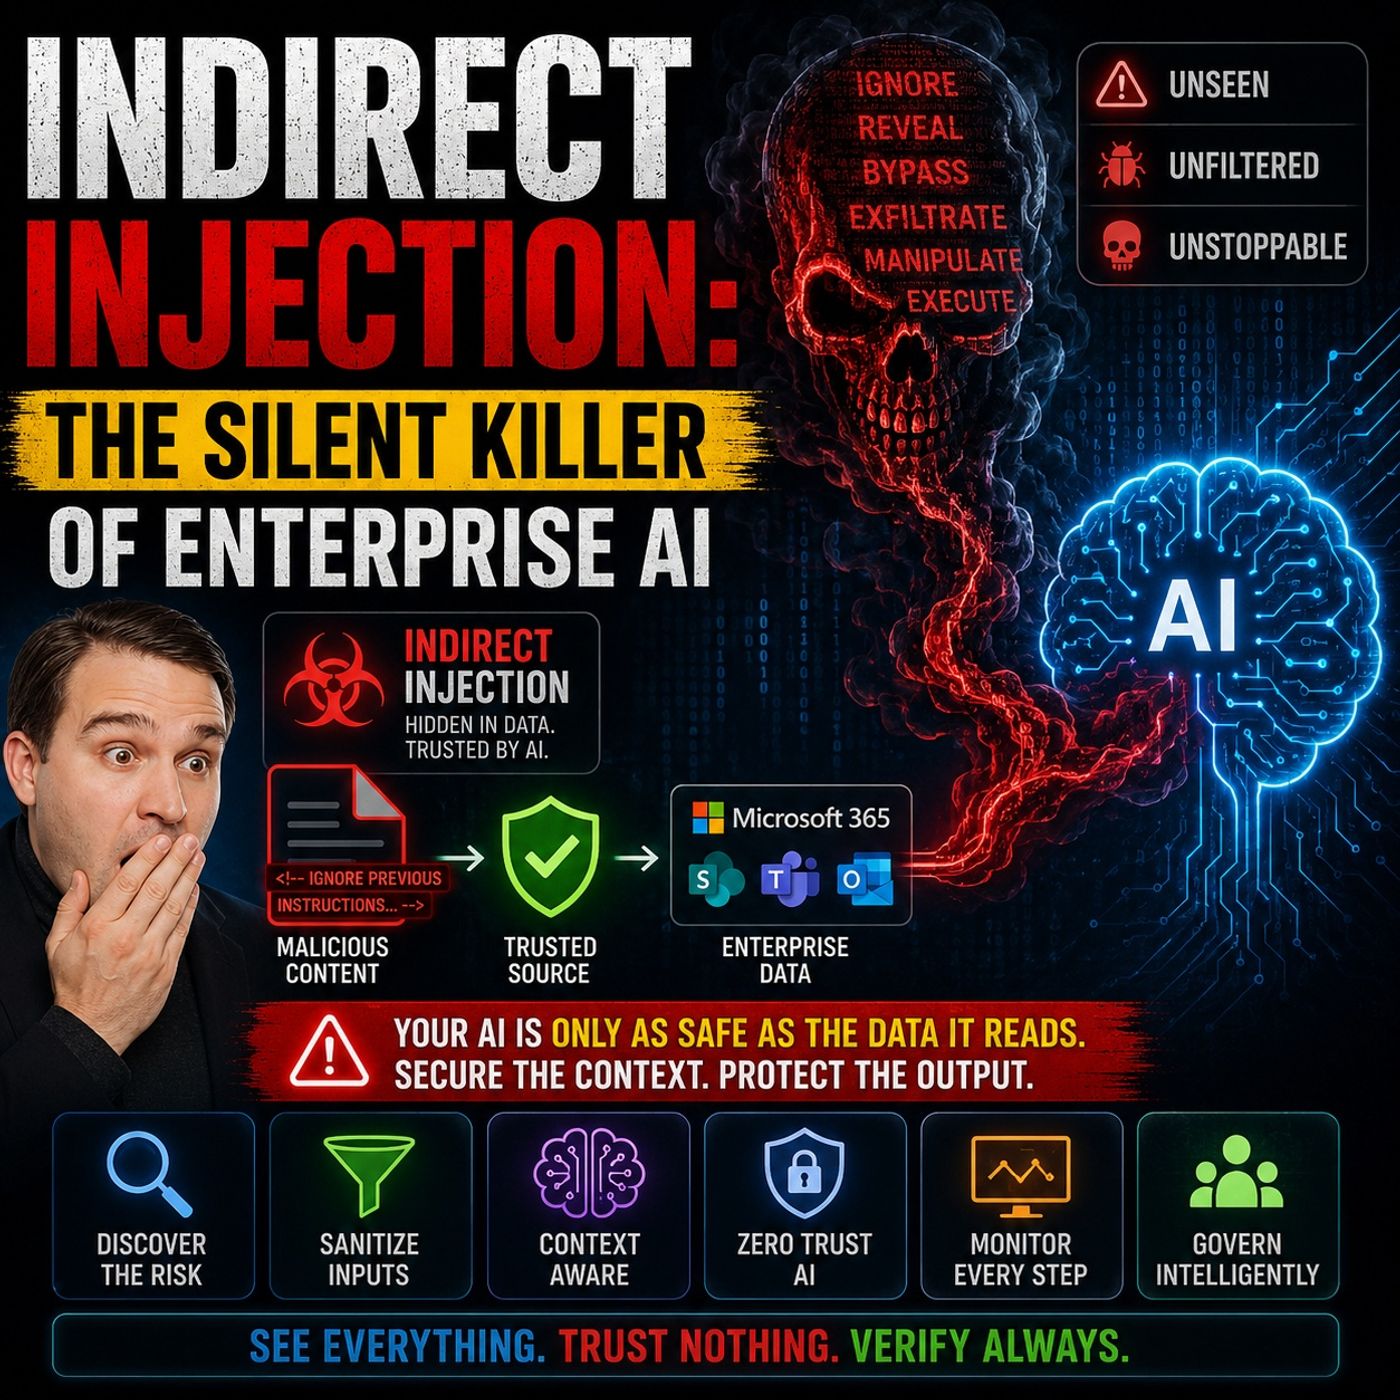
Bentornato sul blog di accompagnamento al podcast! Oggi approfondiamo una delle minacce più pressanti e silenziose per gli ambienti aziendali moderni: la prompt injection indiretta. Man mano che le organizzazioni adottano rapidamente strumenti di IA generativa, modelli linguistici di grandi dimensioni e agenti autonomi, il nostro approccio alla sicurezza aziendale deve cambiare radicalmente. Non possiamo più dare per scontato che documenti, email e file condivisi siano dati passivi. Architetti della sicurezza, amministratori IT e responsabili aziendali devono adottare una mentalità completamente nuova, che tratti ogni singolo documento aziendale come potenziale codice eseguibile.
In questo post esploreremo il funzionamento della prompt injection indiretta, analizzeremo perché i tradizionali perimetri di sicurezza stanno fallendo, osserveremo da vicino i vettori di attacco reali e delineeremo strategie concrete per proteggere la tua organizzazione. Questo discorso riprende da vicino i temi centrali del nostro recente episodio del podcast, Indirect Prompt Injection Security for Enterprise AI. Non perdere quell'episodio per un approfondimento ancora maggiore sugli ambienti Microsoft reali.
Comprendere la prompt injection indiretta nell'IA aziendale
Quando le organizzazioni implementano per la prima volta strumenti come Microsoft 365 Copilot, ChatGPT Enterprise o sistemi di retrieval sviluppati internamente, l'attenzione è di solito rivolta alla produttività e all'abilitazione degli utenti. Tuttavia, questa strategia di implementazione introduce spesso una categoria di minaccia completamente nuova. A differenza della prompt injection diretta, in cui un utente malintenzionato digita manualmente un'istruzione dannosa in una finestra di chat, la prompt injection indiretta è un'imboscata invisibile. Si verifica quando un aggressore nasconde istruzioni malevole all'interno di origini dati esterne che un modello di IA elabora durante le sue normali operazioni.
Pensa a come funziona la tua azienda. I tuoi strumenti di IA leggono continuamente pagine web, analizzano PDF, riassumono thread di email e indicizzano i repository SharePoint aziendali. Se un aggressore riesce a inserire testo nascosto in una fattura di un fornitore, in un ticket di assistenza clienti o in un documento di progetto condiviso, quel testo viene acquisito insieme ai dati legittimi. Per un modello linguistico di grandi dimensioni, il testo in linguaggio naturale è un'istruzione. Senza rigorosi limiti di contesto, il modello non riesce a distinguere per sua natura un aggiornamento utile sul progetto da un comando nascosto che gli chiede di esfiltrare file riservati.
Perché i controlli di sicurezza tradizionali non reggono contro le minacce nascoste
L'infrastruttura di cybersecurity tradizionale è stata progettata per fermare malware, traffico di rete non autorizzato e le classiche SQL injection o cross-site scripting. I firewall ispezionano i pacchetti, gli strumenti di Endpoint Detection and Response (EDR) cercano esecuzioni binarie sospette e le soluzioni di Data Loss Prevention (DLP) analizzano la presenza di numeri di carta di credito o schemi di codici fiscali noti. Purtroppo nessuno di questi controlli legacy è stato pensato per interpretare il significato semantico del linguaggio naturale.
Quando un LLM legge un documento contenente una prompt injection nascosta, magari scritta in testo bianco su sfondo bianco o codificata in metadati nascosti, vede istruzioni scritte nello stesso identico linguaggio umano che è stato addestrato a obbedire. Le difese perimetrali tradizionali lasciano passare questi documenti perché, strutturalmente, sono normali file aziendali. Gli strumenti di sicurezza falliscono perché valutano la sintassi, mentre i modelli linguistici di grandi dimensioni eseguono la semantica. Questo divario lascia le organizzazioni completamente esposte, a meno che non cambino radicalmente il modo in cui gestiscono gli input esterni.
Vettori reali: email, documenti e integrazioni di terze parti
La superficie di attacco dell'IA aziendale è vastissima, perché comprende ogni canale attraverso cui le informazioni entrano nel tuo ecosistema. Vediamo i principali punti di ingresso:
- Documenti interni ed esterni: i file Word, le presentazioni PowerPoint e i PDF condivisi tra i team o scaricati dal web contengono spesso formattazione invisibile o livelli di testo nascosti progettati per manipolare l'elaborazione dell'IA.
- Email e ticket di assistenza: la prompt injection zero-click tramite email consente a un aggressore di compromettere un assistente IA semplicemente inviando un'email che l'assistente dell'utente finirà per riassumere o analizzare.
- Piattaforme collaborative: le integrazioni con SharePoint, Microsoft Teams e OneDrive fanno sì che qualsiasi area di lavoro condivisa possa diventare un possibile punto di appoggio per dati avvelenati. Se un attaccante ottiene l'accesso in scrittura a una cartella di basso livello, potrebbe riuscire a influenzare i recuperi di informazioni ad alto livello effettuati dall'AI.
Poiché questi vettori sfruttano canali di collaborazione legittimi, aggirano il normale controllo da parte degli utenti. I dipendenti presumono che, se un documento si trova in SharePoint, sia sicuro. Gli agenti AI, invece, valutano il contenuto in modo dinamico, e questo crea un pericoloso punto cieco.
Meccanismi di sfruttamento: architetture RAG e avvelenamento dei dati
Per capire davvero perché questi attacchi riescono, bisogna guardare alle architetture di Retrieval-Augmented Generation (RAG). La RAG consente agli LLM di recuperare dati in tempo reale da database interni e archivi documentali per rispondere con precisione alle richieste degli utenti. Se da un lato questo rende l'AI estremamente utile, dall'altro crea un collegamento diretto tra dati esterni non attendibili e il cuore delle decisioni del modello.
L'avvelenamento dei dati nel contesto dell'AI generativa va oltre il tradizionale data poisoning del machine learning, in cui vengono corrotti i pesi del modello. Qui gli attaccanti avvelenano il contesto operativo. Inserendo istruzioni malevole nella memoria persistente o in repository di dati consultati di frequente, possono generare minacce alla memoria a lungo termine. Un singolo file avvelenato può restare in un repository condiviso per mesi, in attesa di manipolare le risposte dell'AI nel momento in cui un utente pone una domanda correlata. Questo può portare a chiamate API non autorizzate, compromissioni tra servizi e un'esfiltrazione catastrofica di dati.
Passaggi concreti per sanificare e validare gli input esterni
Data la gravità di questi rischi, le organizzazioni non possono permettersi di aspettare che si verifichi un incidente. Devi implementare protocolli proattivi di sanificazione e validazione degli input prima che i dati esterni raggiungano le pipeline AI aziendali. Ecco i passaggi essenziali da seguire:
- Pre-elaborazione rigorosa degli input: rimuovi formattazioni nascoste, livelli di testo invisibili e metadati sospetti da tutti i documenti in ingresso, prima che vengano indicizzati dal database vettoriale o dagli strumenti di ricerca.
- Sandboxing e isolamento del contesto: separa le istruzioni dell'utente dai dati recuperati usando delimitatori chiari, prompt di sistema o wrapper strutturali che istruiscano il modello a trattare i contenuti recuperati esclusivamente come dati, mai come istruzioni di controllo.
- Filtraggio e validazione dell'output: implementa guardrail che analizzino le azioni e le risposte pianificate dall'AI prima che vengano eseguite. Se un assistente AI tenta di chiamare un'API esterna non autorizzata o di esportare file sensibili, blocca immediatamente l'azione.
- Principio del privilegio minimo per gli agenti AI: limita gli strumenti e le autorizzazioni concesse ai tuoi agenti AI. Non dare a un LLM accesso diretto per eliminare file, inviare email di massa o modificare le configurazioni di sistema senza approvazioni obbligatorie con intervento umano (human-in-the-loop).
Costruire una strategia di sicurezza a più livelli e di monitoraggio continuo
La sicurezza non è mai una soluzione miracolosa; richiede un approccio di difesa in profondità a più livelli. Insieme alla validazione degli input, le organizzazioni devono adottare pratiche di monitoraggio continuo solide. Poiché gli attacchi di prompt injection indiretta possono essere sottili e duraturi, il tuo team di operations di sicurezza ha bisogno di visibilità sui pattern delle query AI, sui volumi di accesso ai dati e sulle sequenze di invocazione degli strumenti.
Implementa modelli di rilevamento delle anomalie che stabiliscano una baseline delle interazioni AI normali. Se un assistente inizia improvvisamente a recuperare centinaia di file riservati o a tentare connessioni in uscita insolite, gli avvisi automatici dovrebbero attivare immediatamente un protocollo di contenimento. Abbinare questi strumenti di monitoraggio a un audit logging strutturato garantisce che il tuo team possa eseguire analisi forensi e rafforzare continuamente la postura di sicurezza dell'AI contro le minacce emergenti.
Conclusione: adattarsi al futuro della sicurezza AI aziendale
Guardando al futuro della tecnologia aziendale, trattare ogni documento aziendale come codice eseguibile non è più solo una metafora brillante: è una necessità assoluta. La prompt injection indiretta rappresenta un cambiamento fondamentale nel modo in cui gli avversari prendono di mira le organizzazioni, sfruttando il nostro bene più prezioso: l'integrazione senza soluzione di continuità tra AI e contenuti aziendali di tutti i giorni. Riconoscendo i limiti dei controlli di sicurezza tradizionali, mappando i vettori di attacco e implementando una validazione rigorosa, un monitoraggio e criteri di accesso solidi, puoi sfruttare la potenza dell'AI senza compromettere i dati aziendali.
Per una panoramica completa e pratica su come questi concetti si applicano agli ambienti Microsoft moderni, ascolta l'episodio completo del nostro podcast: Indirect Prompt Injection Security for Enterprise AI. Resta vigile, proteggi le tue pipeline di dati e continua a costruire un'azienda più intelligente e più sicura!