 PT
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Tratar todo documento corporativo como código executável: um novo paradigma para a segurança de IA
By Mirko Peters ·
Bem-vindo de volta ao blog complementar do podcast! Hoje, vamos mergulhar fundo em uma das ameaças mais urgentes e silenciosas que os ambientes corporativos modernos enfrentam: a injeção indireta de prompt. À medida que as organizações adotam rapidamente ferramentas de IA generativa, grandes modelos de linguagem e agentes autônomos, nossa abordagem à segurança corporativa precisa passar por uma mu
Automatically translated with AI from the original post. Read the English original
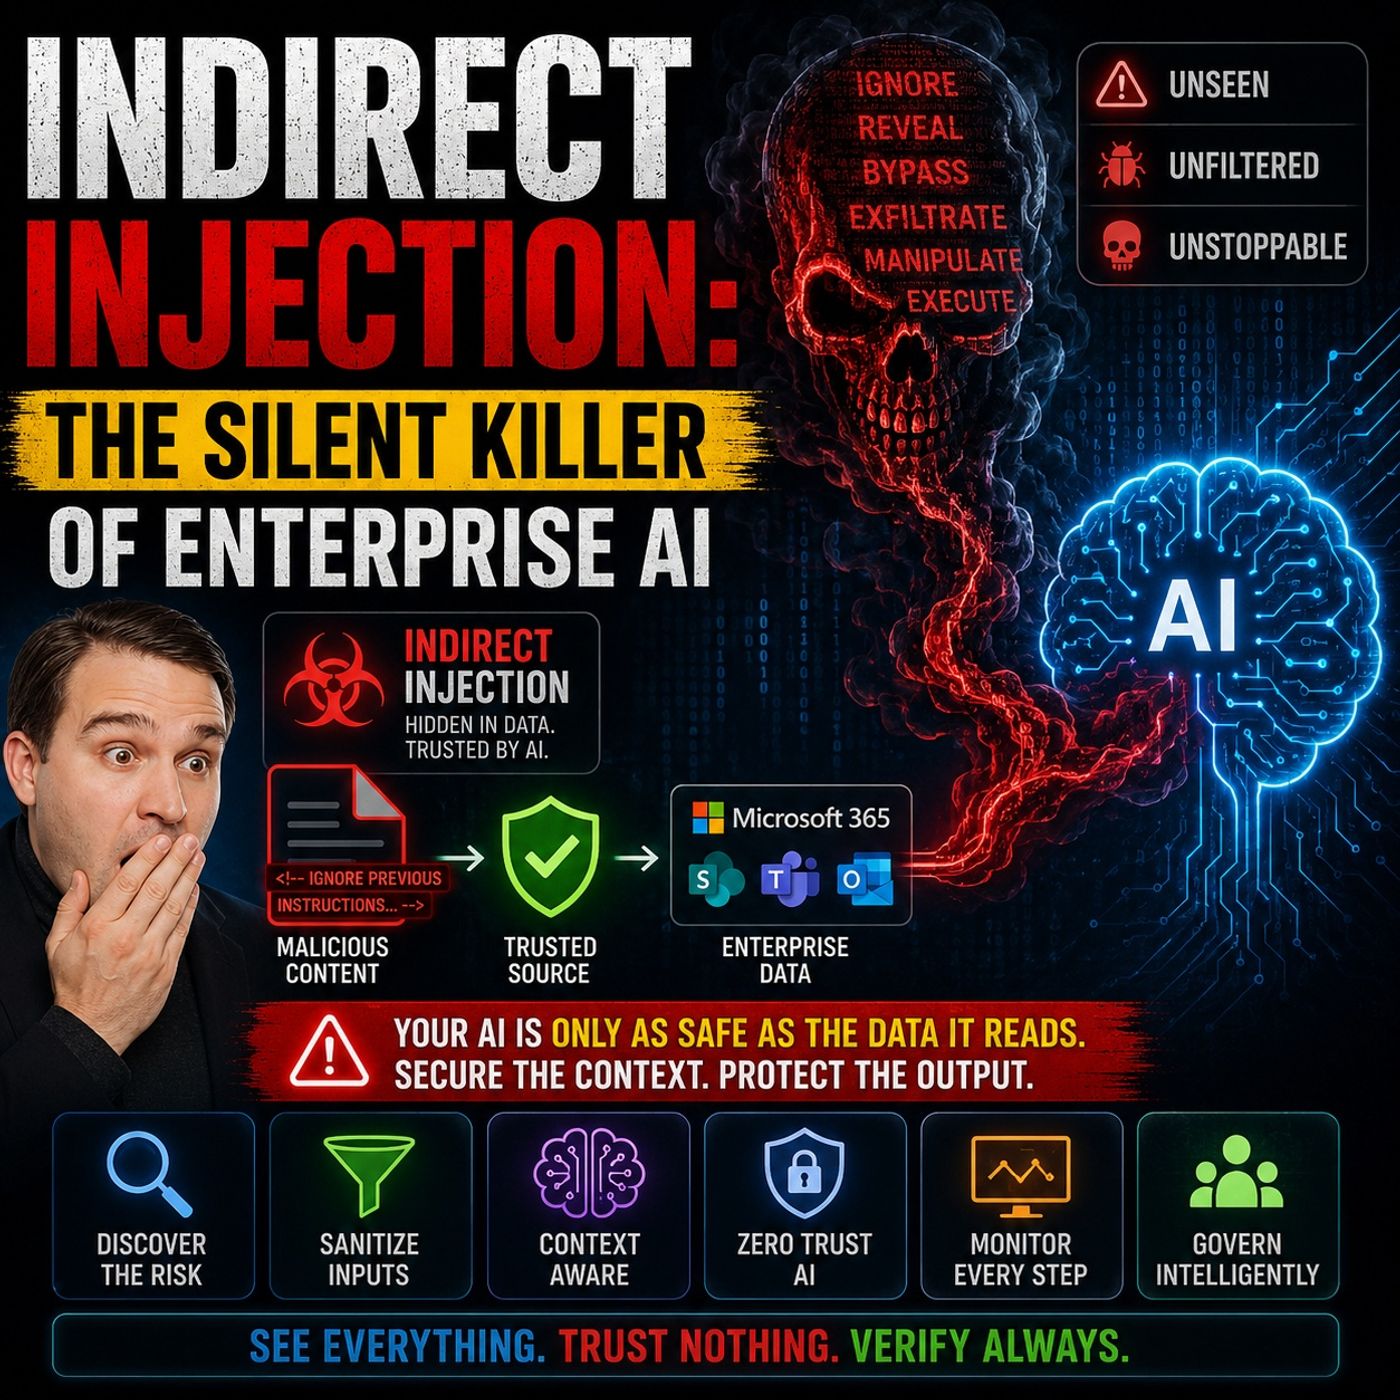
Bem-vindo de volta ao blog complementar do podcast! Hoje, vamos mergulhar fundo em uma das ameaças mais urgentes e silenciosas que os ambientes corporativos modernos enfrentam: a injeção indireta de prompt. À medida que as organizações adotam rapidamente ferramentas de IA generativa, grandes modelos de linguagem e agentes autônomos, nossa abordagem à segurança corporativa precisa passar por uma mudança fundamental. Não podemos mais presumir que documentos de negócios, e-mails e arquivos compartilhados são dados passivos. Em vez disso, arquitetos de segurança, administradores de TI e líderes de negócios precisam adotar uma mentalidade radicalmente nova: aquela que trata cada documento corporativo como um possível código executável.
Neste post, vamos explorar a mecânica da injeção indireta de prompt, examinar por que os perímetros de segurança tradicionais estão falhando, analisar de perto vetores de ataque do mundo real e descrever estratégias práticas para proteger sua organização. Esta discussão acompanha de perto os temas centrais do nosso episódio recente do podcast, Indirect Prompt Injection Security for Enterprise AI. Não deixe de conferir o episódio para um mergulho ainda mais profundo em ambientes reais do Microsoft 365.
Entendendo a injeção indireta de prompt em IA corporativa
Quando as organizações implantam pela primeira vez ferramentas como o Microsoft 365 Copilot, o ChatGPT Enterprise ou sistemas de recuperação desenvolvidos internamente, o foco costuma estar em produtividade e capacitação dos usuários. No entanto, essa estratégia de implantação frequentemente introduz uma categoria de ameaça totalmente nova. Diferentemente da injeção direta de prompt, em que um usuário mal-intencionado digita manualmente uma instrução nociva em uma janela de chat, a injeção indireta de prompt é uma emboscada invisível. Ela ocorre quando um atacante oculta instruções maliciosas dentro de fontes de dados externas que um modelo de IA processa durante sua operação normal.
Pense em como sua empresa funciona. Suas ferramentas de IA leem páginas da web, analisam PDFs, resumem threads de e-mail e indexam repositórios corporativos do SharePoint o tempo todo. Se um atacante conseguir inserir um texto oculto em uma fatura de fornecedor, em um chamado de suporte ao cliente ou em um documento de projeto compartilhado, esse texto será ingerido junto com os dados legítimos. Para um grande modelo de linguagem, texto em linguagem natural é instrução. Sem limites de contexto rigorosos, o modelo não consegue distinguir, por si só, uma atualização útil de projeto de um comando oculto que o instrui a exfiltrar arquivos confidenciais.
Por que os controles de segurança tradicionais falham diante de ameaças ocultas
A infraestrutura de cibersegurança tradicional foi criada para bloquear malware, tráfego de rede não autorizado e injeções de SQL ou cross-site scripting tradicionais. Firewalls inspecionam pacotes, ferramentas de Endpoint Detection and Response (EDR) procuram execuções binárias suspeitas, e soluções de Data Loss Prevention (DLP) verificam padrões conhecidos de números de cartão de crédito ou de documentos de identificação. Infelizmente, nenhum desses controles legados foi projetado para interpretar o significado semântico da linguagem natural.
Quando um LLM lê um documento que contém uma injeção de prompt oculta, seja escrita em texto branco sobre fundo branco, seja codificada em metadados ocultos, ele enxerga instruções escritas exatamente na linguagem humana que foi treinado para obedecer. As defesas tradicionais de perímetro deixam esses documentos passar porque, estruturalmente, são apenas arquivos comerciais comuns. As ferramentas de segurança falham porque avaliam a sintaxe, enquanto os grandes modelos de linguagem executam a semântica. Essa lacuna deixa as organizações completamente expostas, a menos que mudem fundamentalmente a forma como tratam as entradas externas.
Vetores do mundo real: e-mails, documentos e integrações de terceiros
A superfície de ataque da IA corporativa é enorme, pois abrange todos os canais por meio dos quais informações entram no seu ecossistema. Vejamos os principais pontos de entrada:
- Documentos internos e externos: Arquivos do Word, apresentações do PowerPoint e PDFs compartilhados entre equipes ou baixados da web frequentemente contêm formatação invisível ou camadas de texto oculto projetadas para manipular o processamento de IA.
- E-mails e chamados de suporte: A injeção de prompt sem clique (zero-click) por e-mail permite que um atacante comprometa um assistente de IA apenas enviando um e-mail que o assistente do usuário acabe resumindo ou analisando.
- Plataformas colaborativas: As integrações com SharePoint, Microsoft Teams e OneDrive significam que qualquer espaço de trabalho compartilhado é um possível ponto de preparação para dados envenenados. Se um invasor obtiver acesso de gravação a uma pasta de baixo nível, ele pode, potencialmente, influenciar as recuperações de alto nível feitas pela IA.
Como esses vetores aproveitam canais de colaboração legítimos, eles escapam do escrutínio habitual dos usuários. Os funcionários presumem que, se um documento está no SharePoint, ele é seguro. Já os agentes de IA avaliam o conteúdo dinamicamente, o que cria um ponto cego perigoso.
Mecanismos de exploração: arquiteturas RAG e envenenamento de dados
Para entender de verdade por que esses ataques funcionam, precisamos olhar para as arquiteturas de Geração Aumentada por Recuperação (RAG, na sigla em inglês). O RAG permite que os LLMs busquem dados em tempo real em bancos de dados internos e repositórios de documentos para responder com precisão às consultas dos usuários. Embora isso torne a IA extremamente útil, também cria uma ponte direta entre dados externos não confiáveis e o núcleo de tomada de decisões do modelo.
O envenenamento de dados no contexto da IA generativa vai além do envenenamento tradicional de machine learning, em que os pesos do modelo são corrompidos. Aqui, os invasores envenenam o contexto operacional. Ao plantar instruções maliciosas na memória persistente ou em repositórios de dados acessados com frequência, os atacantes podem produzir ameaças de memória de longo prazo. Um único arquivo envenenado pode permanecer em um repositório compartilhado por meses, aguardando para manipular as saídas da IA no momento em que um usuário fizer uma pergunta relacionada. Isso pode levar a chamadas de API não autorizadas, comprometimento entre serviços e exfiltração catastrófica de dados.
Etapas práticas para higienizar e validar entradas externas
Dada a gravidade desses riscos, as organizações não podem se dar ao luxo de esperar que um incidente aconteça. Você precisa implementar protocolos proativos de sanitização e validação de entradas antes que os dados externos cheguem aos seus pipelines corporativos de IA. Estas são as etapas essenciais que você deve adotar:
- Pré-processamento rigoroso de entradas: Remova formatações ocultas, camadas de texto invisíveis e metadados suspeitos de todos os documentos recebidos antes que sejam indexados pelo seu banco de dados vetorial ou pelas ferramentas de busca.
- Sandboxing e isolamento de contexto: Separe as instruções do usuário dos dados recuperados usando delimitadores claros, prompts de sistema ou invólucros estruturais que orientem o modelo a tratar o conteúdo recuperado estritamente como dados, nunca como instruções de controle.
- Filtragem e validação de saídas: Implemente barreiras de proteção (guardrails) que analisem as ações e respostas planejadas pela IA antes de serem executadas. Se um assistente de IA tentar chamar uma API externa não autorizada ou exportar arquivos sensíveis, bloqueie a ação imediatamente.
- Princípio do menor privilégio para agentes de IA: Limite as ferramentas e as permissões concedidas aos seus agentes de IA. Não dê a um LLM acesso direto para excluir arquivos, enviar e-mails em massa ou modificar configurações do sistema sem pontos de aprovação obrigatória com intervenção humana.
Construindo uma estratégia de segurança em camadas e monitoramento contínuo
A segurança nunca é uma solução milagrosa; ela exige uma abordagem de defesa em profundidade, em camadas. Além da validação de entradas, as organizações precisam estabelecer práticas robustas de monitoramento contínuo. Como os ataques de injeção indireta de prompt podem ser sutis e duradouros, sua equipe de operações de segurança precisa de visibilidade sobre os padrões de consulta à IA, os volumes de acesso a dados e as sequências de invocação de ferramentas.
Implante modelos de detecção de anomalias que estabeleçam linhas de base para interações normais com a IA. Se um assistente começar de repente a recuperar centenas de arquivos confidenciais ou a tentar conexões de saída incomuns, alertas automatizados devem disparar um protocolo de contenção imediato. Combinar essas ferramentas de monitoramento com registros de auditoria estruturados garante que sua equipe consiga realizar análises forenses e fortalecer continuamente a postura de segurança da sua IA contra ameaças emergentes.
Conclusão: adaptando-se ao futuro da segurança de IA corporativa
Ao olharmos para o futuro da tecnologia corporativa, tratar cada documento de negócio como código executável deixou de ser apenas uma metáfora inteligente e passou a ser uma necessidade absoluta. A injeção indireta de prompt representa uma mudança fundamental na forma como os adversários miram as organizações, explorando nosso maior ativo: a integração perfeita entre IA e o conteúdo cotidiano do negócio. Ao reconhecer as limitações dos controles de segurança tradicionais, mapear seus vetores de ataque e implementar validação, monitoramento e políticas de acesso rigorosos, você pode aproveitar o poder da IA sem comprometer os dados da sua empresa.
Para obter uma análise abrangente e prática de como esses conceitos se aplicam diretamente aos ambientes modernos da Microsoft, não deixe de ouvir o episódio completo do nosso podcast: Indirect Prompt Injection Security for Enterprise AI. Mantenha-se vigilante, proteja seus pipelines de dados e continue construindo uma empresa mais inteligente e mais segura!