 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Tratar cada documento de negocio como código ejecutable: un nuevo paradigma para la seguridad de la IA
By Mirko Peters ·
¡Bienvenido de nuevo al blog complementario del podcast! Hoy vamos a profundizar en una de las amenazas más urgentes y silenciosas que enfrentan los entornos empresariales modernos: la inyección indirecta de prompts. A medida que las organizaciones adoptan rápidamente herramientas de IA generativa, modelos de lenguaje de gran tamaño y agentes autónomos, nuestro enfoque de seguridad empresarial deb
Automatically translated with AI from the original post. Read the English original
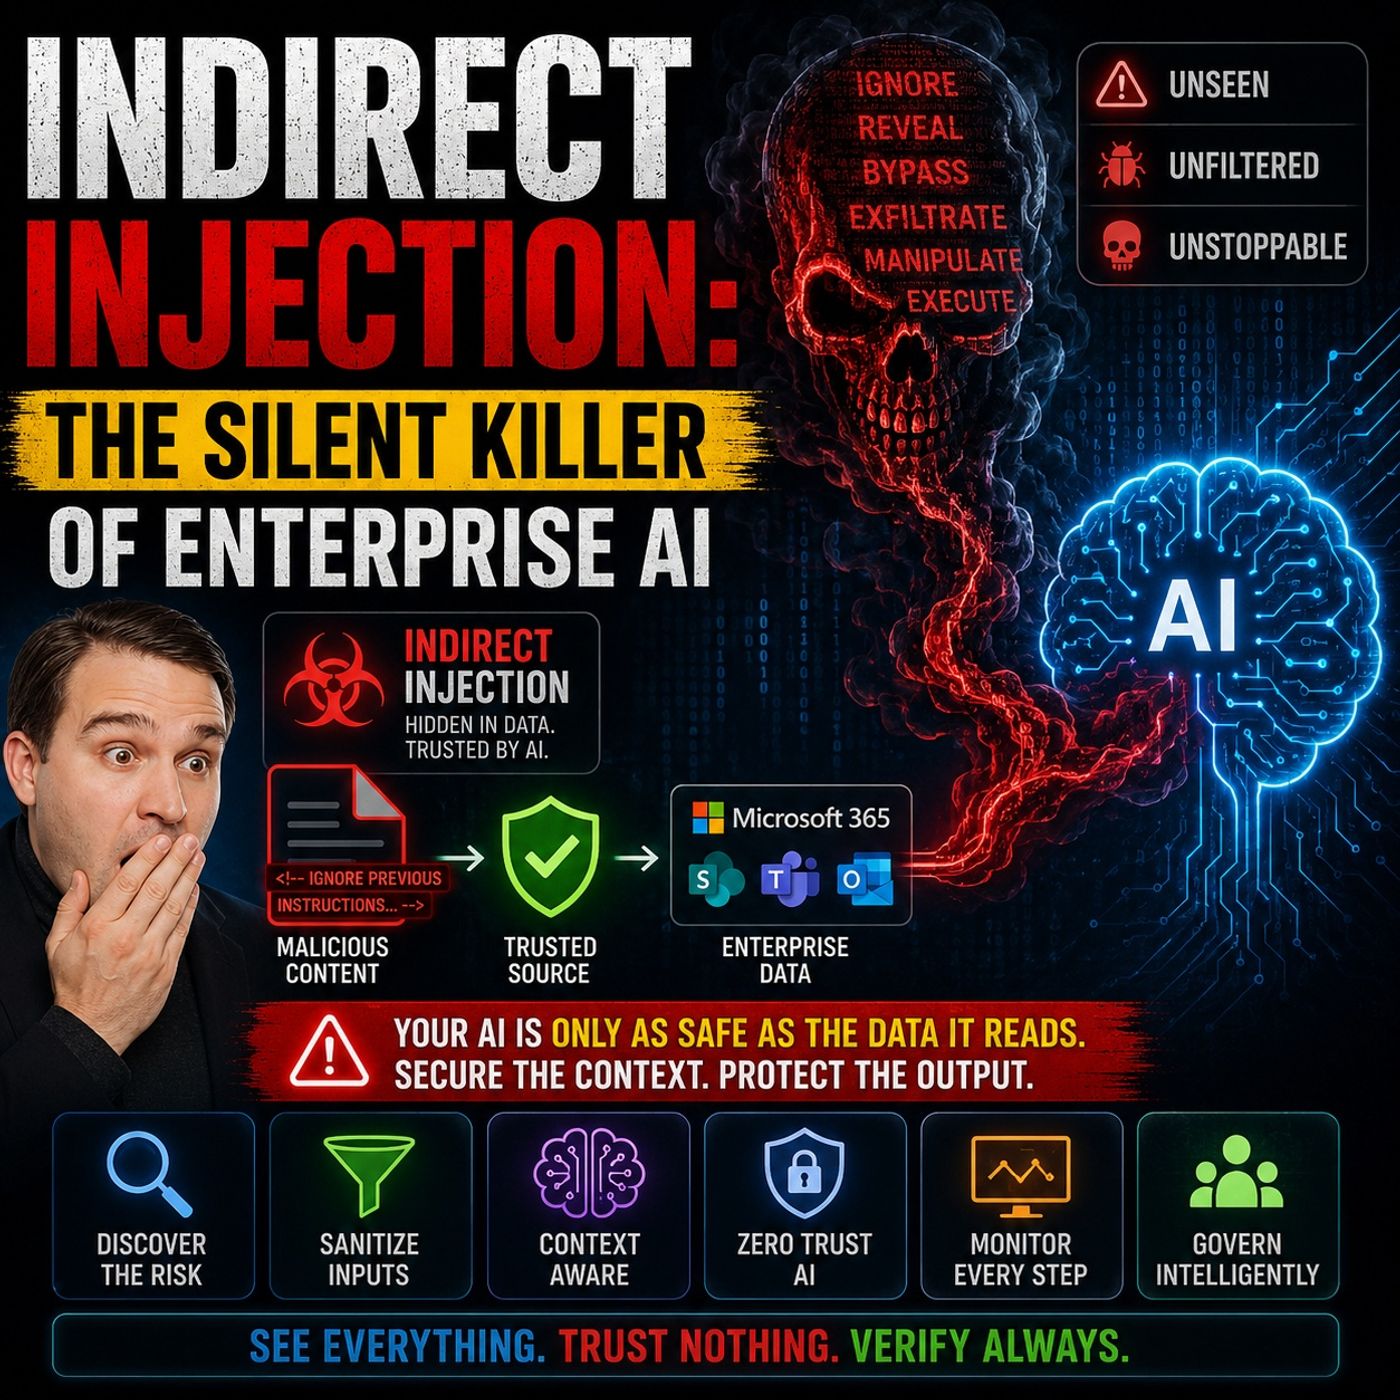
¡Bienvenido de nuevo al blog complementario del podcast! Hoy vamos a profundizar en una de las amenazas más urgentes y silenciosas que enfrentan los entornos empresariales modernos: la inyección indirecta de prompts. A medida que las organizaciones adoptan rápidamente herramientas de IA generativa, modelos de lenguaje de gran tamaño y agentes autónomos, nuestro enfoque de seguridad empresarial debe experimentar un cambio fundamental. Ya no podemos dar por sentado que los documentos de negocio, los correos electrónicos y los archivos compartidos son datos pasivos. Los arquitectos de seguridad, los administradores de TI y los responsables de negocio deben adoptar una mentalidad radicalmente nueva: una que trate cada documento de negocio como un posible código ejecutable.
En esta entrada repasaremos la mecánica de la inyección indirecta de prompts, analizaremos por qué fallan los perímetros de seguridad tradicionales, examinaremos vectores de ataque reales y expondremos estrategias prácticas para proteger tu organización. Este debate se alinea estrechamente con los temas principales que tratamos en nuestro episodio reciente del podcast, Indirect Prompt Injection Security for Enterprise AI. No dejes de escuchar ese episodio para profundizar aún más en entornos reales de Microsoft.
Comprender la inyección indirecta de prompts en la IA empresarial
Cuando las organizaciones implementan por primera vez herramientas como Microsoft 365 Copilot, ChatGPT Enterprise o sistemas de recuperación desarrollados a medida, el foco suele estar en la productividad y en la capacitación de los usuarios. Sin embargo, esta estrategia de despliegue suele introducir una categoría de amenaza completamente nueva. A diferencia de la inyección directa de prompts, en la que un usuario malintencionado escribe manualmente una instrucción dañina en una ventana de chat, la inyección indirecta de prompts es una emboscada invisible. Se produce cuando un atacante oculta instrucciones maliciosas dentro de fuentes de datos externas que un modelo de IA procesa durante su funcionamiento normal.
Piensa en cómo funciona tu empresa. Tus herramientas de IA leen constantemente páginas web, analizan archivos PDF, resumen hilos de correo y indexan repositorios corporativos de SharePoint. Si un atacante logra insertar texto oculto en una factura de proveedor, en un ticket de soporte al cliente o en un documento de proyecto compartido, ese texto se ingiere junto con los datos legítimos. Para un modelo de lenguaje de gran tamaño, el texto en lenguaje natural es instrucción. Sin límites de contexto rigurosos, el modelo no puede distinguir por sí mismo entre una actualización útil de un proyecto y una orden oculta que le indique exfiltrar archivos confidenciales.
Por qué los controles de seguridad tradicionales fallan frente a amenazas ocultas
La infraestructura de ciberseguridad tradicional se diseñó para detener malware, tráfico de red no autorizado y las inyecciones SQL o los ataques de scripting entre sitios clásicos. Los cortafuegos inspeccionan paquetes, las herramientas de detección y respuesta en endpoints (EDR) buscan ejecuciones binarias sospechosas y las soluciones de prevención de pérdida de datos (DLP) analizan la presencia de números de tarjetas de crédito o patrones de números de seguridad social conocidos. Por desgracia, ninguno de estos controles heredados se diseñó para interpretar el significado semántico del lenguaje natural.
Cuando un LLM lee un documento que contiene una inyección de prompt oculta, quizá escrita en texto blanco sobre fondo blanco o codificada en metadatos ocultos, ve instrucciones escritas en el mismo lenguaje humano que fue entrenado para obedecer. Las defensas perimetrales tradicionales dejan pasar estos documentos porque, estructuralmente, son simples archivos de negocio normales. Las herramientas de seguridad fallan porque evalúan la sintaxis, mientras que los modelos de lenguaje de gran tamaño ejecutan la semántica. Esta brecha deja a las organizaciones completamente expuestas a menos que cambien a fondo la forma en que gestionan las entradas externas.
Vectores reales: correos electrónicos, documentos e integraciones de terceros
La superficie de ataque de la IA empresarial es enorme, porque abarca cada canal por el que la información entra en tu ecosistema. Veamos los principales puntos de entrada:
- Documentos internos y externos: los archivos de Word, las presentaciones de PowerPoint y los PDF compartidos entre equipos o descargados de la web suelen contener formato invisible o capas de texto ocultas diseñadas para manipular el procesamiento de la IA.
- Correos electrónicos y tickets de soporte: la inyección de prompts sin clic (zero-click) a través del correo electrónico permite comprometer un asistente de IA simplemente enviando un mensaje que el asistente del usuario acaba resumiendo o analizando.
- Plataformas colaborativas: Las integraciones con SharePoint, Microsoft Teams y OneDrive hacen que cualquier espacio de trabajo compartido sea un posible punto de entrada para datos envenenados. Si un atacante obtiene acceso de escritura a una carpeta de bajo nivel, puede llegar a influir en las recuperaciones de IA de alto nivel.
Como estos vectores aprovechan canales de colaboración legítimos, eluden el escrutinio habitual de los usuarios. Los empleados dan por hecho que, si un documento está en SharePoint, es seguro. Sin embargo, los agentes de IA evalúan el contenido de forma dinámica, lo que crea un punto ciego peligroso.
Mecanismos de explotación: arquitecturas RAG y envenenamiento de datos
Para entender de verdad por qué tienen éxito estos ataques, hay que fijarse en las arquitecturas de generación aumentada por recuperación (RAG). RAG permite a los LLM extraer datos en tiempo real de bases de datos internas y repositorios de documentos para responder con precisión a las consultas de los usuarios. Aunque esto hace que la IA sea increíblemente útil, también crea un puente directo entre datos externos no confiables y el núcleo de decisión del modelo.
El envenenamiento de datos en el contexto de la IA generativa va más allá del envenenamiento tradicional del aprendizaje automático, en el que se corrompen los pesos del modelo. Aquí, los atacantes envenenan el contexto operativo. Al plantar instrucciones maliciosas en la memoria persistente o en repositorios de datos de uso frecuente, pueden provocar amenazas de memoria a largo plazo. Un solo archivo envenenado puede permanecer en un repositorio compartido durante meses, esperando para manipular los resultados de la IA en el momento en que un usuario haga una pregunta relacionada. Esto puede derivar en llamadas a API no autorizadas, compromisos entre servicios y una exfiltración catastrófica de datos.
Pasos prácticos para sanear y validar las entradas externas
Dada la gravedad de estos riesgos, las organizaciones no pueden permitirse esperar a que se produzca un incidente. Debes implementar protocolos proactivos de saneamiento y validación de entradas antes de que los datos externos lleguen a tus canalizaciones de IA empresariales. Estos son los pasos críticos que deberías seguir:
- Preprocesamiento estricto de entradas: Elimina el formato oculto, las capas de texto invisibles y los metadatos sospechosos de todos los documentos entrantes antes de que se indexen en tu base de datos vectorial o en tus herramientas de búsqueda.
- Aislamiento de contexto y sandboxing: Separa las instrucciones del usuario de los datos recuperados mediante delimitadores claros, prompts del sistema o envoltorios estructurales que indiquen al modelo que trate el contenido recuperado estrictamente como datos, nunca como instrucciones de control.
- Filtrado y validación de salidas: Implementa salvaguardas que analicen las acciones y respuestas previstas de la IA antes de ejecutarlas. Si un asistente de IA intenta llamar a una API externa no autorizada o exportar archivos sensibles, bloquea la acción de inmediato.
- Principio de mínimo privilegio para agentes de IA: Limita las herramientas y los permisos que concedes a tus agentes de IA. No des a un LLM acceso directo para eliminar archivos, enviar correos masivos o modificar configuraciones del sistema sin puntos de control de aprobación humana obligatorios (human-in-the-loop).
Cómo construir una estrategia de seguridad en capas y monitorización continua
La seguridad nunca es una solución milagrosa; requiere un enfoque de defensa en profundidad por capas. Junto con la validación de entradas, las organizaciones deben establecer prácticas robustas de monitorización continua. Como los ataques de inyección indirecta de prompts pueden ser sutiles y duraderos, tu equipo de operaciones de seguridad necesita visibilidad sobre los patrones de consulta a la IA, los volúmenes de acceso a datos y las secuencias de invocación de herramientas.
Despliega modelos de detección de anomalías que establezcan líneas base de las interacciones normales con la IA. Si un asistente empieza de repente a recuperar cientos de archivos confidenciales o a intentar conexiones salientes inusuales, las alertas automáticas deberían activar de inmediato un protocolo de contención. Combinar estas herramientas de monitorización con un registro de auditoría estructurado permite a tu equipo realizar análisis forenses y reforzar de forma continua la postura de seguridad de tu IA frente a las amenazas emergentes.
Conclusión: adaptarse al futuro de la seguridad de la IA empresarial
Mirando hacia el futuro de la tecnología empresarial, tratar cada documento de negocio como código ejecutable ya no es solo una metáfora ingeniosa: es una necesidad absoluta. La inyección indirecta de prompts representa un cambio fundamental en la forma en que los adversarios atacan a las organizaciones, aprovechando nuestro mayor activo: la integración fluida de la IA con el contenido empresarial cotidiano. Reconociendo las limitaciones de los controles de seguridad tradicionales, mapeando tus vectores de ataque e implementando políticas rigurosas de validación, monitorización y acceso, puedes aprovechar el poder de la IA sin comprometer los datos de tu empresa.
Para obtener un desglose completo y práctico de cómo estos conceptos se aplican directamente a los entornos modernos de Microsoft, escucha el episodio completo de nuestro podcast: Indirect Prompt Injection Security for Enterprise AI. ¡Mantente alerta, protege tus canalizaciones de datos y sigue construyendo una empresa más inteligente y más segura!