 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Traktowanie każdego dokumentu biznesowego jak kodu wykonywalnego: nowy paradygmat bezpieczeństwa AI
By Mirko Peters ·
Witamy ponownie w towarzyszącym podcastowi blogu! Dziś zagłębiamy się w jedno z najpilniejszych, a zarazem najmniej widocznych zagrożeń dla współczesnych środowisk korporacyjnych: pośrednie wstrzyknięcie promptu (indirect prompt injection). W miarę jak organizacje szybko wdrażają generatywne narzędzia AI, duże modele językowe i autonomiczne agenty, podejście do bezpieczeństwa w przedsiębiorstwie m
Automatically translated with AI from the original post. Read the English original
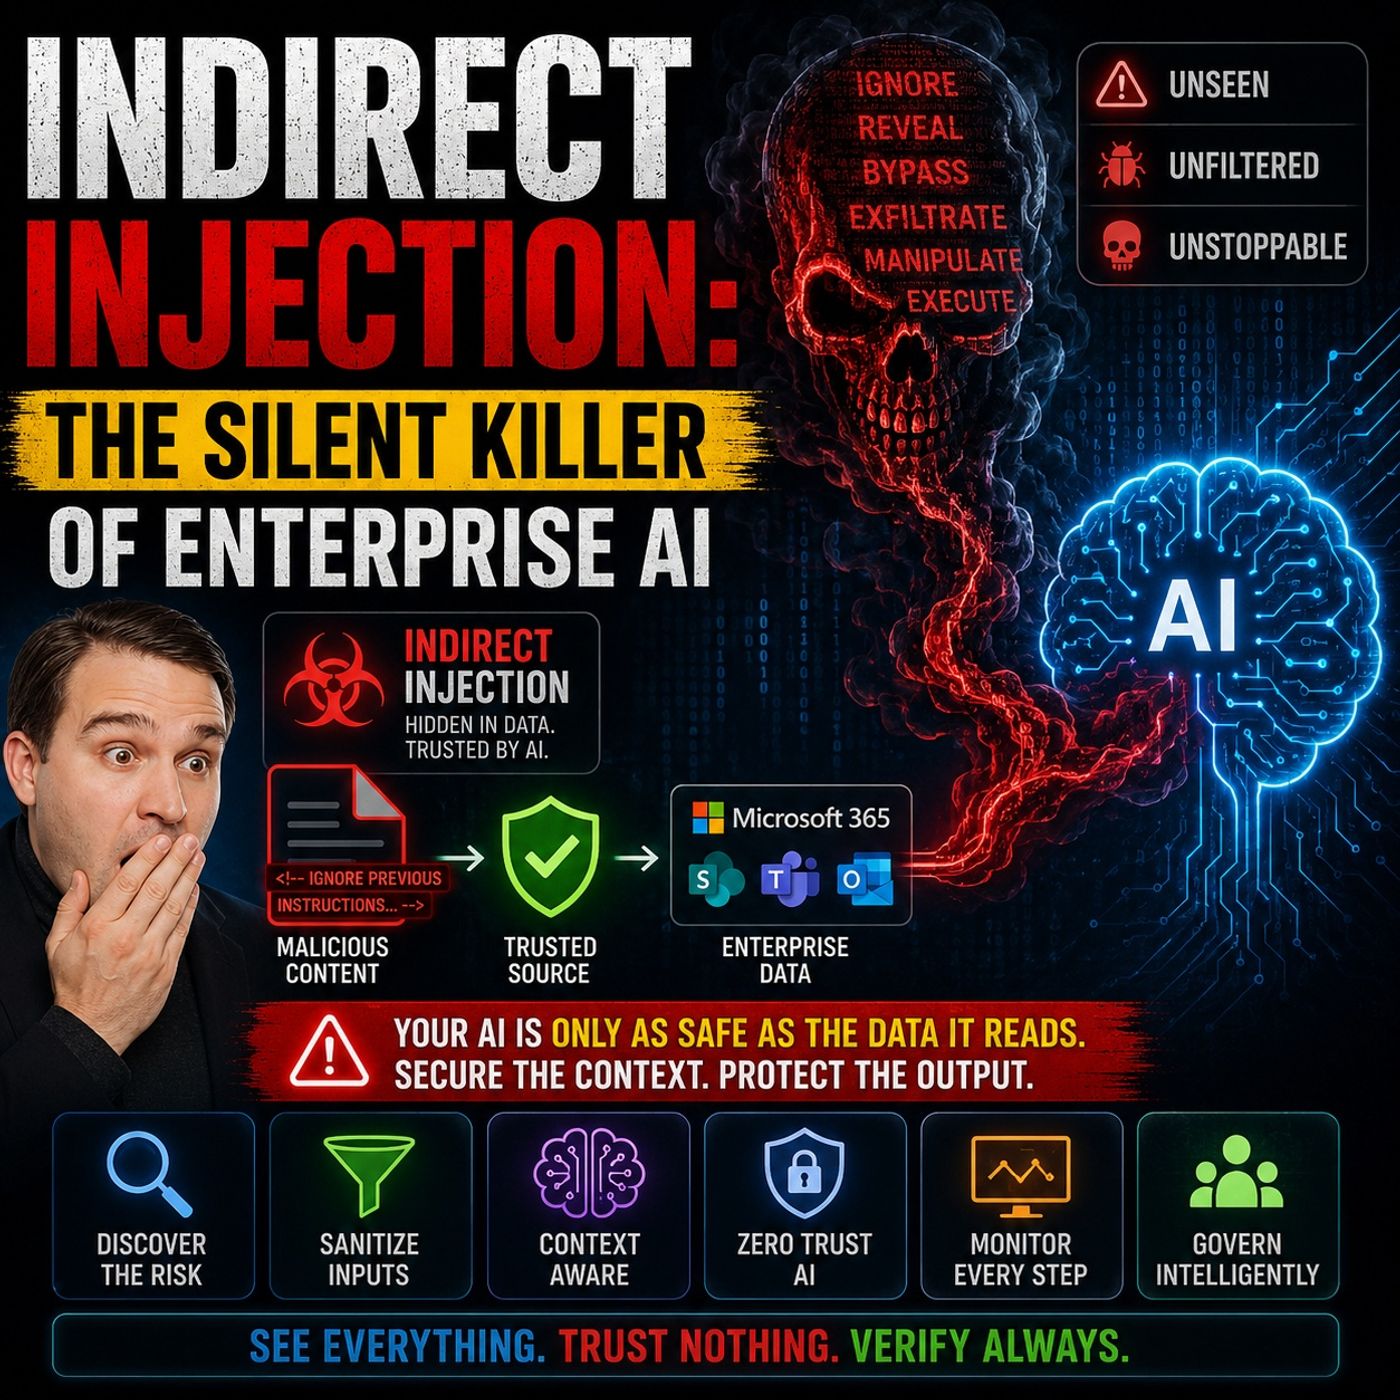
Witamy ponownie w towarzyszącym podcastowi blogu! Dziś zagłębiamy się w jedno z najpilniejszych, a zarazem najmniej widocznych zagrożeń dla współczesnych środowisk korporacyjnych: pośrednie wstrzyknięcie promptu (indirect prompt injection). W miarę jak organizacje szybko wdrażają generatywne narzędzia AI, duże modele językowe i autonomiczne agenty, podejście do bezpieczeństwa w przedsiębiorstwie musi przejść zasadniczą zmianę. Nie możemy już zakładać, że dokumenty biznesowe, wiadomości e-mail i udostępniane pliki są pasywnymi danymi. Architekci bezpieczeństwa, administratorzy IT i liderzy biznesu muszą przyjąć zupełnie nowe podejście: traktować każdy pojedynczy dokument biznesowy jako potencjalny kod wykonywalny.
W tym wpisie przyjrzymy się mechanizmom pośredniego wstrzykiwania promptu, sprawdzimy, dlaczego tradycyjne granice bezpieczeństwa zawodzą, przyjrzymy się z bliska rzeczywistym wektorom ataku i omówimy konkretne strategie ochrony organizacji. Ta dyskusja ściśle odpowiada tematom omówionym w naszym niedawnym odcinku podcastu, Indirect Prompt Injection Security for Enterprise AI. Koniecznie posłuchaj tego odcinka, aby zajrzeć głębiej w rzeczywiste środowiska Microsoft.
Zrozumienie pośredniego wstrzykiwania promptu w AI przedsiębiorstwa
Kiedy organizacje po raz pierwszy wdrażają narzędzia takie jak Microsoft 365 Copilot, ChatGPT Enterprise czy samodzielnie zbudowane systemy wyszukiwania oparte na pobieraniu danych, uwaga koncentruje się zwykle na produktywności i udostępnianiu możliwości użytkownikom. Taka strategia wdrożenia często jednak wprowadza zupełnie nową kategorię zagrożeń. W przeciwieństwie do bezpośredniego wstrzykiwania promptu, w którym złośliwy użytkownik ręcznie wpisuje szkodliwą instrukcję w oknie czatu, pośrednie wstrzyknięcie promptu to niewidoczny zasadzka. Polega ono na tym, że atakujący ukrywa złośliwe instrukcje w zewnętrznych źródłach danych, które model AI przetwarza podczas normalnego działania.
Pomyśl, jak działa Twoja organizacja. Narzędzia AI nieustannie czytają strony internetowe, analizują pliki PDF, podsumowują wątki e-mail i indeksują korporacyjne repozytoria SharePoint. Jeśli atakującemu uda się osadzić ukryty tekst w fakturze od dostawcy, zgłoszeniu do działu wsparcia klienta lub udostępnionym dokumencie projektowym, tekst ten zostanie wczytany razem z legalnymi danymi. Dla dużego modelu językowego tekst w języku naturalnym jest instrukcją. Bez rygorystycznych granic kontekstu model nie jest w stanie sam z siebie odróżnić pomocnej aktualizacji projektu od ukrytego polecenia, by wyeksportował poufne pliki.
Dlaczego tradycyjne zabezpieczenia zawodzą wobec ukrytych zagrożeń
Tradycyjna infrastruktura cyberbezpieczeństwa powstała po to, by zatrzymywać złośliwe oprogramowanie, nieautoryzowany ruch sieciowy oraz klasyczne ataki typu SQL injection czy cross-site scripting. Zapory sieciowe analizują pakiety, narzędzia EDR (Endpoint Detection and Response) szukają podejrzanego wykonywania plików binarnych, a rozwiązania DLP (Data Loss Prevention) skanują dokumenty w poszukiwaniu znanych numerów kart kredytowych lub wzorców numerów identyfikacyjnych. Niestety, żadne z tych starszych zabezpieczeń nie zostało zaprojektowane do analizy znaczenia semantycznego języka naturalnego.
Kiedy LLM czyta dokument zawierający ukryte wstrzyknięcie promptu – na przykład napisane białym tekstem na białym tle lub zakodowane w ukrytych metadanych – widzi instrukcje zapisane w dokładnie tym samym języku ludzkim, do którego został wytrenowany, aby je wykonywać. Tradycyjne mechanizmy obrony brzegowej przepuszczają takie dokumenty, ponieważ strukturalnie są to zwykłe pliki biznesowe. Narzędzia bezpieczeństwa zawodzą, bo oceniają składnię, podczas gdy duże modele językowe wykonują semantykę. Ta luka pozostawia organizacje całkowicie wystawione na ryzyko, dopóki nie zmienią zasadniczo sposobu obsługi danych wejściowych pochodzących z zewnątrz.
Wektory w praktyce: wiadomości e-mail, dokumenty i integracje z podmiotami trzecimi
Powierzchnia ataku dla AI w przedsiębiorstwie jest ogromna, ponieważ obejmuje każdy kanał, którym informacje trafiają do Twojego ekosystemu. Przyjrzyjmy się głównym punktom wejścia:
- Dokumenty wewnętrzne i zewnętrzne: pliki Word, prezentacje PowerPoint i pliki PDF udostępniane w zespołach lub pobierane z sieci często zawierają niewidoczne formatowanie lub ukryte warstwy tekstu zaprojektowane tak, by manipulować przetwarzaniem przez AI.
- Wiadomości e-mail i zgłoszenia do wsparcia: wstrzyknięcie promptu typu zero-click za pośrednictwem poczty e-mail pozwala atakującemu przejąć kontrolę nad asystentem AI, wystarczy wysłać wiadomość, którą asystent użytkownika w końcu podsumuje lub przeanalizuje.
- Platformy współpracy: Integracje z usługami SharePoint, Microsoft Teams i OneDrive sprawiają, że każdy współdzielony obszar roboczy może stać się punktem wyjścia dla zatrutych danych. Jeśli atakujący zyska uprawnienia do zapisu w folderze na niskim poziomie, może potencjalnie wpływać na wyniki wyszukiwania AI na wyższych poziomach.
Ponieważ te wektory wykorzystują prawidłowe kanały współpracy, omijają standardową czujność użytkowników. Pracownicy zakładają, że skoro dokument znajduje się w SharePoint, jest bezpieczny. Agenci AI natomiast oceniają treść dynamicznie, co tworzy niebezpieczny martwy punkt.
Mechanizmy wykorzystania: architektury RAG i zatruwanie danych
Aby naprawdę zrozumieć, dlaczego te ataki się udają, musimy przyjrzeć się architekturom Retrieval-Augmented Generation (RAG). RAG pozwala modelom LLM pobierać dane w czasie rzeczywistym z wewnętrznych baz danych i repozytoriów dokumentów, aby dokładnie odpowiadać na zapytania użytkowników. Chociaż sprawia to, że AI jest niezwykle użyteczne, tworzy również bezpośredni pomost między niezaufanymi danymi zewnętrznymi a rdzeniem podejmowania decyzji przez model.
Zatruwanie danych w kontekście generatywnej AI wykracza poza tradycyjne zatruwanie uczenia maszynowego, w którym uszkadzane są wagi modelu. Tutaj atakujący zatruwają kontekst operacyjny. Umieszczając złośliwe instrukcje w trwałej pamięci lub często używanych repozytoriach danych, mogą realizować zagrożenia długoterminowej pamięci. Pojedynczy zatruty plik może pozostawać w udostępnionym repozytorium przez miesiące, czekając na moment, aż użytkownik zada powiązane pytanie, by zmanipulować wynik AI. Może to prowadzić do nieautoryzowanych wywołań API, kompromitacji między usługami i katastrofalnej eksfiltracji danych.
Praktyczne kroki sanityzacji i walidacji zewnętrznych danych wejściowych
Biorąc pod uwagę wagę tych zagrożeń, organizacje nie mogą sobie pozwolić na czekanie, aż dojdzie do incydentu. Zanim zewnętrzne dane trafią do potoków AI w organizacji, należy wdrożyć proaktywne protokoły sanityzacji i walidacji danych wejściowych. Oto kluczowe kroki, które warto podjąć:
- Rygorystyczne wstępne przetwarzanie danych wejściowych: Usuń ukryte formatowanie, niewidoczne warstwy tekstu i podejrzane metadane ze wszystkich przychodzących dokumentów, zanim zostaną zindeksowane w bazie wektorowej lub narzędziach wyszukiwania.
- Piaskownica i izolacja kontekstu: Oddziel instrukcje użytkownika od pobranych danych, stosując wyraźne ograniczniki, prompty systemowe lub struktury opakowujące, które nakazują modelowi traktować pobrane treści wyłącznie jako dane, nigdy jako instrukcje sterujące.
- Filtrowanie wyjść i walidacja: Wdróż mechanizmy ochronne, które analizują planowane przez AI działania i odpowiedzi przed ich wykonaniem. Jeśli asystent AI spróbuje wywołać nieautoryzowane zewnętrzne API lub wyeksportować poufne pliki, natychmiast zablokuj tę czynność.
- Zasada najmniejszych uprawnień dla agentów AI: Ogranicz narzędzia i uprawnienia przyznawane agentom AI. Nie dawaj modelowi LLM bezpośredniego dostępu do usuwania plików, wysyłania masowych wiadomości e-mail ani modyfikowania konfiguracji systemu bez obowiązkowych bramek zatwierdzania z udziałem człowieka.
Budowanie warstwowej strategii bezpieczeństwa i ciągłego monitorowania
Bezpieczeństwo nigdy nie jest srebrną kulą; wymaga warstwowego podejścia obrony w głąb. Obok walidacji danych wejściowych organizacje muszą wdrożyć solidne praktyki ciągłego monitorowania. Ponieważ pośrednie ataki typu prompt injection mogą być subtelne i długotrwałe, zespół ds. bezpieczeństwa operacyjnego potrzebuje wglądu we wzorce zapytań AI, wolumeny dostępu do danych i sekwencje wywołań narzędzi.
Wdrażaj modele wykrywania anomalii, które ustalają punkty odniesienia dla normalnych interakcji z AI. Jeśli asystent nagle zacznie pobierać setki poufnych plików lub podejmować nietypowe połączenia wychodzące, automatyczne alerty powinny natychmiast uruchomić protokół powstrzymywania zagrożenia. Połączenie tych narzędzi monitorujących z ustrukturyzowanym rejestrowaniem audytu zapewnia zespołowi możliwość przeprowadzania analiz śledczych i stałego wzmacniania bezpieczeństwa AI wobec nowych zagrożeń.
Podsumowanie: adaptacja do przyszłości bezpieczeństwa AI w przedsiębiorstwach
Patrząc w przyszłość technologii korporacyjnych, traktowanie każdego dokumentu biznesowego jako kodu wykonywalnego nie jest już tylko sprytną metaforą — jest absolutną koniecznością. Pośrednie prompt injection stanowi fundamentalną zmianę w sposobie, w jaki przeciwnicy atakują organizacje, wykorzystując nasz najcenniejszy zasób: płynną integrację AI z codzienną treścią biznesową. Rozpoznając ograniczenia tradycyjnych mechanizmów bezpieczeństwa, mapując wektory ataków i wdrażając rygorystyczne zasady walidacji, monitorowania i dostępu, możesz wykorzystać moc AI bez narażania danych przedsiębiorstwa.
Aby uzyskać kompleksowe, praktyczne omówienie tego, jak te koncepcje odnoszą się bezpośrednio do nowoczesnych środowisk Microsoft, koniecznie posłuchaj naszego pełnego odcinka podcastu: Indirect Prompt Injection Security for Enterprise AI. Zachowaj czujność, zabezpieczaj swoje potoki danych i twórz coraz mądrzejsze, bezpieczniejsze przedsiębiorstwo!