 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Traiter chaque document professionnel comme du code exécutable : un nouveau paradigme pour la sécurité de l’IA
By Mirko Peters ·
Bienvenue sur le blog compagnon du podcast ! Aujourd’hui, nous plongeons au cœur de l’une des menaces les plus pressantes et les plus silencieuses qui pèsent sur les environnements d’entreprise modernes : l’injection de prompt indirecte.
Automatically translated with AI from the original post. Read the English original
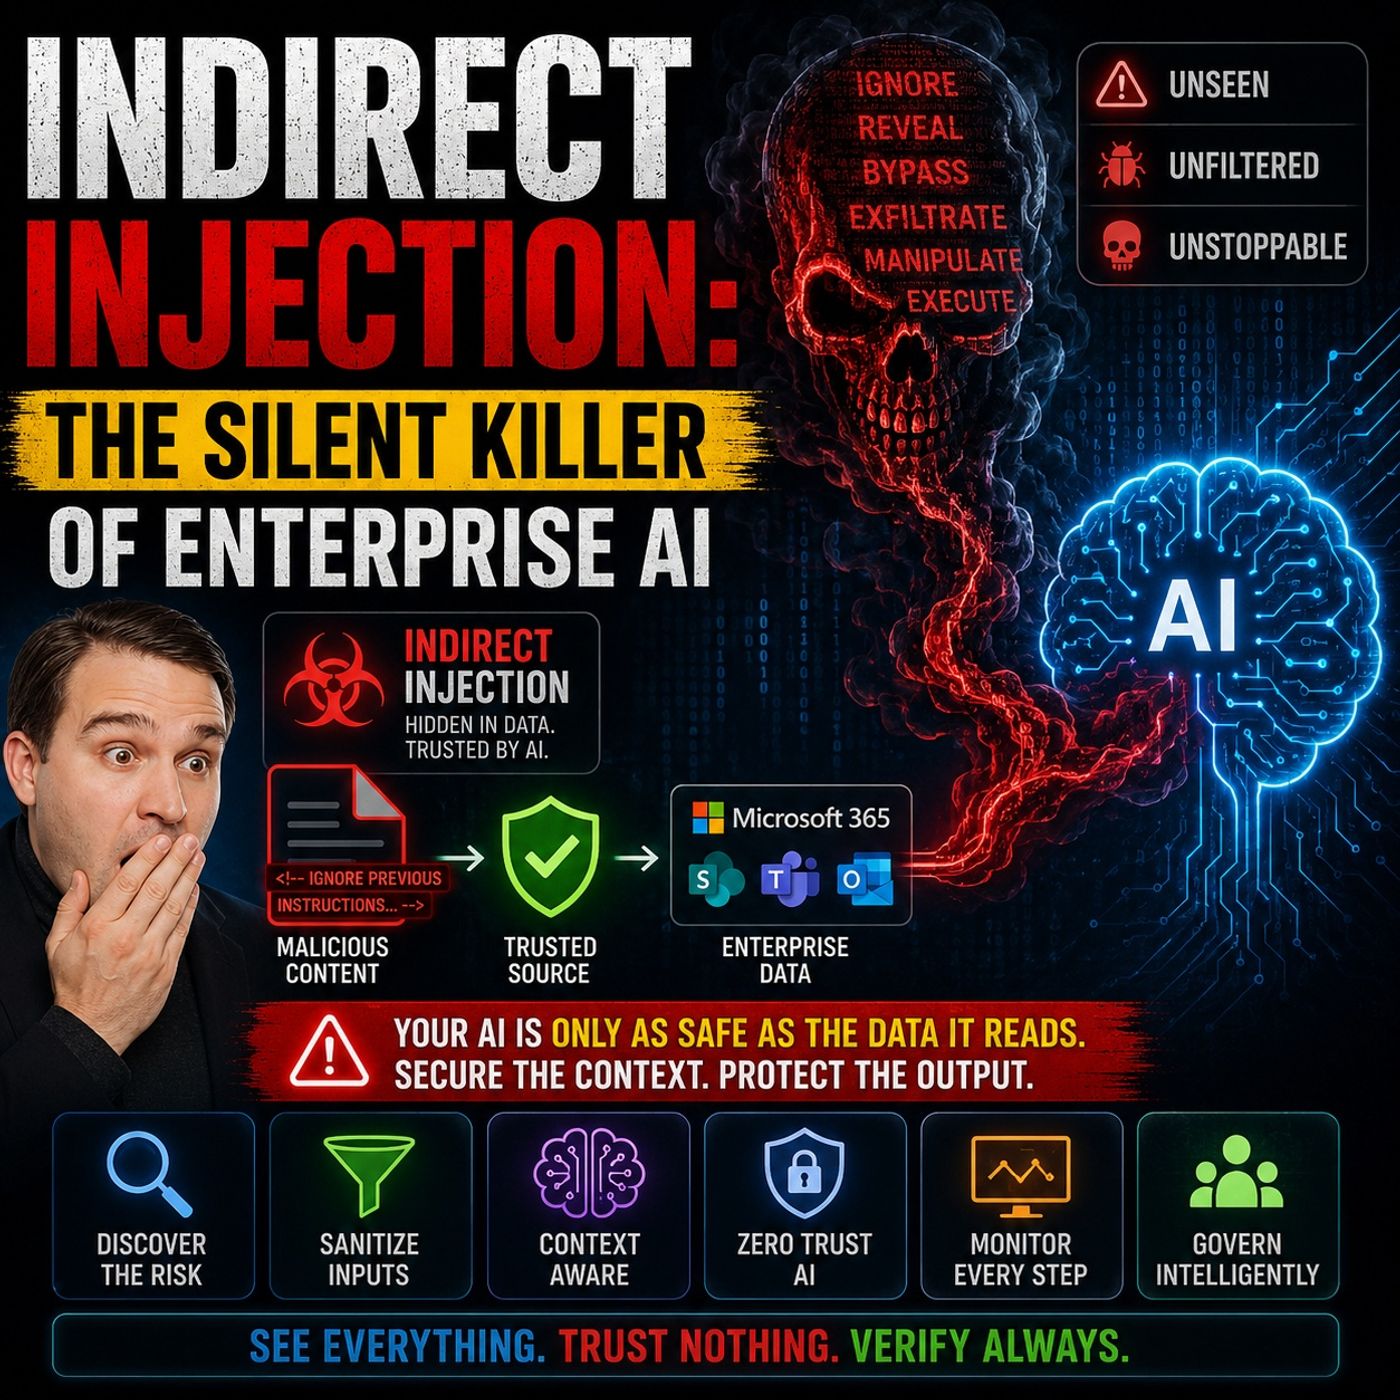
Bienvenue sur le blog compagnon du podcast ! Aujourd’hui, nous plongeons au cœur de l’une des menaces les plus pressantes et les plus silencieuses qui pèsent sur les environnements d’entreprise modernes : l’injection de prompt indirecte. À mesure que les organisations adoptent rapidement l’IA générative, les grands modèles de langage et les agents autonomes, notre approche de la sécurité d’entreprise doit évoluer en profondeur. Nous ne pouvons plus partir du principe que les documents professionnels, les courriels et les fichiers partagés sont de simples données passives. Les architectes de sécurité, les administrateurs informatiques et les décideurs doivent désormais adopter un état d’esprit radicalement nouveau, qui consiste à considérer chaque document professionnel comme un code exécutable potentiel.
Dans cet article, nous examinerons le fonctionnement de l’injection de prompt indirecte, nous analyserons pourquoi les périmètres de sécurité traditionnels sont en échec, nous étudierons de près des vecteurs d’attaque observés en conditions réelles, et nous décrirons des stratégies concrètes pour protéger votre organisation. Cette discussion reprend largement les thèmes abordés dans notre récent épisode de podcast, Indirect Prompt Injection Security for Enterprise AI. N’hésitez pas à écouter cet épisode pour une analyse encore plus approfondie des environnements Microsoft réels.
Comprendre l’injection de prompt indirecte dans l’IA d’entreprise
Lorsque les organisations déploient pour la première fois des outils comme Microsoft 365 Copilot, ChatGPT Enterprise ou des systèmes de recherche développés en interne, l’attention se porte généralement sur la productivité et l’accompagnement des utilisateurs. Cette stratégie de déploiement fait toutefois apparaître une catégorie de menaces inédite. Contrairement à l’injection de prompt directe, où un utilisateur malveillant saisit manuellement une instruction nuisible dans une fenêtre de discussion, l’injection de prompt indirecte est une embuscade invisible. Elle se produit lorsqu’un attaquant dissimule des instructions malveillantes dans des sources de données externes que le modèle d’IA traite au cours de son fonctionnement normal.
Réfléchissez au fonctionnement de votre entreprise. Vos outils d’IA lisent en permanence des pages web, analysent des fichiers PDF, résument des fils de courriels et indexent les dépôts SharePoint de l’entreprise. Si un attaquant parvient à intégrer du texte caché dans une facture fournisseur, un ticket du support client ou un document de projet partagé, ce texte est ingéré en même temps que les données légitimes. Pour un grand modèle de langage, le texte en langage naturel est une instruction. Sans des limites de contexte rigoureuses, le modèle ne peut pas distinguer, par nature, une mise à jour utile de projet d’une commande cachée lui demandant d’exfiltrer des fichiers confidentiels.
Pourquoi les contrôles de sécurité traditionnels échouent face aux menaces dissimulées
Les infrastructures de cybersécurité traditionnelles ont été conçues pour bloquer les logiciels malveillants, le trafic réseau non autorisé, ainsi que les injections SQL classiques et les attaques de type cross-site scripting. Les pare-feu inspectent les paquets, les solutions EDR (Endpoint Detection and Response) recherchent l’exécution suspecte de binaires, et les solutions DLP (Data Loss Prevention) analysent la présence de numéros de cartes bancaires connus ou de numéros de sécurité sociale. Malheureusement, aucun de ces contrôles historiques n’a été conçu pour analyser le sens sémantique du langage naturel.
Lorsqu’un LLM lit un document contenant une injection de prompt dissimulée, qu’elle soit écrite en texte blanc sur fond blanc ou encodée dans des métadonnées cachées, il voit des instructions rédigées dans la même langue humaine que celle qu’il a été entraîné à suivre. Les défenses périmétriques traditionnelles laissent passer ces documents, car, structurellement, ce ne sont que des fichiers professionnels ordinaires. Les outils de sécurité échouent parce qu’ils évaluent la syntaxe, alors que les grands modèles de langage exécutent la sémantique. Cet écart expose entièrement les organisations, tant qu’elles ne modifient pas en profondeur leur manière de traiter les entrées externes.
Vecteurs réels : courriels, documents et intégrations tierces
La surface d’attaque de l’IA d’entreprise est immense, car elle englobe chaque canal par lequel l’information pénètre dans votre écosystème. Examinons les principaux points d’entrée :
- Documents internes et externes : les fichiers Word, les présentations PowerPoint et les PDF partagés entre équipes ou téléchargés depuis le web contiennent souvent une mise en forme invisible ou des couches de texte cachées, conçues pour manipuler le traitement par l’IA.
- Courriels et tickets de support : l’injection de prompt sans clic par courriel permet à un attaquant de compromettre un assistant IA simplement en envoyant un courriel que l’assistant de l’utilisateur finira par résumer ou analyser.
- Plateformes collaboratives : Les intégrations avec SharePoint, Microsoft Teams et OneDrive font de chaque espace de travail partagé un terrain potentiel pour des données empoisonnées. Si un attaquant obtient un accès en écriture à un dossier de bas niveau, il peut influencer les récupérations de données effectuées par l’IA au niveau supérieur.
Comme ces vecteurs exploitent des canaux de collaboration légitimes, ils échappent à la vigilance habituelle des utilisateurs. Les employés supposent que si un document se trouve dans SharePoint, il est sûr. Les agents IA, en revanche, évaluent le contenu de manière dynamique, ce qui crée un angle mort dangereux.
Mécanismes d’exploitation : architectures RAG et empoisonnement des données
Pour bien comprendre pourquoi ces attaques réussissent, il faut examiner les architectures de génération augmentée par récupération (RAG, Retrieval-Augmented Generation). Le RAG permet aux LLM d’extraire des données en temps réel depuis des bases de données internes et des référentiels documentaires afin de répondre avec précision aux requêtes des utilisateurs. Si cela rend l’IA extrêmement utile, cela crée aussi un pont direct entre des données externes non fiables et le cœur décisionnel du modèle.
L’empoisonnement des données dans le contexte de l’IA générative dépasse le simple empoisonnement traditionnel de l’apprentissage automatique, qui consiste à corrompre les poids du modèle. Ici, les attaquants empoisonnent le contexte opérationnel. En insérant des instructions malveillantes dans une mémoire persistante ou dans des référentiels de données fréquemment consultés, ils peuvent mettre en place des menaces de mémoire à long terme. Un seul fichier empoisonné peut rester dans un dépôt partagé pendant des mois, en attendant de manipuler les résultats de l’IA dès qu’un utilisateur pose une question connexe. Il peut en résulter des appels d’API non autorisés, des compromissions entre services et une exfiltration catastrophique de données.
Mesures concrètes pour assainir et valider les entrées externes
Compte tenu de la gravité de ces risques, les organisations ne peuvent pas se permettre d’attendre qu’un incident se produise. Vous devez mettre en place des protocoles proactifs d’assainissement et de validation des entrées avant que les données externes n’atteignent vos chaînes de traitement IA d’entreprise. Voici les étapes essentielles à suivre :
- Prétraitement strict des entrées : Supprimez le formatage masqué, les couches de texte invisibles et les métadonnées suspectes de tous les documents entrants avant qu’ils ne soient indexés par votre base de données vectorielle ou vos outils de recherche.
- Bac à sable et isolation du contexte : Séparez les instructions de l’utilisateur des données récupérées à l’aide de délimiteurs clairs, de prompts système ou d’encapsulations structurelles qui demandent au modèle de traiter le contenu récupéré strictement comme des données, jamais comme des instructions de contrôle.
- Filtrage et validation des sorties : Mettez en place des garde-fous qui analysent les actions et réponses prévues de l’IA avant leur exécution. Si un assistant IA tente d’appeler une API externe non autorisée ou d’exporter des fichiers sensibles, bloquez immédiatement l’action.
- Principe du moindre privilège pour les agents IA : Limitez les outils et les autorisations accordés à vos agents IA. Ne donnez pas à un LLM un accès direct à la suppression de fichiers, à l’envoi de courriels en masse ou à la modification des configurations système sans points de contrôle obligatoires avec validation humaine.
Mettre en place une stratégie de sécurité en couches et de surveillance continue
La sécurité n’est jamais une solution miracle ; elle exige une approche de défense en profondeur, par couches. Parallèlement à la validation des entrées, les organisations doivent instaurer des pratiques de surveillance continue solides. Comme les attaques par injection de prompt indirecte peuvent être subtiles et durables, votre équipe de sécurité opérationnelle a besoin de visibilité sur les schémas de requêtes IA, les volumes d’accès aux données et les séquences d’invocation d’outils.
Déployez des modèles de détection d’anomalies qui établissent des références pour les interactions IA normales. Si un assistant commence soudainement à récupérer des centaines de fichiers confidentiels ou tente des connexions sortantes inhabituelles, des alertes automatiques doivent déclencher immédiatement un protocole de confinement. Associer ces outils de surveillance à une journalisation d’audit structurée permet à votre équipe de mener des analyses forensiques et de renforcer continuellement votre posture de sécurité IA face aux menaces émergentes.
Conclusion : s’adapter à l’avenir de la sécurité de l’IA en entreprise
Alors que nous regardons vers l’avenir de la technologie d’entreprise, considérer chaque document métier comme du code exécutable n’est plus seulement une métaphore astucieuse : c’est une nécessité absolue. L’injection de prompt indirecte représente un changement fondamental dans la manière dont les adversaires ciblent les organisations, en exploitant notre atout le plus précieux : l’intégration fluide de l’IA et du contenu métier quotidien. En reconnaissant les limites des contrôles de sécurité traditionnels, en cartographiant vos vecteurs d’attaque et en mettant en œuvre des politiques rigoureuses de validation, de surveillance et d’accès, vous pouvez exploiter la puissance de l’IA sans compromettre les données de votre entreprise.
Pour obtenir une analyse complète et pratique de la manière dont ces concepts s’appliquent directement aux environnements Microsoft modernes, écoutez notre épisode complet du podcast : Indirect Prompt Injection Security for Enterprise AI. Restez vigilant, sécurisez vos pipelines de données et continuez à bâtir une entreprise plus intelligente et plus sûre !