 HE
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 日本語
 한국어
הנזק הנסתר של נוחות: מדוע מחברים מנוהלים נכשלים בבינה מלאכותית ארגונית
By Mirko Peters ·
במשך שנים, ארגונים אימצו כלי אינטגרציה דל-קוד, מנועי אוטומציה ומחברים מנוהלים כתקן הזהב המוחלט לטרנספורמציה דיגיטלית. הם מייצגים את "כפתור הקלות" של הארכיטקטורה המודרנית. צריכים לחבר את Salesforce ל-Azure? מוסיפים מחבר מנוהל. צריכים להזין טלמטריה לאגם הנתונים או להעביר התראות דרך ערוצי תקשורת ארגוניים? מרימים עטיפה דל-קוד, מגדירים כמה אסימוני אימות, ומתבוננים בזרימת הנתונים. המודולים המוכנים מראש
Automatically translated with AI from the original post. Read the English original
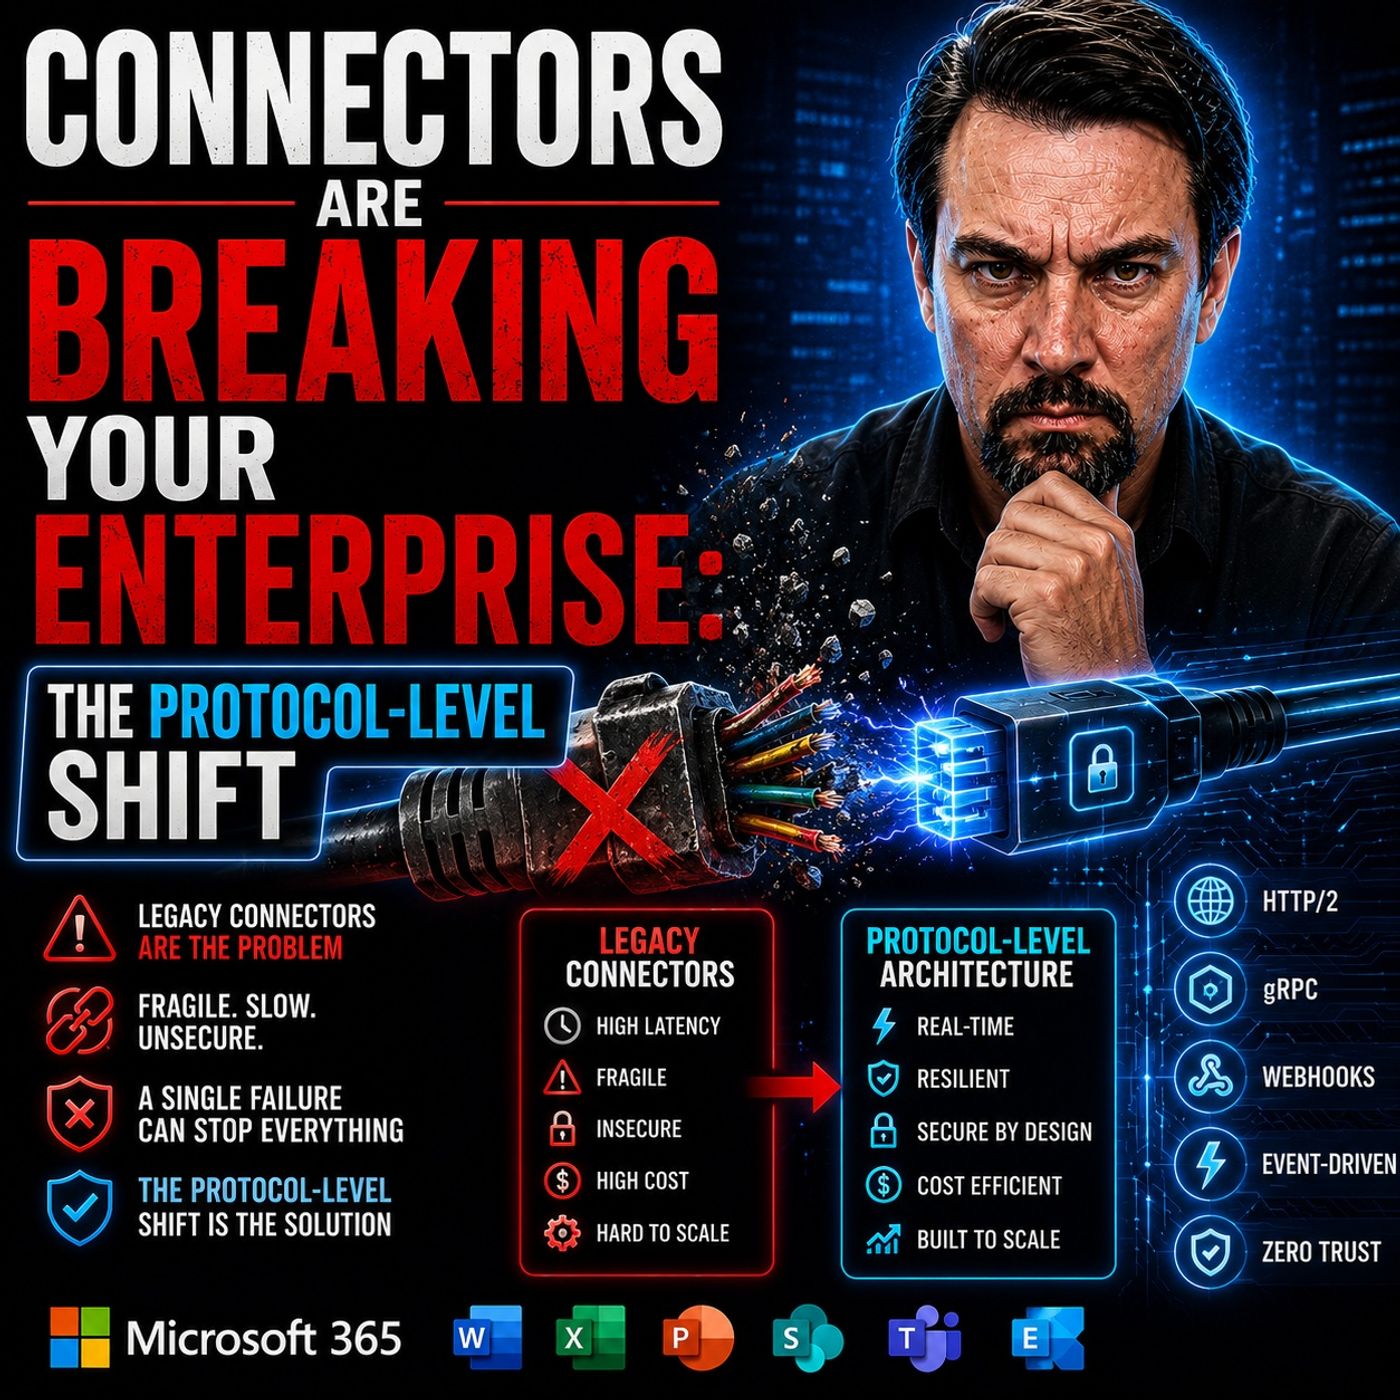
במשך שנים, ארגונים אימצו כלי אינטגרציה דל-קוד, מנועי אוטומציה ומחברים מנוהלים כתקן הזהב המוחלט לטרנספורמציה דיגיטלית. הם מייצגים את "כפתור הקלות" של הארכיטקטורה המודרנית. צריכים לחבר את Salesforce ל-Azure? מוסיפים מחבר מנוהל. צריכים להזין טלמטריה לאגם הנתונים או להעביר התראות דרך ערוצי תקשורת ארגוניים? מרימים עטיפה דל-קוד, מגדירים כמה אסימוני אימות, ומתבוננים בזרימת הנתונים. המודולים המוכנים מראש מבטיחים פריסה מהירה, פחות חיכוך, ומינימום של פיקוח הנדסי מעמיק.
אולם, מתחת לחזית הנוחות התפעולית הקיצונית הזו מסתתר מודל תעבורה שביר ורגיש במיוחד. הארכיטקטורה הארגונית המודרנית, ובעיקר הצמיחה המסחררת של בינה מלאכותית, זרימות עבודה אג'נטיות בזמן אמת ותעבורת מכונה-למכונה בריכוזיות גבוהה, חושפת את המגבלות המבניות העמוקות של פלטפורמות אינטגרציה מנוהלות מסורתיות. כאשר זרימות עבודה נכשלות תחת עומס מקבילי כבד, כאשר ההשהיה מזנקת באופן בלתי צפוי, או כאשר יישומים נופלים בשרשרת להשבתות נרחבות, צוותי פיתוח נוטים להצביע על לוגיקת היישום או על אי-יציבות המודל. אך לא פעם, שורש הבעיה נמצא עמוק יותר במערכת: שכבת התעבורה עצמה.
כדי להבין באמת מדוע אוטומציה ארגונית נתקעת תחת עומס, עלינו לקלף את שכבות ההפשטה שמספקים מחברים מדור קודם ולבחון את המחירים הארכיטקטוניים שאנחנו משלמים על הנוחות. בעידן שנשלט על ידי עומסי בינה מלאכותית בתפוקה גבוהה, הגיע הזמן לבחון מחדש את העלויות הנסתרות של תוכנות ביניים מנוהלות ולחקור את פרדיגמות ההנדסה הנדרשות לבניית מערכות עמידות וניתנות להרחבה.
מלכודת הנוחות של מחברים מנוהלים
הפילוסופיה המרכזית שמאחורי מחברים מנוהלים היא מהירות להגעה לשוק. על ידי הפשטה של קריאות הרשת הבסיסיות, סכמות ה-API ופרוטוקולי התעבורה, הספקים מאפשרים למפתחים לשלב תהליכים עסקיים מורכבים תוך שעות במקום שבועות. עם זאת, ההפשטה הזו באה במחיר ארכיטקטוני כבד.
כל מחבר מנוהל פועל כמתווך פעיל שיושב ישירות בין שירותי המיקרו המבוזרים שלכם. כאשר בקשה נשלחת, הנתונים שלכם מיורטים, נארזים מחדש, עוברים סריאליזציה, מנותבים דרך תשתית משותפת מרובת דיירים, כפופים לכללי הגבלת קצב של שער ה-API, נבדקים על ידי שכבות אכיפת מדיניות, ולבסוף מתורגמים לפני שהם מגיעים בכלל ליעד המיועד. היירוט המתמיד הזה יוצר תלויות ארכיטקטוניות נסתרות. המערכת שלכם כבר לא מתקשרת ישירות עם שירות היעד; היא מתקשרת דרך מתווך קופסה שחורה, שהקיבולת הפנימית שלו, הקצאת המשאבים שלו ותקינותו התפעולית נמצאים כולם מחוץ לשליטה התפעולית שלכם.
יתרה מזאת, מודל התשתית המשותפת הזה מייצר מטבעו חיכוך בלתי צפוי בתוכנת הביניים. מכיוון שמחברים אלה פועלים לעיתים קרובות על תשתית מרובת דיירים שמנוהלת על ידי צדדים שלישיים, מטעני הנתונים הארגוניים הקריטיים שלכם מתחרים על מחזורי מעבד, הקצאות זיכרון ורוחב פס רשת לצד אלפי דיירים אחרים. כאשר מתרחשים זינוקי תעבורה גלובליים, זרימות העבודה המקומיות שלכם נחשפות להפרעות מצד שכנים ולאכיפת הגבלות פתאומית. עיצוב המבוסס על נוחות מקריב באופן עקבי עמידות מבנית, ומחליף התנהגות רשת דטרמיניסטית בתזמור קופסה שחורה הסתברותי.
המס של ההשהיה והעלויות הארכיטקטוניות הנסתרות
אדריכלים נופלים לעיתים קרובות במלכודת של התייחסות למחברים כאל צינורות שקופים, תעלות ניטרליות שפשוט מעבירות נתונים מנקודה א' לנקודה ב'. במציאות, מחברים הם שכבות אינטגרציה עתירות חישוב שמטילות מס ביצועים כבד ומצטבר על כל מערך הטכנולוגיה שלכם.
בואו נבחן את המכניקה של ארכיטקטורת polling מסורתית מבוססת REST. כדי לבדוק עדכונים או שינויים בנתונים, מחבר מנוהל חייב לשלוח באופן מתמיד מחזורי בקשה-תגובה חוזרים. אם מערכת מבצעת polling כל כמה שניות על פני מאות זרימות עבודה במקביל, בזבוז התשתית הוא עצום. מיליוני בקשות HTTP חוזרות עם מטעני נתונים ריקים, וצורכות כמויות אדירות של מחזורי מעבד לפענוח, לתהליכי לחיצת יד של חיבורים ולתקורה של כותרות.
זה מביא אותנו לעלות הכבדה של סריאליזציית JSON חוזרת. מטעני נתונים מבוססי טקסט כמו JSON קריאים מאוד לבני אדם, אבל הם לא יעילים בכלל לתקשורת בין מכונות. בכל פעם שמחבר מעבד מטען, עליו להמיר מבני נתונים מורכבים למחרוזות טקסט מנופחות בצד השולח, להעביר את המטענים הנפוחים הללו ברשת, ואז לפרש את המחרוזות בחזרה לזיכרון בצד המקבל. ככל שתהליכי עבודה מבוזרים הופכים למורכבים יותר, ההשהיה הזו מצטברת באופן אקספוננציאלי.
והחמור מכך הוא ההשפעה המדורדרת של שגיאות 429 של הגבלת קצב (rate limiting) וצמצום תעבורה (throttling). כאשר API במורד הזרם מזהה זרם בקשות פתאומי ממחבר מנוהל, הוא משיב בקודי throttling. פלטפורמות אינטגרציה סטנדרטיות מגיבות לאותות האלה באמצעות ניסיונות חוזרים אוטומטיים. תחת עומס כבד, הניסיונות החוזרים מתרבים במהירות והופכים לסופות ניסיונות הרסניות, שמשיקות למעשה התקפת Distributed Denial of Service (DDoS) מקומית על המערכות הפנימיות שלכם. תהליכי עבודה שפועלים ללא רבב בסביבות staging תחת בדיקות מפתחים בנפח נמוך, קורסים כמעט תמיד תחת משקלו הבלתי סלחני של מקביליות ארגונית בעולם האמיתי.
מ-REST לבינארי: למה gRPC משנה את פני האינטגרציה הארגונית
אם פרוטוקולים מבוססי טקסט ועטיפות REST מנוהלות מגיעים לקיר ביצועים, מה החלופה? הדור הבא של ארכיטקטורה ארגונית עתירת תפוקה נע בתנופה לעבר הרחקה מתקשורת טקסטואלית מילולית, וקרוב יותר לשכבות תעבורה בינאריות שמותאמות למכונות.
כאן gRPC ו-Protocol Buffers (Protobuf) משנים מהיסוד את החשבון של מערכות מבוזרות. במקום להסתמך על מטעני JSON גדולים ובקשות HTTP מרובות ופטפטניות, gRPC משתמש בהודעות בינאריות קומפקטיות שמותאמות במיוחד לתקשורת מכונה בביצועים גבוהים. סריאליזציה בינארית דוחסת מבני נתונים לתוך בתים בצפיפות רבה, ומקטינה באופן דרסטי את גודל המטענים – לעיתים בסדר גודל שלם לעומת מקבילותיהם ב-JSON.
הקטנת גודל המטען מתורגמת ישירות לעומס CPU נמוך יותר. ניתוח נתוני Protobuf בינאריים דורש מאמץ חישובי מינימלי בהשוואה לניתוח מסמכי טקסט מסורבלים. יתרה מכך, gRPC פועל באופן מקורי מעל HTTP/2, ומאפשר זרמים מרובבים (multiplexed) על חיבור TCP יחיד, ומפחית באופן משמעותי את ההשהיה בהקמת החיבור ומבטל קפיצות רשת מיותרות.
יתרון מרכזי נוסף במעבר לארכיטקטורה מבוססת פרוטוקול הוא תקשורת שמונעת על ידי סכמה (schema-first). אינטגרציות REST מסורתיות סובלות לא פעם מסחף ממשקים (interface drift), שבו שינויים בשדות שלא תועדו או פרמטרים חסרים שוברים תהליכי עבודה תלויים בזמן ריצה. gRPC אוכף חוזים מוקלדים היטב באמצעות הגדרות Protobuf מקומפלות. גם הלקוח וגם השרת מסכימים על מבנה הנתונים המדויק לפני הפריסה, וכך מתבטלות שלמות קטגוריות של באגים באינטגרציה, ומובטחת נאמנות מוחלטת לחוזה לאורך גבולות ארגוניים מבוזרים.
להיפרד מ-Polling: זרמים מתמשכים ותעבורה בזמן אמת
מחברים מנוהלים מסורתיים נשענים מהיסוד על הנחה ארכיטקטונית מיושנת: שעבודה ארגונית תמיד מתחילה בבקשה נקודתית ותגובתית. אבל בנוף המודרני של בינה מלאכותית ארגונית בזמן אמת ואוטומציה מונעת אירועים, המתנה לכך שמערכות יבצעו polling לעדכונים מציגה עיכובים בלתי מתקבלים על הדעת ובזבוז של רוחב פס.
המעבר הארכיטקטוני ממשיכה של polling לעבר פרוטוקולי זרימה מתמשכים כבר אינו אופציונלי עבור מערכות בקנה מידה גדול. טכנולוגיות כמו WebSockets, HTTP/3, QUIC ו-WebTransport מאפשרות למערכות לשמור על ערוצי תקשורת דו-כיווניים מתמשכים, שבהם הנתונים נדחפים באופן מיידי ברגע שמתרחש אירוע.
Polling יוצר נפחים עצומים של תעבורה ריקה שמציפה ממשקי רשת ומשחיתה משאבי מחשוב. מודלים של זרימה מתמשכת, לעומת זאת, שומרים על חיבור פתוח שבו הקשר זורם ברציפות עם תקורה מינימלית של פרוטוקול. יתרה מכך, פרוטוקולי תעבורה מודרניים כמו QUIC מבטלים צווארי בקבוק מרכזיים ברשת כמו חסימת Head-of-Line, וכך מבטיחים שאובדן פאקטות בזרם יחיד לא יעצור העברות נתונים שאינן קשורות.
באמצעות מעבר לתעבורה מבוססת אירועים מתמשכת, ארגונים יכולים להשיג העברת אירועים תוך פחות מ-100 מילישניות בקנה מידה גלובלי. היכולת הזו חיונית במיוחד לתמיכה בכוח עבודה מבוזר מודרני ובסוכני AI בזמן אמת, שדורשים הפצת הקשר מיידית מבלי להמתין לפרקי סנכרון מחזוריים כדי לסנכרן את המצב.
בניית חוסן: תורים אסינכרוניים וארכיטקטורות עמידות לתקלות
מערכות מהירות שנבנו ללא עמידות לתקלות הופכות בהכרח למנועי כשל מהירים. אחד מפגמי התכנון המסוכנים ביותר באינטגרציות סינכרוניות המבוססות על מחברים הוא ההנחה העיוורת שכל שירות במורד הזרם, כל מסד נתונים וכל ממשק API של SaaS צד שלישי יישארו זמינים ברציפות.
בסביבות ארגוניות אמיתיות, מערכות מבוזרות חוות כשלים חלקיים מתמידים, פיצולי רשת חולפים, תחזוקת מסדי נתונים שוטפת ועומסי תעבורה פתאומיים. כאשר זרימות אינטגרציה מקושרות בחוזקה בשרשרת סינכרונית, האטה זמנית בשירות היקפי אחד יוצרת לחץ הפוך שמתפשט במעלה הזרם ומשתק יישומים עסקיים מרכזיים.
דפוסי חוסן אסינכרוניים פותרים את הפגיעות הזו על ידי ניתוק מהירות הקליטה ממהירות העיבוד. על ידי הוספת תורי הודעות עמידים ומתווכי אירועים — כגון Azure Service Bus, RabbitMQ או Amazon SQS — בין גבולות השירותים שלכם, אתם יוצרים חיץ חזק מפני תנודתיות.
כאשר עומס פתע מגיע לשכבת האינטגרציה שלכם, האירועים הנכנסים נקלטים ונשמרים באופן בטוח באחסון עמיד, במקום לאלץ עיבוד סינכרוני מיידי על פני תלויות במורד הזרם שאינן יציבות. צרכנים במורד הזרם שולפים הודעות מהתור בקצב מבוקר ובר קיימא. אם שירות backend יורד לתחזוקה, התור שומר על הנתונים בבטחה עד לשחזור, מונע אובדן נתונים, מבטל כשלים מדרדרים קטסטרופליים ומבטיח שארכיטקטורת הארגון שלכם תישאר עמידה גם תחת לחץ קיצוני.
שינוי הכיוון בזמן הריצה: החזרת השליטה באמצעות מחברים מובנים
מעבר לפרוטוקולי רשת ולאסטרטגיות תורים, אדריכלי ארגונים חייבים לבחון בקפידה את סביבת ההרצה הפיזית של שכבות האינטגרציה שלהם. אחד ההיבטים המובנים לא נכון ביותר של אוטומציה בענן הוא המקום שבו מחברים מנוהלים מבצעים בפועל את פעולתם.
ארגונים רבים מניחים שמכיוון שלוגיקת האינטגרציה שלהם מתארחת בתוך מנוי הענן הארגוני שלהם — למשל ב-Azure Logic Apps — כל עיבוד הנתונים נשאר מבודד בבטחה בתוך גבולות הרשת המהימנים שלהם. עם זאת, מחברים מנוהלים מסורתיים רבים פועלים כאינטגרציות SaaS חיצוניות, שרצות על תשתית רב-דיירית ומשותפת, מחוץ ל-Virtual Network (VNet) שלכם לחלוטין.
המציאות הארכיטקטונית הזו יוצרת פגיעויות אבטחה חמורות וסיכוני ציות לגישת אפס אמון. כאשר נתוני הארגון הרגישים שלכם יוצאים מגבול הרשת הפרטית כדי שיעובדו על ידי תוכנת ביניים מנוהלת של צד שלישי, אתם מוותרים על השליטה הישירה בשכבת התעבורה. כדי לגשר על הפער הזה, ארגונים נוטים להסתמך על On-Premises Data Gateways, שלעתים קרובות הופכים לצווארי בקבוק ארגוניים גדולים ולנקודות כשל יחידות.
הפתרון טמון במעבר אסטרטגי לזמן ריצה עם מחברים מובנים ומודלי הרצה מבודדים — כגון Azure Logic Apps Standard הפועל על App Service Environments ייעודיים או על סביבות ריצה מבוססות קונטיינרים. מחברים מובנים מתבצעים ישירות בתוך סביבת החישוב וגבולות ה-VNet שלכם. כך מתבטלים קפיצות SaaS חיצוניות, מצטמצמת החביון בצורה דרמטית, מתקיימות דרישות ציות מחמירות לגישת אפס אמון, ונשמרת שליטה מלאה בצינורות הנתונים הארגוניים שלכם.
סיכום: תכנון להרחבה עמידה בעידן ה-AI
עידן ההתייחסות לאינטגרציה כמחשבה נוספת בתחום low-code הסתיים רשמית. בזמן שארגוניםמתחרים בפריסת מודלי AI מתוחכמים, סוכנים אוטונומיים וצינורות נתונים בזמן אמת, מודלי התעבורה השבירים שבבסיס מחברים מנוהלים מסורתיים נסדקים תחת הלחץ. חיכוך של תוכנות ביניים, "מסי" השהיה נסתרים, צווארי בקבוק של הגבלת קצב ורצים משותפים לא מאובטחים כבר אינם אי־נוחויות קטנות — הם סיכוני עסק קריטיים שפוגעים ביציבות המערכת ומעכבים חדשנות דיגיטלית.
בניית העתיד דורשת שינוי יסודי בגישה. עלינו להתרחק מסקרי REST מדוברים, ממטעני JSON מנופחים ומ-middleware מנוהל שפועל כקופסה שחורה, ולעבור במקום זאת להנדסה מבוססת פרוטוקול: סריאליזציה בינארית עם gRPC, סטרימינג בזמן אמת מתמשך, חוסן אסינכרוני מבוסס תורים, ושליטה קפדנית בסביבת הריצה.
כדי להעמיק בשינויים הארכיטקטוניים האלה, לחקור דפוסי תכנון מעשיים וללמוד כיצד לשמור על תשתית האינטגרציה שלכם מוכנה לעתיד מול הדרישות של בינה מלאכותית מודרנית, הקשיבו לפרק הפודקאסט המשלים: Custom Connectors vs Model Context Protocol for Enterprise AI. החזרת השליטה בשכבת התעבורה הארגונית היא הצעד החשוב ביותר שתוכלו לעשות לבניית מערכות אוטומציה עמידות ומדרגיות באמת.