 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
便利さに潜む隠れたコスト:マネージドコネクタがエンタープライズAIで失敗する理由
By Mirko Peters ·
長年にわたり、多くの組織がデジタルトランスフォーメーションの絶対的なゴールドスタンダードとして、ローコード統合ツール、自動化エンジン、マネージドコネクタを採用してきました…
Automatically translated with AI from the original post. Read the English original
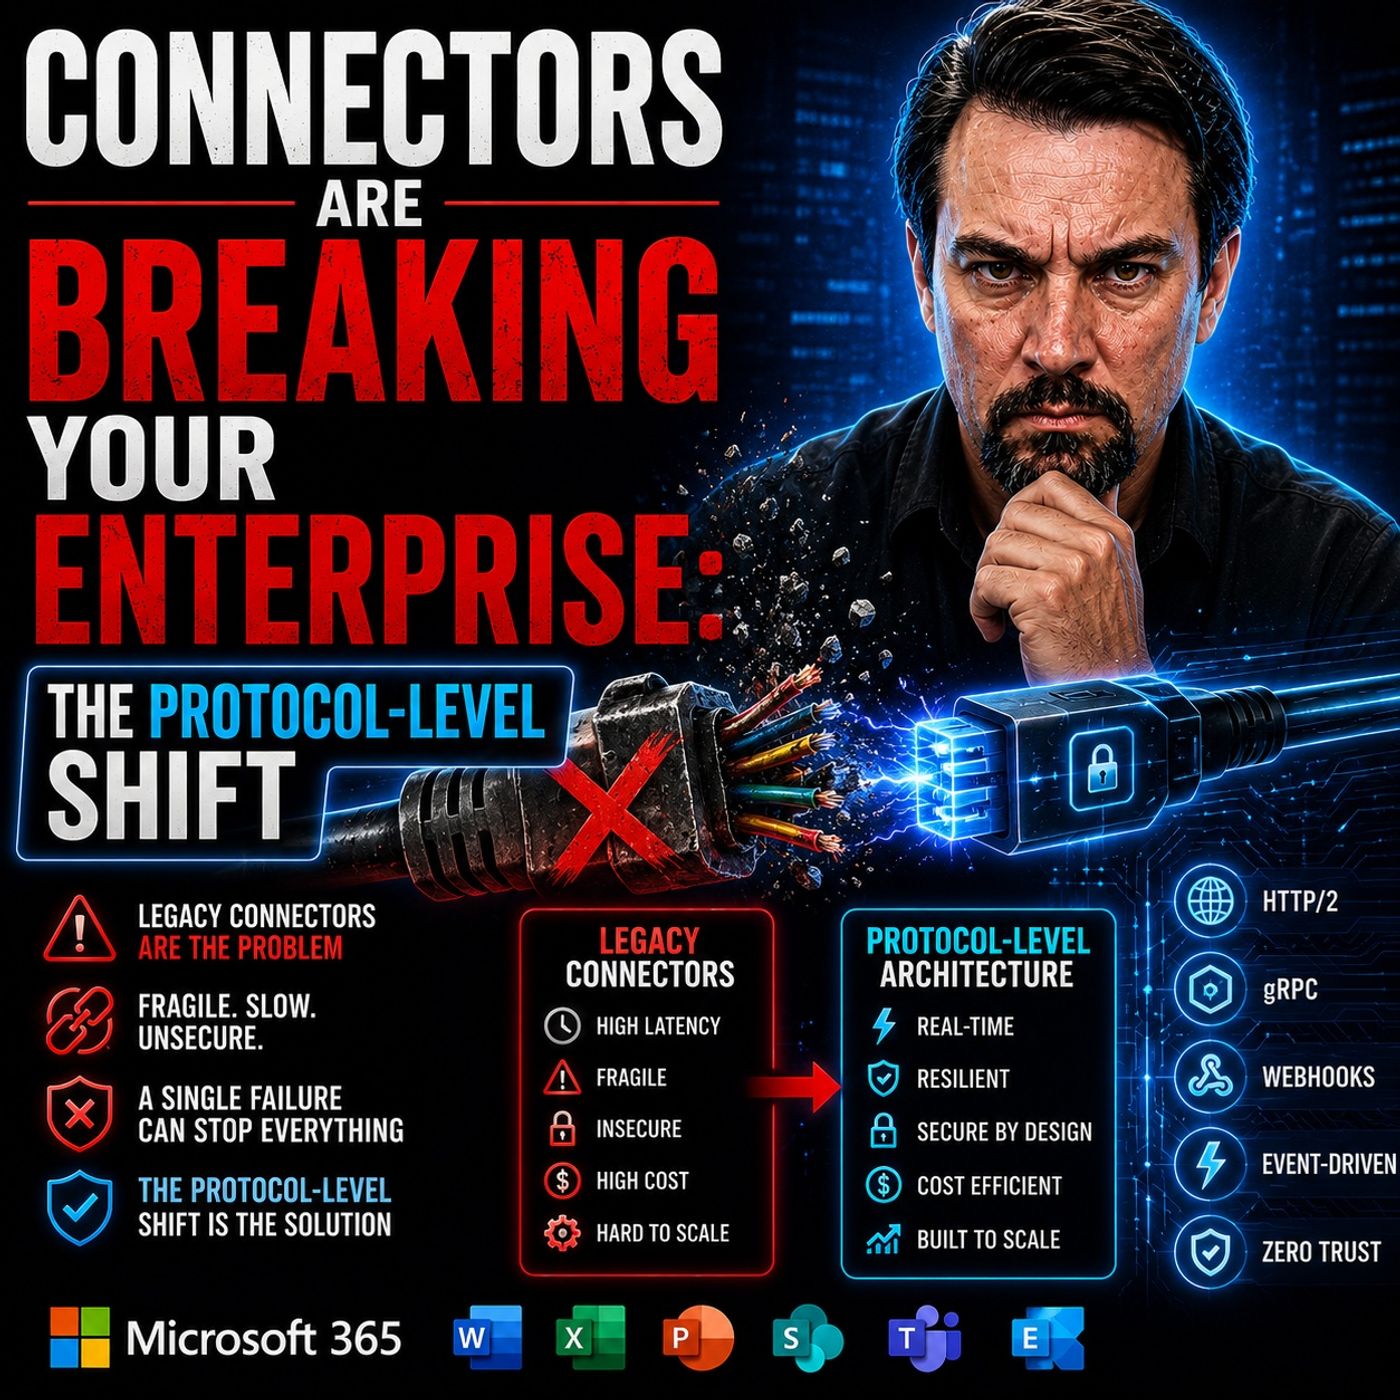
長年にわたり、多くの組織がローコード統合ツール、自動化エンジン、マネージドコネクタを、デジタルトランスフォーメーションの絶対的なゴールドスタンダードとして採用してきました。これらは現代のアーキテクチャにおける「簡単ボタン」です。Salesforceを Azure に接続する必要がありますか? それならマネージドコネクタを1つ配置するだけです。テレメトリをデータレイクに取り込みたい場合や、通知を企業のコミュニケーションチャネル経由でルーティングしたい場合も同様です。ローコードのラッパーを立ち上げ、認証トークンをいくつか設定すれば、データが流れ始めます。これらの事前構築済みモジュールは、迅速な展開、摩擦の軽減、そして深いエンジニアリング上の監視の最小化を約束します。
しかし、この極めて便利な表面の下には、脆く、非常に壊れやすい転送モデルが潜んでいます。現代のエンタープライズアーキテクチャ、特に人工知能、リアルタイムのエージェント型ワークフロー、高同時実行のマシン間トラフィックの爆発的な増加により、従来のマネージド統合プラットフォームが抱える構造的な限界が露呈しつつあります。高負荷の同時実行でワークフローが失敗したとき、レイテンシーが予測不能に跳ね上がったとき、あるいはアプリケーションが連鎖的に広範囲の障害に陥ったとき、開発チームはアプリケーションのロジックやモデルの不安定さを原因として指摘しがちです。しかし多くの場合、根本原因はシステムのさらに深い部分、すなわちトランスポート層そのものに隠れています。
エンタープライズ自動化が負荷時に停滞する理由を真に理解するには、従来のコネクタが提供する抽象化の層をはがし、便利さの代償として支払っているアーキテクチャ上のペナルティを検証する必要があります。高スループットのAIワークロードが支配する時代に入った今、マネージドミドルウェアの隠れたコストを見直し、回復力とスケーラビリティを備えたシステムの構築に必要なエンジニアリングのパラダイムを探るべき時が来ています。
マネージドコネクタの便利さの罠
マネージドコネクタの根底にある基本思想は、市場投入までのスピードです。基盤となるネットワーク呼び出し、APIスキーマ、トランスポートプロトコルを抽象化することで、ベンダーは開発者が複雑なビジネスプロセスを数週間ではなく数時間で組み立てられるようにします。しかし、この抽象化にはアーキテクチャ上の大きな代償が伴います。
すべてのマネージドコネクタは、分散したマイクロサービスの間に位置するアクティブな仲介者として機能します。リクエストが開始されると、データは傍受され、再パッケージ化、シリアライズされ、共有のマルチテナント基盤を経由し、ゲートウェイのスロットリングルールの対象となり、ポリシー適用レイヤーで評価され、最終的に対象に届く前に変換されます。この絶え間ない傍受は、目に見えないアーキテクチャ上の依存関係を生み出します。システムはもはや対象のサービスと直接通信しておらず、そのキャパシティ、リソース割り当て、運用状態が自社の運用管理の完全な外にあるブラックボックスの仲介者を介して通信しているのです。
さらに、この共有インフラモデルは本質的に、予測不能なミドルウェアの摩擦を生みます。これらのコネクタは多くの場合、サードパーティが管理するマルチテナント基盤上で実行されるため、重要なエンタープライズデータのペイロードは、何千もの他テナントと並んで CPU サイクル、メモリ割り当て、ネットワーク帯域を奪い合うことになります。世界規模でトラフィックが急増すると、ローカルのワークフローは隣接テナントによる干渉(ネイバーノイズ)や突然のスロットリングの影響を受けやすくなります。便利さを重視した設計は、決定的なネットワーク動作を確率的なブラックボックスのオーケストレーションに置き換え、構造的な回復力を一貫して犠牲にしているのです。
レイテンシーという税と、見えないアーキテクチャコスト
アーキテクトは、コネクタを透明なパイプ、つまり地点Aから地点Bへデータを単に渡すだけの中立的な導管と見なす罠に陥りがちです。実際には、コネクタは計算負荷の高い統合レイヤーであり、技術スタック全体に重く、累積していく性能上の負担を課しています。
従来のRESTベースのポーリングアーキテクチャの仕組みを考えてみましょう。データの更新や変更を確認するために、マネージドコネクタは繰り返しのリクエスト・レスポンスのサイクルを継続的に発行しなければなりません。数百の同時実行ワークフローで数秒ごとにポーリングを行うと、インフラの無駄は途方もないものになります。何百万もの HTTP リクエストが空のペイロードを返し、解析、接続のハンドシェイク、ヘッダーのオーバーヘッドに膨大な CPU サイクルを消費してしまうのです。
これが、反復的な JSON シリアル化の大きなコストにつながります。JSON のようなテキストベースのペイロードは人にとって非常に読みやすい一方で、マシン同士の通信には極めて非効率です。コネクタがペイロードを処理するたびに、送信側で複雑なデータ構造をかさばる文字列形式にシリアル化し、膨らんだペイロードをネットワーク越しに送信し、受信側でその文字列を再びメモリ上に解析し直す必要があります。分散ワークフローが複雑になるにつれて、この遅延は指数関数的に積み重なっていきます。
さらに深刻なのが、429 のレート制限とスロットリングエラーによる連鎖的な影響です。下流の API がマネージド コネクタからのリクエストの急増を検出すると、スロットリングのコードを返します。標準的な統合プラットフォームは、この信号に応じて自動再試行を開始します。高負荷時にはこの再試行が急速に増殖し、破壊的な再試行の嵐となって、自社の内部システムに対する局所的な分散型サービス拒否(DDoS)攻撃のような状態を引き起こします。開発者が少量のテストを行うステージング環境では問題なく動作していたワークフローも、実際のエンタープライズ規模の同時実行負荷に耐えられず、必ずと言っていいほど崩壊します。
REST からバイナリへ: gRPC がエンタープライズ統合を変えつつある理由
テキストベースのプロトコルとマネージド REST ラッパーがパフォーマンスの壁に突き当たっているとすれば、代替案は何でしょうか。次世代の高スループットなエンタープライズ アーキテクチャは、冗長なテキストベースの通信から離れ、マシン向けに最適化されたバイナリ転送スタックへと積極的に移行しつつあります。
ここで効いてくるのが gRPC と Protocol Buffers(Protobuf)です。大きな JSON ペイロードや、頻繁で冗長な HTTP リクエストに頼る代わりに、gRPC は高性能なマシン間通信に特化したコンパクトなバイナリ メッセージを利用します。バイナリ シリアル化ではデータ構造をバイト単位で密にパックするため、ペイロード サイズを大幅に削減できます。JSON と比べて、多くの場合 1 桁小さくなります。
ペイロード サイズが小さくなれば、そのまま CPU 負荷も下がります。冗長なテキスト ドキュメントを解析するのと比べると、バイナリの Protobuf データの解析に必要な計算量はごくわずかです。さらに gRPC はネイティブに HTTP/2 上で動作するため、1 本の TCP 接続で複数のストリームを多重化できます。これにより接続確立の遅延が大幅に減り、不要なネットワーク ホップも排除されます。
プロトコル ネイティブなアーキテクチャへ移行する大きな利点は、スキーマ優先の通信が可能になることです。従来の REST 統合では、ドキュメント化されていないフィールドの変更や欠落したパラメーターが、実行時に依存するワークフローを壊すという「インターフェイスのずれ」に悩まされることがよくあります。gRPC はコンパイル済みの Protobuf 定義による厳密に型付けされたコントラクトを強制します。クライアントとサーバーは、デプロイの前に正確なデータ形状について合意するため、この種の統合バグを根本から排除し、分散したエンタープライズ境界をまたいでコントラクトの忠実性を確実に保てます。
ポーリングに別れを告げる: 永続ストリームとリアルタイム転送
従来のマネージド コネクタは、根本的に古いアーキテクチャ上の前提に基づいています。それは、エンタープライズの作業は常に、個別かつ受動的なリクエストから始まるという前提です。しかし、リアルタイムのエンタープライズ AI やイベント駆動型の即時自動化が当たり前になった現在では、システムが更新を確認するためにポーリングを行うのを待つことは、受け入れがたい遅延と帯域の無駄を生みます。
大規模システムにとって、ポーリングから永続ストリーミング プロトコルへの移行は、もはや任意の選択肢ではありません。WebSocket、HTTP/3、QUIC、WebTransport といった技術を使えば、双方向の永続的な通信チャネルを維持でき、イベントが発生した瞬間にデータを即座にプッシュできます。
ポーリングは、ネットワーク インターフェイスを飽和させ、コンピューティング リソースを消耗させる大量の空のトラフィックを生み出します。一方、永続ストリーミング モデルでは、最小限のプロトコル オーバーヘッドでコンテキストが継続的に流れる、開かれた接続を維持します。さらに QUIC のような最新のトランスポート プロトコルは、Head-of-Line ブロッキングといった主要なネットワークのボトルネックを解消します。これにより、1 つのストリームでのパケット損失が、無関係なデータ転送を停滞させることがありません。
永続的なイベント駆動型トランスポートへ移行することで、組織はグローバル規模で100ミリ秒未満のイベント配信を実現できます。この機能は、状態を同期するために定期的なポーリング間隔を待つことなく、即時のコンテキスト伝播を必要とする、最新の分散型ワークフォースやリアルタイムAIエージェントを支えるうえで特に重要です。
回復力の構築:非同期キューとフォールトトレラントなアーキテクチャ
堅牢なフォールトトレランスを備えずに構築された高速なシステムは、必ず高速な障害発生装置になります。同期型のコネクタベースの統合チェーンに内在する最も危険な設計上の欠陥の一つは、すべての下流サービス、データベース、サードパーティ製SaaS APIが常に利用可能であり続けるという、根拠のない前提です。
実際のエンタープライズ環境では、分散システムには、部分的な障害、一時的なネットワーク分断、データベースのローリングメンテナンス、突発的なトラフィックの集中が絶えず発生します。統合ワークフローが同期チェーンで密結合されていると、周辺の一つのサービスで一時的に処理が遅くなるだけで、バックプレッシャーが上流へと連鎖し、基幹業務アプリケーションが停止してしまいます。
非同期の回復力パターンは、取り込み速度と処理速度を切り離すことで、この脆弱性を解消します。サービス境界の間に、Azure Service Bus、RabbitMQ、Amazon SQSなどの永続性のあるメッセージキューやイベントブローカーを導入することで、変動に対する堅牢なバッファーを構築できます。
バーストトラフィックが統合レイヤーに到達しても、受信したイベントは安全に取り込まれ、永続ストレージに保持されます。不安定な下流の依存関係に対して即時の同期処理を強いることはありません。下流のコンシューマーは、持続可能で制御されたレートでキューからメッセージを取り出します。バックエンドサービスがメンテナンスで停止した場合でも、キューは復旧するまでデータを安全に保持します。これによりデータ損失を防ぎ、壊滅的な連鎖障害を排除し、極端な負荷下でもエンタープライズアーキテクチャの回復力を維持できます。
実行ランタイムの転換:組み込みコネクタによる主権の取り戻し
ネットワークプロトコルやキューイング戦略に加えて、エンタープライズアーキテクトは統合レイヤーの物理的な実行ランタイムを慎重に検証する必要があります。クラウド自動化において最も誤解されている側面の一つは、マネージドコネクタが実際にどこで実行されるかという点です。
多くの組織は、統合ロジックがAzure Logic Appsなどのエンタープライズクラウドサブスクリプション内でホストされているため、すべてのデータ処理は信頼されたネットワーク境界内に安全に隔離されていると考えています。しかし、多くの従来型マネージドコネクタは、仮想ネットワーク(VNet)の外側にある、マルチテナントの共有インフラストラクチャ上で動作する外部のSaaS統合として稼働しています。
このアーキテクチャ上の現実は、深刻なセキュリティとゼロトラスト準拠の脆弱性を生み出します。機密性の高い社内データがプライベートネットワークの境界を離れ、サードパーティのマネージドミドルウェアで処理されると、トランスポート層での直接的な制御を手放すことになります。このギャップを埋めるために、組織はオンプレミスデータゲートウェイに頼ることが多いのですが、それはしばしば大規模なエンタープライズのボトルネックや単一障害点になってしまいます。
解決策は、組み込みコネクタと分離された実行モデルへの戦略的なランタイムの転換にあります。専用のApp Service環境やコンテナ化されたランタイム上で動作するAzure Logic Apps Standardなどが該当します。組み込みコネクタは、自社のコンピューティングランタイムとVNet境界の内部で直接実行されます。これにより外部のSaaS経由の通信がなくなり、レイテンシが大幅に削減され、厳格なゼロトラスト準拠の要件を満たすとともに、エンタープライズデータパイプラインに対するアーキテクチャ上の主権を完全に取り戻せます。
結論:AI時代における回復力のあるスケールの設計
統合を低コードの後付け作業として扱う時代は、正式に終わりました。企業が高度なAIモデル、自律型エージェント、リアルタイムデータパイプラインの展開を急ぐなか、従来型マネージドコネクタを支えてきた脆弱なトランスポートモデルは、その圧力に耐えられなくなりつつあります。ミドルウェアの摩擦、目に見えないレイテンシのコスト、スロットリングのボトルネック、安全でない共有ランタイムは、もはや小さな不便ではなく、システムの安定性を損ない、デジタルイノベーションを停滞させる重大なビジネスリスクです。
将来に向けて構築するには、考え方の根本的な転換が必要です。チャットのような REST ポーリング、かさばる JSON ペイロード、中身の見えないマネージド ミドルウェアから離れ、代わりにプロトコルネイティブな設計、gRPC によるバイナリ シリアル化、永続的なリアルタイム ストリーミング、キューを前段に置いた非同期の回復性、そして厳格なランタイムの主権を重視する方向へ舵を切る必要があります。
これらのアーキテクチャの転換をさらに深く掘り下げ、実践的な設計パターンを確認し、現代の人工知能の要求に備えて統合戦略を将来にわたって通用するものにする方法を学ぶには、関連するポッドキャスト エピソードをぜひお聴きください: Custom Connectors vs Model Context Protocol for Enterprise AI。エンタープライズのトランスポート層に対する制御を取り戻すことは、真に回復性とスケーラビリティに優れた自動化システムを構築するうえで、最も重要な一歩です。