 HE
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 日本語
 한국어
חשיפת מיתוס זמן ההשהיה: תהליך מקומי לעומת HTTP ארגוני
By Mirko Peters ·
ברוכים השבים לסדרת הצלילות הטכניות שלנו לעומק בתחום ארכיטקטורת ארגונים ותכנון מערכות מודרניות. בפוסט הזה נרחיב על נושא שמעורר לא מעט ויכוחים בקרב מהנדסי תוכנה וארכיטקטים של מערכות: טבעו האמיתי של זמן ההשהיה ביישומים מבוזרים לעומת תהליכים מקומיים. כשמתכננים מערכות עם תפוקה גבוהה, במיוחד כאלה שמגשרות בין עוזרי AI שרצים על שולחן העבודה לבין פלטפורמות נתונים בענן בצד השרת, מפתחים נופלים לא פעם למלכודת
Automatically translated with AI from the original post. Read the English original
ברוכים השבים לסדרת הצלילות הטכניות שלנו לעומק בתחום ארכיטקטורת ארגונים ותכנון מערכות מודרניות. בפוסט הזה נרחיב על נושא שמעורר לא מעט ויכוחים בקרב מהנדסי תוכנה וארכיטקטים של מערכות: טבעו האמיתי של זמן ההשהיה ביישומים מבוזרים לעומת תהליכים מקומיים. כשמתכננים מערכות עם תפוקה גבוהה, במיוחד כאלה שמגשרות בין עוזרי AI שרצים על שולחן העבודה לבין פלטפורמות נתונים בענן בצד השרת, מפתחים נופלים לא פעם למלכודת של מבחני ביצועים מיקרוסקופיים. הם מסתכלים על מהירויות תעבורה גולמיות ומניחים שתקשורת בין-תהליכים מקומית עדיפה תמיד על HTTP ארגוני שעובר ברשת. אבל כפי שנראה במאמר הזה, ההנחה הזו היא מיתוס.
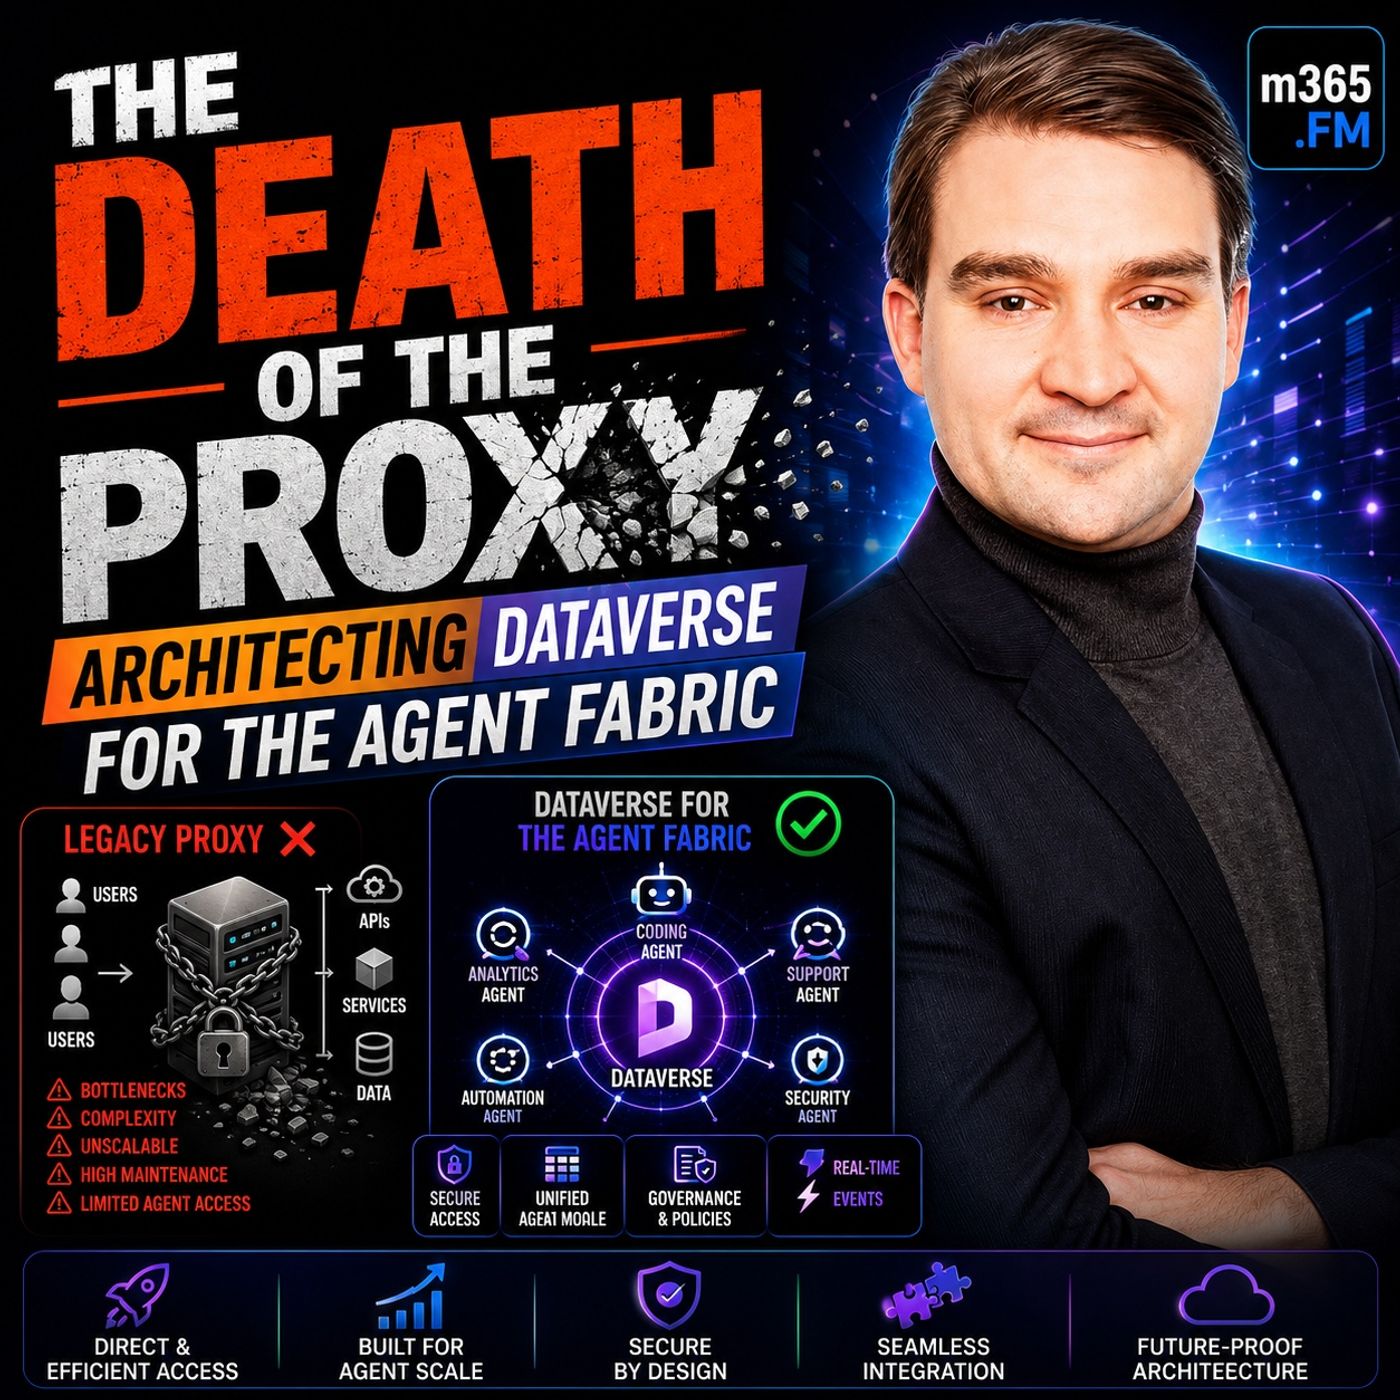
הדיון הזה קשור ישירות לשיחה שקיימנו בפודקאסט האחרון שלנו. אם עוד לא האזנתם לו, כדאי להציץ ב-THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric, שבו אנחנו מפרקים איך ארכיטקטורות מודרניות עוברות מפרוקסי מקומיים שבריריים לנקודות קצה של HTTP ארגוני חזקות וניתנות להרחבה.
מבוא למיתוס זמן ההשהיה בבינה מלאכותית ארגונית
התפתחות תוכנה ארגונית אילצה אותנו לבחון מחדש את הדרך שבה מטפלים בתקשורת בין לקוחות לבין מערכות שירות. בשום מקום זה לא בולט יותר מאשר בארכיטקטורה של שילוב בינה מלאכותית ארגונית. במשך שנים, כלים מקומיים כמו פרוקסי מסוג STDIO היו ההמלצה המועדפת לחיבור יישומי שולחן עבודה למסדי נתונים בענן. הם היו פשוטים להתקנה, דרשו תשתית מינימלית, ונראו מיידיים בבדיקות מקומיות.
עם זאת, כשארגונים עוברים מניסויים מבודדים של מפתחים לפריסות ברחבי הארגון שכוללות מאות או אלפי סוכני AI, ההנחות המקומיות האלה מתחילות להיסדק. מהנדסים שמגנים על תהליכים מקומיים נוטים להצביע על זמן השהיה בתעבורה כגורם המכריע. הם טוענים ש-HTTP מוסיף עומס רשת, לחיצות יד של TCP ומשא ומתן TLS, בעוד שצנרת מקומית פועלת תוך מיקרושניות בלבד. אלא שהטענה הזו נשענת על אי-הבנה יסודית לגבי המקום שבו הזמן באמת נשרף בעסקה ארגונית אמיתית. כדי להבין ביצועים באמת, צריך להסתכל מעבר לשכבת התעבורה ולבחון את עומס העבודה במלואו.
מבדקים מיקרוסקופיים לעומת עומסי עבודה ארגוניים בעולם האמיתי
מבדקים מיקרוסקופיים מטעים בדרך כלל. בסביבת בדיקה מבודדת, מדידת הזמן הגולמי שלוקח להעביר מטען JSON דרך צנרת STDIO מקומית לעומת ממשק לולאה חוזרת של HTTP כמעט תמיד תעדיף את התהליך המקומי. המספרים נראים חד-משמעיים: מילישניות בודדות לצנרות מקומיות לעומת עשרות מילישניות ללולאות רשת.
הבעיה היא שמבדקים מיקרוסקופיים מסירים מהתמונה את המציאות של הרצת תוכנה ארגונית. כשסוכן AI מבקש נתונים מפלטפורמה חזקה כמו Dataverse, מנגנון התעבורה הוא רק חלק קטן מהמשוואה. מאחורי נקודת הקצה הזו עומדת שרשרת מורכבת של פעולות:
- אימות זהות ובדיקת טוקנים באמצעות Microsoft Entra ID
- בקרת גישה מבוססת תפקידים (RBAC) ובדיקות גבולות אבטחה
- הרצת לוגיקה עסקית מורכבת, תוספים ותהליכי עבודה מותאמים אישית
- קומפילציה של שאילתות במסד נתונים, הערכת אינדקסים ושליפה פיזית של נתונים
- סריאליזציה ודה-סריאליזציה של מודלים נתונים ארגוניים עשירים
כשהשאילתה במסד הנתונים והלוגיקה העסקית לוקחות שלוש מאות מילישניות להתבצע, חיסכון של ארבע מילישניות בתקורת התעבורה הוא זניח לחלוטין. צוואר הבקבוק אף פעם אינו הרשת; הוא החישוב הנדרש כדי למלא את הבקשה העסקית. כשארכיטקטים ממטבים את שכבת התעבורה ומתעלמים ממשקל התפעולי של הלוגיקה בצד השרת, הם ממטבים את החלק הלא נכון של הערימה.
העלות האמיתית של תקורת התעבורה
למרות שתקשורת בין-תהליכים מקומית מתהדרת במהירות תיאורטית מרשימה, היא מסתירה כמות אדירה של תקורה תפעולית ותשתיתית שמצטברת בקנה מידה. כדאי לשים לב למה שקורה כשכל משתמש מריץ תהליך מקומי משלו כדי לחבר לקוח AI לשירות בענן.
כל מופע בודד של פרוקסי מקומי גורר עלות הפעלה משלו, תקורת אתחול תהליך משלו ומחזור חיים אימות מבודד משלו. יתרה מכך, כל תהליך מקומי צריך לנהל באופן עצמאי את החיבורים, פרטי האבטחה ומצבי השגיאה שלו. אם לארגון יש חמש מאות מפתחים או סוכנים אוטומטיים שמריצים פרוקסי מקומיים, המשמעות היא חמש מאות צינורות חיבור נפרדים שמנסים להתמודד מול משאבי הקצה.
בהשוואה לנקודת קצה HTTP ארגונית שהוגדרה כראוי, העלויות הנסתרות של המודל המקומי בולטות מאוד. תהליכים מקומיים לא יכולים בקלות לשתף מצב, לשמור במטמון לחיצות ידיים של חיבורים באופן גלובלי, או לאגד משאבים ביעילות בין יישומי לקוח שונים. המהירות הנתפסת של תהליך מקומי היא אשליה שמתפרקת ברגע שמתחילים להיתקל בריבוי בקשות במקביל ובפיצול המערכת.
איך איגום חיבורים מנצח במירוץ הביצועים
כאן HTTP ארגוני משנה באופן דרמטי את תמונת הביצועים. בניגוד לתהליכים מקומיים זמניים שעולים ונסגרים שוב ושוב עם כל חיבור, שירותי HTTP ברמת ייצור מסתמכים על איגום חיבורים מתוחכם, סשנים מתמידים ותשתיות שרת ארוכות טווח.
כשלקוח HTTP ארגוני מתחבר לשירות משותף, עלויות ההתחברות הראשוניות – כמו חיפוש DNS, slow-start של TCP ומשא ומתן TLS – מתרחשות פעם אחת בלבד. בקשות הבאות עושות שימוש בחיבורים קיימים ומתמידים. יתרה מכך, מכיוון שהחיבורים הללו מאוגדים ומנוהלים על ידי שכבת שירות מרכזית, המערכת יכולה לשמור על חיבורי מסד נתונים חמים, סשנים שכבר אומתו מראש ומטא-דאטה של סכמות שנשמרה במטמון.
בסביבה ארגונית שמכוונת כראוי, האופטימיזציות הללו משמעותן שזרם מתמשך של בקשות HTTP יכול להשיג זמן השהיה ממוצע כולל נמוך יותר מאשר קונסטלציה מפוזרת של תהליכים מקומיים לא מתואמים. עלות הרשת מתפזרת על פני אלפי עסקאות מתמידות ומהירות מאוד, וההשהיה הראשונית בהעברה הופכת לחסרת משמעות לחלוטין.
התרחבות של HTTP ארגוני לעומת תקורת תהליכים מקומיים
התרחבות היא המבחן האולטימטיבי של עקרונות התכנון של ארכיטקטורת תוכנה. כשארגון עובר מתמיכה בקומץ עוזרי מפתחים לפריסה של מערכת אקולוגית מקיפה של כלי AI – כולל GitHub Copilot, Claude Code, מתזמרים מותאמים אישית ו-Copilot CLI פנימיים – המציאות התפעולית של תהליכים מקומיים הופכת לבלתי בת-קיימא.
ניהול מאות תהליכי פרוקסי מנותקים מוביל לסחף ניהולי חמור. אין נראות מרכזית, הניטור מפוצל, ופתרון תקלות לסירוגין על פני מכונות מקומיות מפוזרות הוא סיוט עבור מנהלי IT. ממשל אבטחה הופך לאוסף של תצורות מקומיות ולא למדיניות אחידה וניתנת לאכיפה.
לעומת זאת, התרחבות של ארכיטקטורת HTTP ארגונית היא לינארית וצפויה. במקום להכפיל תשתית על גבי כל תחנת עבודה של משתמש, הארגונים מרחיבים שירות יחיד וזמין מאוד מאחורי מאזן עומסים ארגוני. כשהביקוש גדל, פשוט מעלים מופעי שרת נוספים. הלקוחות ממשיכים לתקשר עם אותה נקודת קצה מנוהלת, בעוד הפלטפורמה מטפלת בהתרחבות אופקית, בחלוקת עומסים ובטלמטריה באופן שקוף. מנגנוני אבטחה כמו PKCE (Proof Key for Code Exchange) מאפשרים ללקוחות שולחן עבודה ציבוריים להתאמת באופן מאובטח מבלי לאחסן סודות קשיחים בקוד, ובכך משלבים ממשל ארגוני איתן עם חוויית פיתוח חלקה.
סיכום: מתן עדיפות ללוגיקה עסקית על פני מיקרו-אופטימיזציות
המשיכה המתמשכת לתקשורת תהליכים מקומית היא דוגמה קלאסית לאופן שבו מיקרו-אופטימיזציה מסנוורת ארכיטקטים מפני המציאות המאקרו. בעוד שצינורות מקומיים עשויים לנצח במדד סינתטי בכמה מילישניות, הם מכניסים מורכבות תפעולית עצומה, מפררים את האבטחה הארגונית ואינם מתרחבים בצורה תקינה בסביבות מונעות AI מודרניות. על ידי העברת המיקוד משכבת התעבורה לארכיטקטורות HTTP ארגוניות איתנות ומאוגדות חיבורים, אנו בונים מערכות שהן מאובטחות, ניתנות להרחבה וערוכות באמת לדרישות של הארגון המודרני.
כדי להבין לעומק איך פלטפורמות כמו Dataverse מתפתחות ומשמשות כשכבת הנתונים המאוחדת של כל ה-agent fabric, מומלץ להאזין לפרק המלא: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric. תודה שקראתם, והישארו מעודכנים לעוד העמקות בארכיטקטורת ענן ארגונית!