 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
遅延の神話を検証する:ローカルプロセスとエンタープライズ HTTP の比較
By Mirko Peters ·
企業アーキテクチャと最新のシステム設計に関する技術解説シリーズへ、ようこそお戻りください。今回は、ソフトウェアエンジニアやシステムアーキテクトの間でしばしば議論になるテーマを掘り下げます。それは、分散アプリケーションとローカルプロセスにおける遅延の本当の姿です。特に、デスクトップの AI アシスタントとバックエンドのクラウドデータプラットフォームを橋渡しするような高スループットのシステムを設計する際、開発者はマイクロベンチマークの罠に陥りがちです。生の転送速度だけを見て、ローカルのプロセス間通信がネットワーク経由のエンタープライズ HTTP より常に優れていると思い込んでしまうのです。しかし、この記事で検証するとおり、その前提は神話にすぎません。
Automatically translated with AI from the original post. Read the English original
ようこそお戻りください。企業アーキテクチャと最新のシステム設計に関する技術解説シリーズへ、今回も読んでいただきありがとうございます。この記事では、ソフトウェアエンジニアやシステムアーキテクトの間で議論になりやすいテーマを取り上げます。分散アプリケーションにおける遅延の本当の姿と、ローカルプロセスとの違いです。特に、デスクトップの AI アシスタントとバックエンドのクラウドデータプラットフォームをつなぐ高スループットのシステムを設計する場合、開発者はマイクロベンチマークの罠に陥りがちです。生の転送速度だけを見て、ローカルのプロセス間通信はネットワーク経由のエンタープライズ HTTP より優れていると考えてしまいます。しかし、この記事で検証するとおり、その前提は神話です。
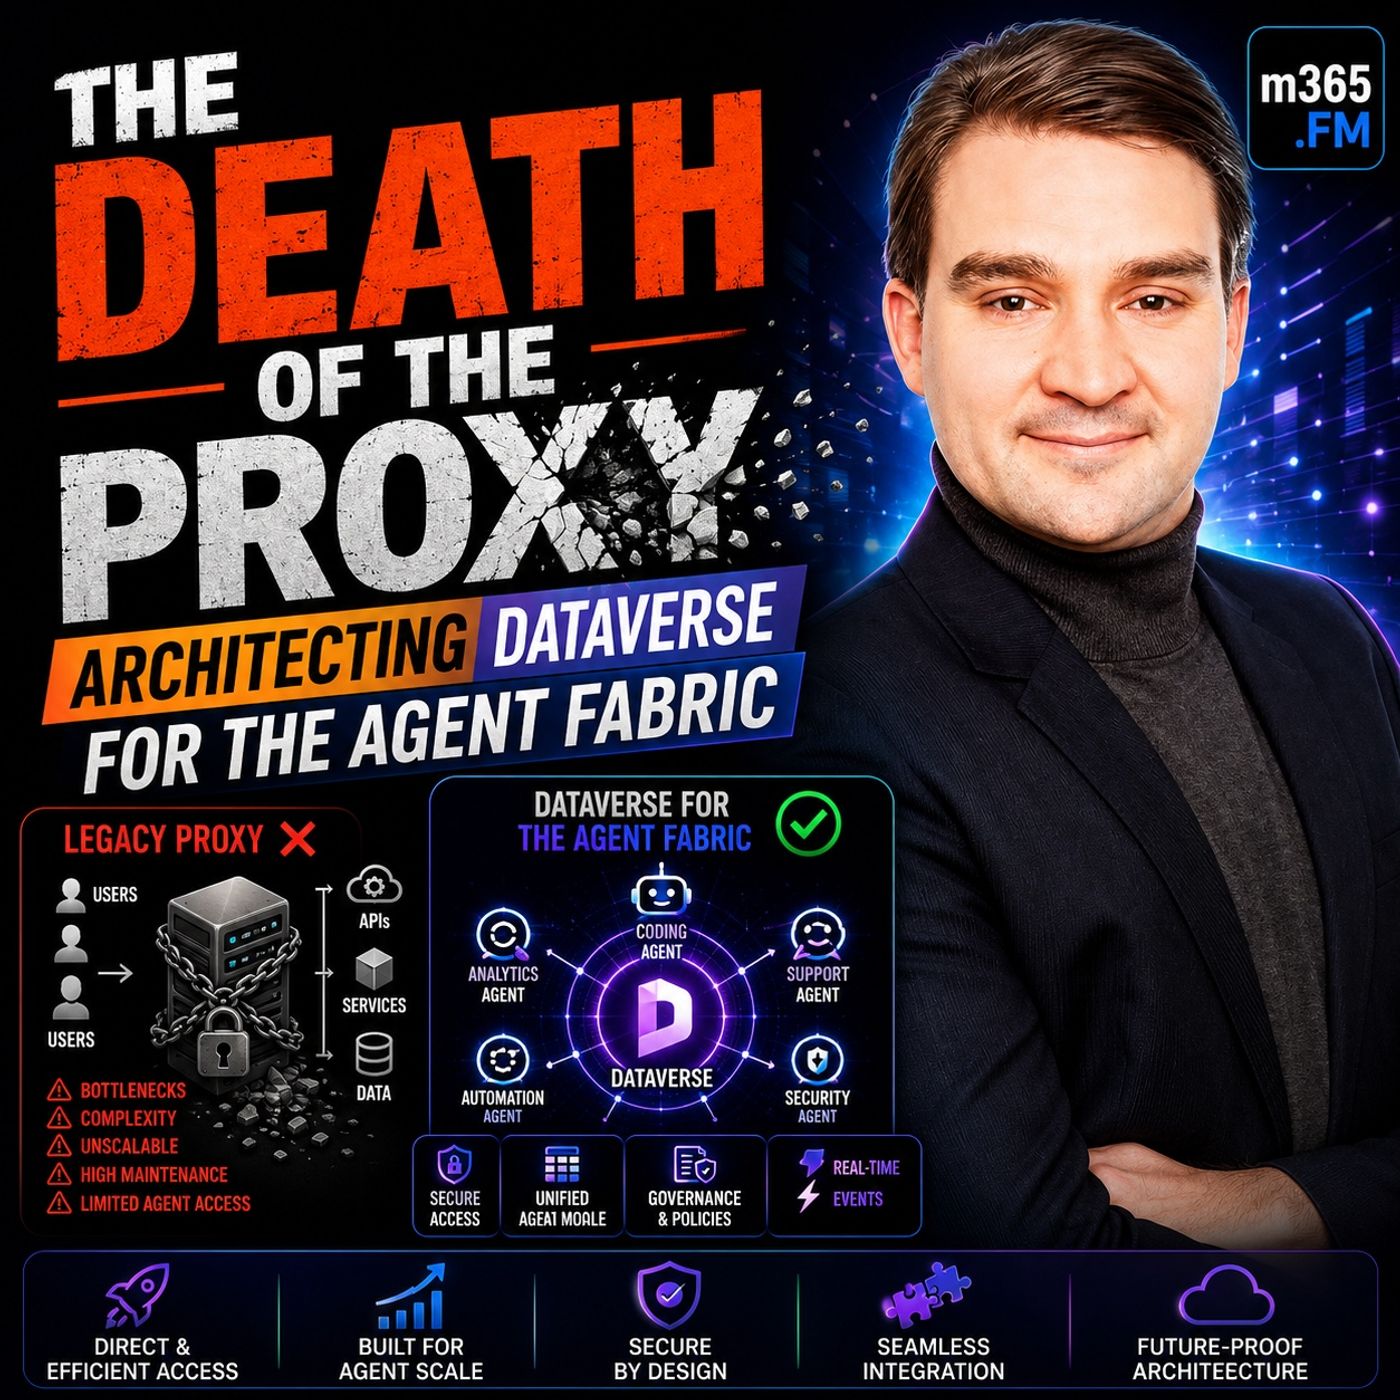
この議論は、先日のポッドキャストの内容と直接つながっています。まだお聴きでない方は、ぜひ THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric をご覧ください。壊れやすいローカルプロキシから、堅牢でスケーラブルなエンタープライズ HTTP エンドポイントへと、最新のアーキテクチャがどのように移行しているかを解説しています。
エンタープライズ AI における遅延の神話の紹介
エンタープライズソフトウェアの進化により、クライアントとバックエンドシステム間の通信方法を見直す必要が生じました。その影響が最も顕著に表れているのが、エンタープライズ AI 連携のアーキテクチャです。長年にわたり、デスクトップアプリケーションをクラウドデータベースに接続する際の定番の推奨策は、STDIO プロキシなどのローカルツールでした。導入は簡単で、必要なインフラも最小限で済み、ローカルでのテストでは即座に動作するように感じられたからです。
しかし、組織が開発者による個別の実験から、数百から数千の AI エージェントを使う全社規模の展開へと移行するにつれて、こうしたローカル前提は崩れ始めます。ローカルプロセスを擁護するエンジニアは、転送遅延こそが最終的な決め手だと指摘することがよくあります。HTTP にはネットワークのオーバーヘッド、TCP ハンドシェイク、TLS ネゴシエーションが伴う一方で、ローカルのパイプ通信はわずか数マイクロ秒で済むというのです。しかし、この主張は、実際のエンタープライズのトランザクションで時間がどこに費やされているかについての根本的な誤解に基づいています。性能を正しく理解するには、転送レイヤーの先を見て、ワークロード全体を総合的に検証する必要があります。
マイクロベンチマークと実際のエンタープライズワークロードの比較
マイクロベンチマークは誤解を招きやすいことで知られています。隔離されたテスト環境で、JSON ペイロードを ローカルの STDIO パイプ経由で渡す場合と、HTTP ループバックインターフェイス経由で渡す場合の生の所要時間を測定すると、ほぼ間違いなくローカルプロセスが有利になります。数値は明白に見えます。ローカルパイプは一桁ミリ秒、ネットワークループは二桁ミリ秒です。
問題は、マイクロベンチマークがエンタープライズソフトウェアの実際の実行環境を無視している点にあります。AI エージェントが Dataverse のような堅牢なプラットフォームにデータを要求する場合、転送の仕組みは全体のごく一部にすぎません。そのエンドポイントの背後には、次のような複雑な処理の連鎖があります。
- Microsoft Entra ID によるアイデンティティの検証とトークンの検証
- ロールベースのアクセス制御(RBAC)とセキュリティ境界のチェック
- プラグイン、カスタムワークフローを含む複雑なビジネスロジックの実行
- データベースクエリのコンパイル、インデックスの評価、物理的なデータ取得
- 豊富なエンタープライズデータモデルのシリアル化とデシリアル化
データベースクエリとビジネスロジックの実行に 300 ミリ秒かかっている場合、転送のオーバーヘッドを 4 ミリ秒削っても、ほとんど意味がありません。ボトルネックがネットワーク上にあることはなく、業務要求を処理するための計算処理にあります。バックエンドロジックの運用上の負荷を無視して転送レイヤーを最適化するアーキテクトは、スタックの間違った部分を最適化していることになります。
転送オーバーヘッドの本当のコスト
ローカルプロセス間の通信は理論上の速度こそ印象的ですが、規模が大きくなるほど積み重なる、膨大な運用面とインフラ面のオーバーヘッドを隠しています。すべてのユーザーが、AI クライアントとクラウドサービスをつなぐために、それぞれ独自のローカルプロセスを実行する場合に何が起きるかを考えてみてください。
ローカルプロキシを1つ動かすたびに、起動コスト、プロセス初期化のオーバーヘッド、独立した認証のライフサイクルが発生します。さらに、ローカルプロセスごとに接続、セキュリティ資格情報、エラー状態をそれぞれ個別に管理しなければなりません。組織に500人の開発者や自動化エージェントがいてそれぞれがローカルプロキシを動かしていると、バックエンドリソースとの接続を試みるパイプラインが500本も別々に存在することになります。
適切に構成されたエンタープライズ向け HTTP エンドポイントと比べると、ローカルモデルの隠れたコストが際立ちます。ローカルプロセスは状態を共有したり、接続のハンドシェイクをグローバルにキャッシュしたり、異なるクライアントアプリケーション間でリソースを効率よくプールしたりすることが容易ではありません。ローカルプロセスの速さは、同時実行性とシステムの断片化が問題になった瞬間に崩れる幻想にすぎません。
接続プーリングがパフォーマンス競争で勝つ仕組み
ここで、エンタープライズ向け HTTP がパフォーマンスの評価を大きく変えます。接続の起動と破棄を繰り返す短命なローカルプロセスとは異なり、本番環境の HTTP サービスは、高度な接続プーリング、永続セッション、長時間稼働するサーバー基盤を活用します。
エンタープライズ向け HTTP クライアントが共有サービスに接続する場合、DNS 参照、TCP スロースタート、TLS ネゴシエーションといった初期ハンドシェイクのコストは一度だけ発生します。その後のリクエストは、確立された永続接続を使って処理されます。さらに、これらの接続は中央のサービス層で管理・プールされるため、システムはウォーム状態のデータベース接続、事前認証済みのセッション、キャッシュされたメタデータスキーマを維持できます。
適切にチューニングされたエンタープライズ環境では、これらの最適化により、持続的に送られる HTTP リクエストは、調整されていない多数のローカルプロセスよりも低いエンドツーエンドの平均レイテンシーを実現できます。ネットワークのオーバーヘッドは何千もの高速な永続トランザクションに分散されるため、最初の転送コストはほぼ問題になりません。
エンタープライズ HTTP のスケーリングとローカルプロセスのオーバーヘッド
ソフトウェアアーキテクチャのスケーリングは、その設計原則の究極のテストです。企業が数人の開発者アシスタントを支えるところから、GitHub Copilot、Claude Code、カスタムオーケストレーター、社内の Copilot CLI を含む包括的な AI ツール群を展開する段階に進むと、ローカルプロセスの運用は現実的に持続不可能になります。
数百の切り離されたプロキシプロセスを管理すると、深刻な運用上のずれが生じます。一元的な可視性がなく、監視は分断され、異なるローカルマシン間で断続的に発生する障害を調査することは、IT 管理者にとって悪夢になります。セキュリティガバナンスは、統一された強制力のあるポリシーではなく、ローカル構成のつぎはぎになってしまいます。
一方、エンタープライズ HTTP アーキテクチャのスケーリングは線形で予測可能です。組織はすべてのユーザー端末にインフラを複製するのではなく、エンタープライズ ロード バランサーの背後で稼働する、高可用性の単一サービスをスケールさせます。需要が増えたら、サーバーインスタンスを追加するだけです。クライアントは同じ管理されたエンドポイントと通信を続け、プラットフォームが水平スケーリング、負荷分散、テレメトリを透過的に処理します。PKCE(Proof Key for Code Exchange)などのセキュリティ機能により、パブリックなデスクトップクライアントは、ハードコードされたシークレットを保存せずに安全に認証できます。堅牢なエンタープライズガバナンスと、開発者にとっての快適な使い勝手を両立させられるのです。
結論: マイクロ最適化よりビジネスロジックを優先する
ローカルプロセス通信が根強く支持されているのは、マイクロ最適化がアーキテクトをマクロな現実から目隠しする典型例です。ローカルのパイプは合成ベンチマークで数ミリ秒の差をつけて勝つかもしれませんが、運用上の複雑さを大きく生み、エンタープライズのセキュリティを分断し、現代の AI 主導の環境では円滑にスケールしません。トランスポート層からではなく、堅牢で接続プーリングされたエンタープライズ HTTP アーキテクチャに注目を移すことで、安全でスケーラブルな、現代のエンタープライズの要求に本当に応えられるシステムを構築できます。
Dataverse などのプラットフォームが、エージェントファブリック全体を支える統合データ基盤としてどのように進化しているのかを詳しく知りたい方は、エピソード全編をお聴きください: THE DEATH OF THE PROXY: Architecting Dataverse for the Agent Fabric。ご覧いただきありがとうございます。エンタープライズ クラウド アーキテクチャについての詳しい解説も、引き続きお楽しみに。