 IT
 English
 Deutsch
 Español
 Français
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Governare i dati in un lakehouse di Microsoft Fabric: architettura senza perdere il sonno
By Mirko Peters · · Updated
Governa i dati in un'architettura lakehouse di Microsoft Fabric senza perdere il sonno. Semplifica l'analisi con una soluzione solida e gestibile.
Automatically translated with AI from the original post. Read the English original
Conosci quel momento imbarazzante in cui qualcuno, durante una riunione, chiede: «Possiamo dimostrare da dove arriva questo numero?» e la sala ammutolisce? Ho visto quel silenzio prolungarsi in aziende che avevano «tutti i dati», ma nessuna prova a supporto. I lakehouse promettono un'unica piattaforma per tutto (tabelle strutturate, file disordinati, flussi in tempo reale, feature per il machine learning), ma la promessa regge solo se riesci a governarla senza paralizzare i tuoi team. Questo articolo si basa in larga parte sullo studio di ottobre 2024 di Stallion Journal, «Data Governance in Lakehouse» (Shah & Jain), e aggiunge lo strato umano: le scorciatoie a cui sarai tentato di ricorrere, le dinamiche politiche con cui ti scontrerai e le semplici abitudini che ti tengono lontano dal panico provocato dagli audit.
8 fatti sorprendenti su come governare un lakehouse di Microsoft Fabric- Governance unificata tra gli artefatti: la governance di Fabric si applica in modo uniforme alle tabelle e ai file del lakehouse, ai notebook, alle pipeline e alle dashboard, consentendo criteri centralizzati che coprono sia i dati sia gli artefatti analitici.
- Acquisizione automatica del lignaggio: il lignaggio viene acquisito automaticamente per molte operazioni (acquisizione, trasformazioni, notebook e dashboard), offrendo una visibilità quasi in tempo reale sulla provenienza dei dati senza strumentazione aggiuntiva.
- Integrazione della sicurezza a livello di riga e di colonna: il lakehouse supporta controlli di accesso granulari (a livello di riga e di colonna) applicati al momento della query, così l'accesso governato segue i dati indipendentemente dal motore di consumo.
- Classificazione dei dati ed etichette di riservatezza integrate: Fabric mostra la classificazione dei dati (tipi di informazioni sensibili) e si integra con le etichette di riservatezza di Microsoft Purview, così la governance può usare le classificazioni rilevate per applicare i criteri.
- Policy-as-code per i controlli del ciclo di vita: i criteri di governance (conservazione, gate di qualità, crittografia, calcolo consentito) possono essere definiti e applicati in modo programmatico, abilitando un'applicazione automatizzata lungo tutto il ciclo di vita del lakehouse.
- Isolamento di tenant e aree di lavoro senza attriti: il modello di governance di Fabric supporta l'isolamento tra più aree di lavoro e criteri consapevoli del tenant, così puoi limitare la condivisione e lo spostamento dei dati tra progetti continuando a consentire una collaborazione governata.
- Log di modifiche e accessi verificabili: tutte le operazioni rilevanti per la governance (letture e scritture dei dati, modifiche ai criteri, assegnazioni di ruoli) sono verificabili e producono log che si integrano con Microsoft Sentinel e con i SIEM per il monitoraggio della conformità.
- Contratti sui dati abilitati dalla governance: Fabric consente di creare contratti sui dati e schemi con controlli di compatibilità applicati, così i consumatori ottengono interfacce stabili e governate verso i dati del lakehouse, e i produttori possono evolvere in sicurezza.
1) Il problema della «riunione silenziosa»: perché i lakehouse hanno bisogno di governance
Sei in una revisione con la direzione. Sullo schermo compare un KPI (retention dei ricavi, tempo di attesa dei pazienti, rischio di abbandono dei clienti). Qualcuno chiede: «Da dove arriva questo numero?» Cala il silenzio. Non riesci a risalire al dataset, alla trasformazione o a chi ha modificato la logica la settimana scorsa. In quel momento non hai un problema di analisi: hai un problema di affidabilità dei dati.
Lakehouse in parole semplici: un unico tetto, due promesse
Un lakehouse è una combinazione pratica: la flessibilità del data lake (archiviare qualsiasi cosa, rapidamente) più l'affidabilità del data warehouse (tabelle coerenti, prestazioni solide). Sotto un unico tetto puoi gestire dati strutturati e non strutturati, eseguire analisi in tempo reale e supportare carichi di lavoro di machine learning. Proprio questo valore «tutto in uno» è il motivo per cui la tua strategia di architettura lakehouse deve includere la governance fin dal primo giorno.
Perché i lakehouse aumentano le esigenze di governance dei dati del lakehouse
I lakehouse si muovono velocemente: flussi di streaming, riaddestramenti frequenti dei modelli e molti team che pubblicano dashboard contemporaneamente. Questa velocità moltiplica i rischi. Tipi di dati misti e molti strumenti rendono più facile perdere il controllo su definizioni, autorizzazioni e lignaggio. Quando non sei in grado di spiegare una metrica, gli stakeholder smettono di fidarsi della dashboard, anche se il numero è corretto.
- I dati in tempo reale aumentano la probabilità di snapshot incoerenti e di KPI «in movimento».
- Le pipeline di ML aggiungono nuovi asset da governare: feature, set di addestramento, output dei modelli e segnali di deriva.
- Più utenti (analisti, data scientist, team di prodotto) significano più percorsi di accesso e più modi per violare i criteri.
La governance non è burocrazia: è ciò che ti permette di rilasciare in sicurezza
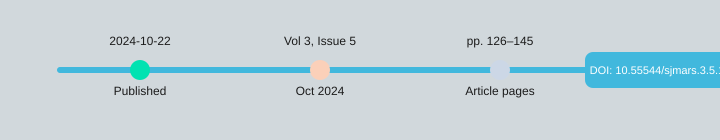
Lo studio peer-reviewed "Data Governance in Lakehouse" della rivista Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), pubblicato il 22-10-2024 nel Volume 3, Issue 5 (pp. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), inquadra la governance sia come necessità strategica sia come requisito operativo imprescindibile. Il messaggio è semplice: la governance ti protegge sul fronte della conformità (GDPR, HIPAA, CCPA), riduce i rischi e mantiene alta la qualità dei dati e la fiducia degli stakeholder.
Samarth Shah: "In un lakehouse, la velocità senza governance non è agilità: è solo confusione più veloce."
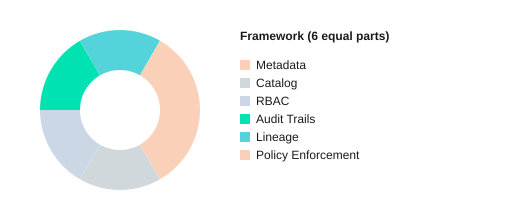
In pratica, la governance dei dati nel lakehouse significa poter rispondere a "cos'è questo KPI?" con delle prove: metadati, voci di catalogo, controlli di accesso (come RBAC), audit trail e lineage. Non è burocrazia inutile. È il sistema che ti permette di fornire analytics rapidamente, senza violare le leggi né la fiducia.
| Elemento dei metadati | Valore |
|---|---|
| Data di pubblicazione | 22-10-2024 |
| Numero della rivista | Volume 3, Issue 5 (ott 2024) |
| Pagine | 126–145 |
| ISSN | 2583-3340 |
2) Come appare una "buona governance" quando i dati sono ovunque
In un lakehouse, i dati non sono "in un unico posto". Sono distribuiti tra tabelle, file, stream e feature di ML, spesso su piattaforme come AWS, Snowflake o Databricks. Una buona governance è ciò che ti permette di mantenerli utilizzabili e sicuri senza rallentare i team. Pensala come guardrail, non cancelli: abiliti l'analytics in tempo reale rispettando le aspettative di GDPR, HIPAA e CCPA.
I 6 elementi costitutivi che implementerai davvero
- Governance basata sui metadati: definisci proprietari, riservatezza, conservazione e regole di qualità nei metadati, così i controlli scalano con il volume e con i cambiamenti.
- Best practice per il catalogo dei dati: un unico punto di ricerca per definizioni, tag e dataset affidabili, così le persone smettono di tirare a indovinare.
- Controllo degli accessi RBAC: i ruoli corrispondono alle esigenze di lavoro (analista, ingegnere, clinico), non ad autorizzazioni improvvisate.
- Tracciamento del lineage dei dati: mostra da dove provengono i dati, come sono cambiati e che cosa alimentano.
- Audit trail: chi ha acceduto a cosa, quando e che cosa ha fatto, elemento fondamentale per indagini e verifiche.
- Applicazione dei criteri: controlli automatici (mascheramento, conservazione, approvazioni) che vengono eseguiti per impostazione predefinita, non su richiesta.
Governance documentata vs. governance applicata (solo una previene gli incidenti)
La governance documentata è una pagina wiki che dice "i PII devono essere mascherati". La governance applicata è quando il tuo lakehouse maschera automaticamente i PII in base ai tag dei metadati, blocca le esportazioni rischiose e registra gli accessi negli audit trail. La ricerca alla base della governance moderna dei lakehouse dimostra che automazione e metadati riducono il tempo e gli errori della applicazione manuale, perché la piattaforma applica le regole in modo coerente.
Governance unificata quando gestisci tabelle, file, stream e feature
Ti serve un unico piano di controllo che funzioni su tabelle batch, file dell'object store, stream di tipo Kafka e set di feature di ML. Quando la governance è unificata, gli stessi controlli di accesso RBAC, tag e criteri seguono i dati, così dashboard, notebook e modelli restano allineati e conformi.
Piccola digressione: come "un dataset condiviso" diventa 12 versioni
Senza il tracciamento del lineage dei dati, un dataset "customer" viene copiato in customer_v2, customer_clean, customer_final e "final_final". Presto i team discutono sui numeri, perché nessuno riesce a dimostrare quale versione alimentava quale report.
Shubham Jain: "Il lineage fa la differenza tra 'credo che sia così' e 'posso dimostrarlo' quando qualcuno contesta i tuoi numeri."
Checklist di autovalutazione in 5 minuti
- Riesci a trovare nel catalogo il proprietario e il tag di riservatezza dei tuoi primi 10 dataset?
- Sono i ruoli (non i singoli utenti) a controllare gli accessi tramite RBAC?
- Riesci a risalire a fonti e lineage di un KPI in meno di 2 minuti?
- Gli audit trail rispondono oggi a "chi ha visualizzato/esportato questo"?
- I criteri vengono applicati automaticamente (mascheramento, conservazione, approvazioni), non manualmente?
Ogni controllo produce risultati concreti: meno incidenti di accesso (RBAC + criteri), audit più rapidi (audit trail + catalogo) e analisi più pulite (metadati + lineage).
3) I numeri che fanno sembrare la governance meno un "costo generale"
Se la governance ti sembra «processo in più», i risultati dello studio ti aiutano a riformularla come un guadagno operativo misurabile. Quando applichi governance basata sui metadati con automazione e ML in un lakehouse, non stai solo «aggiungendo controlli»: stai recuperando tempo, migliorando la fiducia nei dati e riducendo il rischio di conformità in modi che un CFO può monitorare.
Governance basata sui metadati: il ROI da mettere in una slide
Lo studio riporta tre risultati principali quando i team si affidano a metadati solidi, catalogazione, lineage e controlli di accesso:
- Fino al 40% di miglioramento dell'efficienza della governance
- Aumento del 35% della qualità dei dati
- Tassi di conformità GDPR HIPAA del 92% raggiunti (GDPR/HIPAA)
In termini pratici, quel 40% di efficienza si traduce spesso in meno revisioni manuali, meno cicli del tipo «chi è il proprietario di questo dataset?» e approvazioni più rapide per accesso e condivisione. Il tuo backlog si riduce perché i controlli di routine passano dalle persone ai sistemi, e la coda degli incidenti diminuisce perché meno problemi arrivano in produzione.
Applicazione automatica dei criteri: il prima e dopo che cambia la conversazione
La prova più chiara del rapporto tra «costo generale» e «benefici» è il passaggio dai controlli manuali all'applicazione automatica dei criteri:
- Tempo di applicazione dei criteri: dal 72% al 28%
- Tasso di errore: dal 45% al 15%
Non è un'ottimizzazione da poco. È la differenza tra una governance che fa da cancello e una governance che fa da guardrail. Passi meno tempo a inseguire eccezioni e più tempo a rendere possibile un self-service sicuro.
«La governance unificata regge solo quando il flusso di lavoro è più semplice dell'aggiramento.» —Taylor, Singh, & Green (2021)
Adozione reale: forte per gli utenti tecnici, più difficile per tutti gli altri
I punteggi di usabilità sono stati alti tra data scientist, business analyst e amministratori IT (da 4,2 a 4,7 su 5). Lo studio segnala però un divario comune: gli utenti non tecnici hanno bisogno di interfacce più semplici, definizioni più chiare e flussi di lavoro guidati. Se vuoi ottenere i numeri sopra, devi mettere in conto la formazione e l'abilitazione, non solo gli strumenti.
Metriche principali in sintesi
| Metrica | Risultato |
|---|---|
| Miglioramento dell'efficienza della governance | Fino al 40% |
| Aumento della qualità dei dati | 35% |
| Tasso di conformità GDPR HIPAA | 92% |
| Tempo di applicazione dei criteri | 72% (manuale) vs 28% (automatizzato) |
| Tasso di errore | 45% (manuale) vs 15% (automatizzato) |
| Valutazione di usabilità | Da 4,2 a 4,7 su 5 |
| Riduzione dei tempi di elaborazione | 25% |
4) Strumenti, prototipi e la realtà confusa dell'implementazione
Cosa ha fatto la ricerca (in parole semplici)
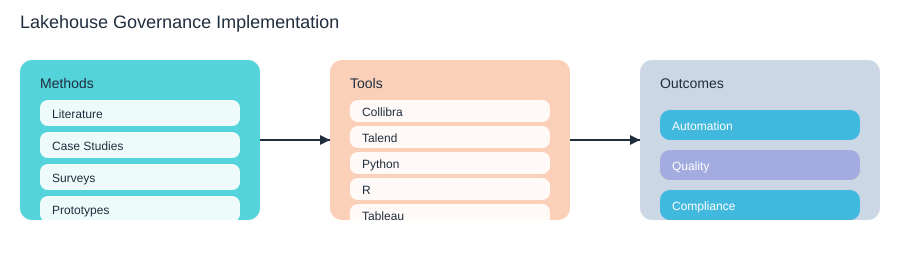
Lo studio di Stallion Journal non ha trattato la governance come un problema da slide. Ha usato quattro metodi che riconosci dal lavoro quotidiano: ha letto la letteratura (revisioni sistematiche), analizzato casi di studio di settore, intervistato gli stakeholder e infine testato prototipi. Quest'ultimo punto conta, perché la governance del lakehouse si rompe nei vuoti tra criteri e pipeline, soprattutto quando i dati arrivano rapidamente, cambiano spesso e provengono da molti team.
Stack dei prototipi: cosa hanno provato davvero
Nella fase sperimentale, lo studio ha usato Collibra e Talend per i pattern di governance e integrazione, oltre a strumenti di analisi (Python, R, Tableau) per validare usabilità e risultati. Puoi replicare questo approccio, che tu stia lavorando sulla governance di Databricks, su un setup lakehouse Snowflake o su una più ampia governance dei dati cloud-native con Kubernetes, Docker, Kafka, Postgres, PySpark ed Elasticsearch nel mix.
Un percorso di adozione da copiare (e da gestire con equilibrio)
Il successo dell'implementazione dipende dalla governance supportata dagli strumenti e dalla tua capacità di gestire velocità, complessità e vincoli di risorse. Una sequenza pratica è questa:
- Parti da catalogo + RBAC: adotta le best practice per il catalogo dei dati (proprietà chiara, termini di business e dataset «golden»). Poi mappa gli accessi con RBAC.
- Aggiungi il lineage: registra l'impatto a monte e a valle, così le modifiche non colgono di sorpresa analisti o auditor.
- Automatizza l'applicazione: passa dalle approvazioni manuali al policy-as-code dove possibile, con tracce di audit.
Harris & Nguyen (2020): «RBAC è semplice sulla carta; diventa concreto il giorno in cui lo mappi sui team, non sui titoli di lavoro.»
Il tuo nemico quotidiano: la velocità e i flussi incoerenti
I flussi ad alta velocità (pensa ai flussi in stile Kafka) generano «schema drift», eventi in ritardo e record duplicati. È qui che la governance diventa complicata: il catalogo dice che un campo è obbligatorio, ma lo stream lo omette; le regole di qualità si aspettano un solo timestamp, ma i produttori ne inviano tre. Lo studio segnala questo problema come un ostacolo ricorrente, soprattutto quando i team sono sotto organico.
Proliferazione di strumenti: quando i sistemi non si allineano
Attenzione al classico problema dello split-brain: il tuo catalogo mostra che il Dataset A è «riservato», ma i gruppi IAM consentono ancora un accesso ampio. Oppure i criteri di governance di Databricks non corrispondono a quanto configurato nell'IAM del cloud. Tratta «un'unica fonte di verità» come un obiettivo di progettazione, non come uno slogan.
| Criterio decisionale | Mantieni semplicità |
|---|---|
| Acquistare o costruire | Acquista per catalogo e flussi di lavoro; costruisci solo connettori e controlli essenziali. |
| Evita un labirinto di governance | Un solo catalogo, un solo modello di criteri, ruoli personalizzati ridotti al minimo, verifiche automatizzate. |
5) I principali problemi di governance (e come darne priorità)
Se hai la sensazione che la governance sia più difficile di quanto «dovrebbe» essere, non sei il solo. Nella sintesi della ricerca, il 78% delle organizzazioni indica la sfida della gestione dei metadati come problema principale. Questo dato dovrebbe farti sentire compreso: in un lakehouse tutto si muove rapidamente, e i metadati sono la mappa che cerchi di aggiornare mentre le strade sono ancora in costruzione.
Perché i metadati cedono per primi (e continuano a cedere)
La gestione dei metadati è difficile perché:
- Le definizioni divergono: «cliente attivo» ha un significato per la Finanza e un altro per il team Growth.
- La titolarità è poco chiara: nessuno sa con certezza chi approva un nuovo campo, una nuova tabella o una nuova regola di conservazione.
- Le pipeline cambiano ogni settimana: nuove origini, nuovi join, nuove feature per il machine learning: catalogo e tag restano indietro.
Eppure, quando investi nella governance, ottieni ritorni misurabili: l'88% segnala un miglioramento della governance della qualità dei dati e l'81% segnala una migliore governance della sicurezza del lakehouse. È questo il premio per il lavoro poco appariscente.
Triage della governance: correggi le cose giuste nell'ordine giusto
- Prima metadati e titolarità: definisci gli elementi di dati critici, assegna un proprietario e un responsabile dei dati e standardizza i termini di business nel catalogo.
- Poi il controllo degli accessi: implementa RBAC con il principio del privilegio minimo, insieme a percorsi di approvazione chiari per le eccezioni.
- Lineage e tracce di audit: tieni traccia di dove provengono i dati, come sono cambiati e chi vi ha acceduto. È qui che le domande su GDPR, HIPAA e CCPA trovano risposta rapidamente.
- Automazione per ultima (ma con costanza): automatizza i controlli dei criteri, l'assegnazione dei tag e il rilevamento delle anomalie, così l'applicazione non dipende da interventi eroici.
Cosa si rompe quando HIPAA incontra CCPA?
Immagina un lakehouse in cui un dataset sanitario soggetto a HIPAA (le visite dei pazienti) viene unito a un dataset di marketing soggetto a CCPA (comportamento sul web). Ciò che si rompe per primo è di solito la classificazione e il consenso: mancano i tag PHI, i flag di consenso non si propagano attraverso i join e una dashboard a valle espone più di quanto previsto. Senza lineage non puoi dimostrare dove sono finiti i dati; senza RBAC non puoi bloccare l'accesso ampio; senza tracce di audit e gestione delle identità non puoi dimostrare la responsabilità.
«La vera sfida non è far funzionare l'AI, ma farla funzionare in modo responsabile all'interno dei sistemi che già hai.»
— Dr. Fei-Fei Li
Un rituale semplice che ti mantiene lucido: la retrospettiva mensile sulla governance
Organizza una retrospettiva mensile di 45 minuti con i responsabili di IT, sicurezza e business. Esamina: i primi 3 gap nei metadati, i primi 3 casi di eccezione negli accessi, un guasto di lineage e un'automazione riuscita. Registra le azioni in un tracker condiviso e assegna un unico responsabile per ogni voce.
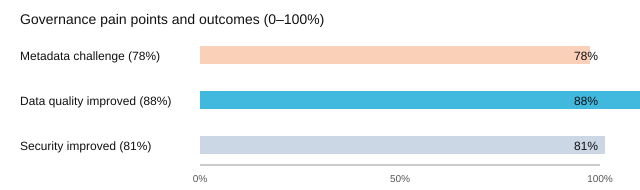
6) Compliance senza paranoia: GDPR, HIPAA, CCPA nel lakehouse
In un lakehouse, tratta la compliance come un vincolo di progettazione, non come un'corsa all'ultimo momento. Quando integri i controlli nell'ingestione, nello storage e negli accessi fin dal primo giorno, la compliance GDPR HIPAA e la governance dei dati CCPA smettono di sembrare emergenze e diventano operatività normale. Lo studio di Stallion Journal su «Data Governance in Lakehouse» mostra perché: le organizzazioni che usano una governance basata sui metadati, l'automazione e il machine learning hanno registrato tassi di conformità saliti al 92% per GDPR e HIPAA. Usalo come parametro di riferimento, non come garanzia.
«La sicurezza è un processo, non un prodotto, e la governance è ciò che mantiene onesto quel processo.»
— Bruce Schneier
Associa i controlli alle normative: il tuo kit essenziale per la compliance
Non si fa il GDPR o l'HIPAA solo scrivendo criteri. Bisogna mappare i requisiti su controlli ripetibili all'interno del lakehouse:
- RBAC (controllo degli accessi basato sui ruoli): limita chi può vedere PHI/PII e chi può esportarli.
- Audit trail del lakehouse: dimostra chi ha acceduto a cosa, quando, da dove e che cosa ha fatto.
- Data lineage: mostra da dove provengono i campi sensibili, come sono cambiati e dove sono finiti.
- Applicazione dei criteri: applica in modo coerente mascheramento, conservazione e limiti di finalità su tutti gli strumenti.
- Gestione dei metadati + catalogo: classifica i dati, assegna le etichette di sensibilità e guida l'automazione.
| Normativa | Che cosa cercano gli auditor | Controllo nel lakehouse |
|---|---|---|
| GDPR | Accesso lecito, minimizzazione, conservazione | RBAC, mascheramento, criteri di conservazione, lineage |
| HIPAA | Log di accesso, misure di tutela, privilegio minimo | Audit trail, RBAC, cifratura, monitoraggio |
| CCPA | Inventario dei dati, gestione di accessi e cancellazioni | Catalogo + metadati, lineage, flussi di lavoro dei criteri |
La prossima ondata: regole specifiche per regione e vincoli dei sistemi legacy
Lo studio segnala lavori futuri da pianificare fin da ora: conformità specifica per regione e una migliore adattabilità per ambienti legacy o vincolati. Se operi in più stati o paesi, costruisci criteri che possano variare per regione (periodi di conservazione, regole sul consenso, notifica delle violazioni). Se usi ancora sistemi meno recenti, parti da un perimetro più ridotto e integra gradualmente: l'automazione aiuta, ma la complessità è reale.
Il giorno dell'audit: che cosa dovrai mostrare
- Inventario dei dati: dove risiedono PII/PHI, i relativi responsabili e la finalità (
catalog + tags). - Prove di accesso: ruoli RBAC, approvazioni ed esportazioni degli audit trail del lakehouse.
- Prova del lineage: percorsi dalla sorgente al report per i dataset chiave e le colonne sensibili.
- Prova dei criteri: mascheramento, conservazione, flussi di cancellazione e log di applicazione.
- Chi deve essere presente: data owner, security, platform admin, compliance/legal e almeno un analista che utilizza i dati.
Vista radar: baseline contro lakehouse governato
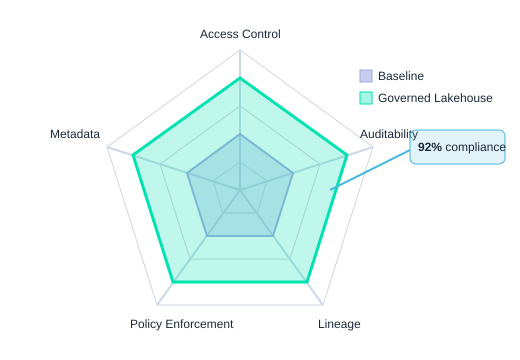
Una breve precisazione onesta: se sei un'organizzazione più piccola, parti da una baseline semplice – RBAC, logging e un catalogo leggero – prima di acquistare strumenti enterprise. Lo studio è chiaro: la complessità implementativa può essere un ostacolo reale, soprattutto quando le risorse sono limitate.
7) Bias dei fornitori, politica e ciò che i deck sulla governance omettono
Puoi progettare su carta un modello di governance del lakehouse impeccabile, per poi vederlo piegarsi nel momento in cui entrano in gioco gli strumenti di data governance. La realtà scomoda è semplice: strumenti e fornitori plasmano ciò che viene considerato "best practice", perché plasmano ciò che è facile da mostrare in demo, facile da acquistare e facile da rendicontare.
Lo studio del Stallion Journal sul lakehouse lo affronta direttamente nella sezione sul conflitto di interessi. Segnala tre fonti di bias che devi dare per presenti in qualsiasi programma di governance: vendor bias (favorire piattaforme come gli stack di governance Collibra Talend o altre suite commerciali), organizational reporting bias (condividere solo le metriche di "successo") e pressioni finanziarie/normative (scegliere ciò che appare più sicuro agli auditor, non ciò che si adatta alla tua architettura). L'indicazione della ricerca è chiara: trasparenza e divulgazione sono necessarie per preservare l'integrità della ricerca e per far sì che le tue scelte di governance restino utili oltre le narrazioni dei fornitori.
Satya Nadella: "La fiducia è la valuta più preziosa, e nei dati la si guadagna essendo espliciti su che cosa hai fatto e perché."
Rischi di bias da nominare apertamente
Governance, ricerca e strumenti: rischi di bias Bias del fornitore 40% Bias di reporting 35% Finanziario/normativo 25% Bias del fornitore Bias di reporting Finanziario/normativo
La tua checklist anti-bias (pratica, non politica)
- Campionamento: confronta almeno una suite commerciale e un'opzione open source negli ecosistemi AWS, Snowflake, Databricks, SAP e Oracle Cloud Infrastructure.
- Divulgazione: documenta gli sponsor, le ragioni della scelta degli strumenti e ciò che non hai testato.
- Criteri di valutazione: profondità del lineage, idoneità di RBAC/ABAC, audit trail, accesso tramite API, formati di esportazione e integrazione con le tabelle del tuo lakehouse.
- Proof-of-value: avvia un pilota a tempo limitato su un dominio; misura il tempo di applicazione dei criteri, il tasso di errore e l'attrito per gli utenti.
- Verifica del rischio di lock-in della piattaforma dati: chiedi come il lock-in si manifesta nei metadati, nei cataloghi e nelle regole dei flussi di lavoro.
Mini storia: sei tu a mediare la decisione reale
Il reparto acquisti spinge per un solo fornitore in nome della "standardizzazione". Gli ingegneri vogliono l'open source per avere controllo. La compliance chiede funzionalità "certificate" e prove di audit pulite. Il tuo compito è fare da traduttore: puoi soddisfare la compliance con controlli solidi e tracce di audit, gli ingegneri con API e portabilità, e il reparto acquisti con un ROI chiaro, senza permettere a nessun gruppo di definire la governance come "tutto ciò che lo strumento vende".
E se il tuo strumento venisse acquisito e il prezzo triplicasse?
Dai per scontato che possa succedere. Verifica subito la portabilità: riesci a esportare il tuo glossario di business, la lineage e le regole dei criteri in formati utilizzabili? Se i tuoi metadati non possono essere spostati, la governance non è un programma, è un abbonamento.
8) Future-proofing: IoT, edge, dati decentralizzati e il lakehouse che erediterai
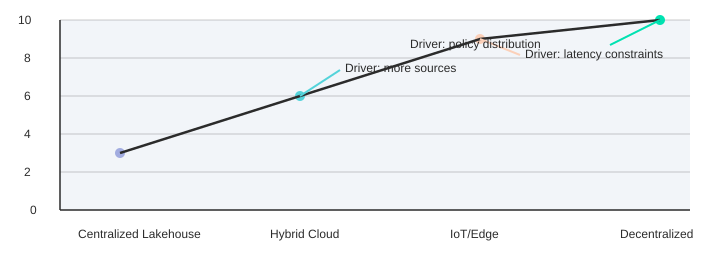
La governance del tuo lakehouse funziona al meglio quando i dati sono per lo più centralizzati, adatti all'elaborazione batch e controllati da poche piattaforme. La governance di IoT e edge computing mette rapidamente in crisi queste ipotesi: ti trovi di fronte a più sorgenti (dispositivi, gateway, applicazioni), meno controllo centralizzato (i team distribuiscono in autonomia) e limiti di latenza più stringenti (non puoi "aspettare il job notturno" per decidere accessi o qualità). Lo studio di Stallion Journal segnala direttamente questa pressione e raccomanda estensioni di governance per tre ambiti emergenti: data lake IoT, architetture decentralizzate ed edge computing.
Perché IoT ed edge mettono sotto stress il modello attuale
Con i flussi IoT, lo stesso evento "cliente" può arrivare da più sensori, in formati diversi e in momenti diversi. Se i tuoi criteri dipendono da un unico aggiornamento del catalogo centrale, dovrai scegliere tra rallentare le operazioni o accettare punti ciechi. Anche le sedi edge creano copie locali dei dati per velocità e resilienza, il che significa che tracce di audit, lineage e regole di conservazione devono viaggiare con i dati, senza restare confinate in un unico piano di controllo in stile data warehouse.
Un'architettura di dati decentralizzata richiede una governance portabile
In un'architettura di dati decentralizzata, i domini pubblicano data product e fanno evolvere gli schemi secondo i propri tempi. È un approccio sano per la velocità di consegna, ma rischioso se le definizioni di "PII", "consenso" o "ambito HIPAA" non sono coerenti. Il future-proofing significa progettare la governance come servizio condiviso: metadati estensibili, criteri con versioni, e controlli di identità che funzionano tra team e regioni, in linea con la richiesta dello studio di adattabilità della compliance alle specificità regionali.
Costruisci su blocchi cloud-native che potrai riutilizzare
L'insieme di riferimenti attorno allo studio indica alcuni blocchi costruttivi pratici: Docker per impacchettare i servizi di criteri, Kubernetes per eseguirli ovunque, Kafka per gli hook di applicazione in streaming, Elasticsearch per una scoperta rapida dei dati e Postgres/PySpark per l'elaborazione governata. Non scegli strumenti per moda: scegli ciò che può girare in cloud, on-premises e all'edge con gli stessi controlli.
"Tutto fallisce, sempre: progetta la governance pensando al cambiamento, non alla stabilità." — Werner Vogels
Una roadmap a piccoli passi per restare in movimento
Non serve risolvere oggi tutta la governance edge. Serve però avere sistemi di metadati e criteri che possano estendersi senza essere riscritti. Inizia con un pilota di rilevamento anomalie basato sull'AI sui segnali di governance (drift dello schema, percorsi di accesso insoliti, esportazioni fuori schema), poi estendi ai controlli automatici dei criteri in fase di ingestion e di query. Man mano che l'infrastruttura cresce, rafforza la gestione delle identità, valuta una protezione da manomissione in stile blockchain per le tracce di audit critiche e pianifica il disaster recovery in base al livello di rischio.
| Ambiente | Indice di complessità della governance (illustrativo) |
|---|---|
| Lakehouse centralizzato | 3 |
| Cloud ibrido | 6 |
| IoT/Edge | 9 |
| Decentralizzato | 10 |
Scrivi i tuoi principi di governance come se dovessero sostituirti: definizioni chiare, criteri portabili e registri delle decisioni che sopravvivano alle riorganizzazioni. Il lakehouse che erediterai in futuro sarà più complesso di oggi, e il tu di domani dormirà meglio se lo progetti già da ora.
architettura lakehouse di microsoft fabric: capire microsoft fabric per analytics e data engineering
Che cos'è l'architettura lakehouse di Microsoft Fabric?
L'architettura lakehouse di Microsoft Fabric è un design di piattaforma dati unificata che combina elementi di data lake e data warehouse per archiviare sia i dati grezzi sia i dataset strutturati e trasformati in un'unica posizione. Sfrutta Azure Data Lake Storage per i volumi di dati, i motori di calcolo di Fabric per l'elaborazione e i pattern di architettura medallion per gestire i livelli raw, enriched e curated, così che i team possano analizzare i dati, eseguire carichi di lavoro di data science e alimentare i report in Power BI senza duplicare i dati.
Come funziona l'architettura medallion in un lakehouse di Fabric?
L'architettura medallion in Fabric organizza i dati in livelli: tipicamente bronze (dati grezzi), silver (puliti e arricchiti) e gold (curati e pronti per analytics/BI). Fabric integra gli strumenti di acquisizione e trasformazione dei dati per spostare e trasformare i dati tra i livelli, abilitando i flussi di data engineering e di preparazione dei dati che mantengono una sola copia dei tuoi dati, riducono la duplicazione e supportano analytics e data science.
Come si implementa un lakehouse in Microsoft Fabric e come si crea un lakehouse?
Per implementare un lakehouse in Microsoft Fabric, inizia collegando le origini dati e acquisendo i dati in un Azure Data Lake usando le funzionalità di acquisizione dati di Fabric. Usa i motori di calcolo di Fabric o le trasformazioni dataflow per applicare l'elaborazione con architettura medallion, catalogare i dataset in OneLake e proteggere l'accesso. Integra Power BI e gli altri strumenti di analytics per la reportistica. La piattaforma semplifica la gestione dei dati, supporta l'integrazione dei dati esistenti e dei big data, e consente di trasformare i dati senza spostarli inutilmente.
Qual è la differenza tra un lakehouse e un data warehouse tradizionale in Microsoft Fabric?
Un lakehouse combina la flessibilità dei data lake per i dati grezzi e semi-strutturati con le prestazioni e la gestione dello schema di un data warehouse. In Microsoft Fabric, il lakehouse consente di archiviare i dati in Azure Data Lake Storage offrendo al tempo stesso prestazioni di query simili a quelle di un warehouse tramite i motori di calcolo di Fabric. Questo abilita le funzionalità di un data warehouse, come i dati strutturati e curati per l'analytics, mantenendo la flessibilità di un data lake per le attività moderne di dati e data engineering.
Come gestisce Fabric l'acquisizione dei dati ed evita la duplicazione?
Fabric supporta più modelli di acquisizione dei dati (streaming, batch e connettori alle origini dati aziendali) in un data lake centrale (Azure Data Lake). Usando l'architettura medallion e OneLake, Fabric privilegia una sola copia dei tuoi dati e dataset logici invece di copie fisiche duplicate. Gli strumenti di integrazione e trasformazione dei dati ti permettono di acquisire i dati, trasformarli sul posto e fornire un accesso coerente ai carichi di lavoro di analytics e data science, riducendo al minimo la duplicazione dei dati tra i sistemi.
Posso usare i data warehouse e i dati Azure esistenti insieme a un lakehouse di Fabric?
Sì. Fabric si integra con sistemi Microsoft e di terze parti, consentendoti di federare le query verso data warehouse, synapse e Azure Data Lake Storage esistenti, consolidando al tempo stesso l'accesso al patrimonio dati. Puoi acquisire o referenziare i dati esistenti, implementare pattern di data mesh e scegliere se spostare i dati nel lakehouse o accedervi direttamente, in base alle esigenze di governance, costi e prestazioni.
Quali sono i casi d'uso più comuni di un lakehouse di Fabric per analytics e data science?
I casi d'uso più comuni includono la gestione unificata dei dati per la BI con Power BI, la preparazione di grandi dataset grezzi per machine learning e data science, la costruzione di pipeline ELT con architettura medallion, l'analisi dei dati su sistemi aziendali e la creazione di un'unica posizione per dati strutturati e non strutturati. Fabric semplifica l'elaborazione dei dati, consente un'analisi scalabile e supporta architetture dati moderne come data mesh e cataloghi dati aziendali.
Come funzionano sicurezza, governance e accesso ai dati in un lakehouse di Fabric?
Fabric offre controllo degli accessi basato sui ruoli, criteri sui dati e integrazione con Microsoft Purview e Azure Active Directory per governance e data lineage. Gli elementi di OneLake e del lakehouse consentono autorizzazioni granulari sui dati archiviati in Azure Data Lake Storage, garantendo accesso sicuro ai dati, conformità e flussi di preparazione dei dati controllati, mantenendo la tracciabilità delle fasi di acquisizione e trasformazione.
Quali motori di calcolo di Fabric dovrei usare per i diversi carichi di lavoro nel lakehouse?
Fabric offre diversi motori di calcolo ottimizzati per carichi di lavoro specifici: query SQL interattive per analisi e BI, Spark per l'elaborazione di big data e l'ingegneria dei dati, e motori specializzati per l'acquisizione in tempo reale. Scegli i motori di calcolo di Fabric in base alle caratteristiche del carico di lavoro: usa Spark per trasformazioni su larga scala, SQL del warehouse per le query BI e i motori di streaming per l'acquisizione continua, così da bilanciare costi, prestazioni ed esigenze di elaborazione dei dati.
Dove posso approfondire l'architettura lakehouse di Microsoft Fabric e iniziare a usarla?
Per iniziare, segui le esercitazioni di Microsoft Learn, consulta la documentazione sull'architettura lakehouse in Microsoft Fabric ed esplora esempi di architettura medallion in Fabric. Comincia collegando un'origine dati, acquisendo i dati grezzi in Azure Data Lake Storage, implementando una semplice pipeline medallion e visualizzando i risultati in Power BI: così capirai come Fabric semplifica la creazione di un lakehouse e la distribuzione di analisi da un'unica data estate.