 PT
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Governança de dados em um Lakehouse do Microsoft Fabric: arquitetura sem perder o sono
By Mirko Peters · · Updated
Governe dados em uma arquitetura de lakehouse no Microsoft Fabric sem perder o sono. Simplifique a análise de dados com uma solução robusta e fácil de gerenciar.
Automatically translated with AI from the original post. Read the English original
Você conhece aquele momento constrangedor em uma reunião, quando alguém pergunta: “Dá para comprovar de onde veio este número?” e a sala fica em silêncio? Já vi esse silêncio se prolongar em empresas que tinham “todos os dados”, mas nenhum registro que comprovasse a origem. Os lakehouses prometem uma única plataforma para tudo: tabelas estruturadas, arquivos desorganizados, fluxos em tempo real e atributos de ML. Mas essa promessa só se sustenta se você conseguir governar tudo isso sem amarrar as mãos das suas equipes. Este post se baseia em grande parte no estudo “Data Governance in Lakehouse” (Shah & Jain), publicado pelo Stallion Journal em outubro de 2024, e acrescenta a camada humana: os atalhos que você será tentado a usar, a política interna com que vai se deparar e os hábitos simples que evitam o pânico causado por auditorias.
8 fatos surpreendentes sobre a governança em um Lakehouse do Microsoft Fabric- Governança unificada entre artefatos: a governança do Fabric se aplica de forma uniforme a tabelas, arquivos, notebooks, pipelines e painéis do lakehouse, permitindo políticas centralizadas que abrangem tanto os dados quanto os artefatos de análise.
- Captura automática de linhagem: a linhagem é capturada automaticamente em muitas operações (ingestão, transformações, notebooks e painéis), oferecendo visibilidade quase em tempo real da procedência dos dados sem necessidade de instrumentação extra.
- Integração de segurança em nível de linha e de coluna: o lakehouse oferece controles de acesso granulares (por linha e por coluna) aplicados no momento da consulta, de modo que o acesso governado acompanha os dados independentemente do mecanismo de consumo.
- Classificação de dados e rótulos de confidencialidade integrados: o Fabric exibe a classificação de dados (tipos de informações confidenciais) e se integra aos rótulos de confidencialidade do Microsoft Purview, para que a governança use as classificações descobertas na aplicação de políticas.
- Políticas como código para controles do ciclo de vida: as políticas de governança (retenção, portões de qualidade, criptografia e computação permitida) podem ser definidas e aplicadas programaticamente, possibilitando a aplicação automatizada ao longo de todo o ciclo de vida do lakehouse.
- Isolamento transparente de locatário e de workspace: o modelo de governança do Fabric oferece isolamento entre múltiplos workspaces e políticas cientes do locatário, para que você possa restringir o compartilhamento e a movimentação de dados entre projetos sem impedir a colaboração governada.
- Logs de alterações e de acesso auditáveis: todas as operações relevantes para a governança (leituras e gravações de dados, alterações de política, atribuições de funções) são auditáveis, gerando logs que se integram ao Microsoft Sentinel e a SIEMs para o monitoramento de conformidade.
- Contratos de dados habilitados pela governança: o Fabric permite criar contratos de dados e esquemas com verificações de compatibilidade obrigatórias, de modo que os consumidores recebam interfaces estáveis e governadas para os dados do lakehouse, e os produtores possam evoluir com segurança.
1) O problema da “reunião silenciosa”: por que os lakehouses precisam de governança
Você está em uma revisão de liderança. Um KPI aparece na tela: retenção de receita, tempo de espera de pacientes, risco de churn. Alguém pergunta: “De onde veio este número?” A sala fica em silêncio. Você não consegue rastrear o conjunto de dados, a transformação nem quem alterou a lógica na semana passada. Nesse momento, o problema não é de análise, e sim de confiança nos dados.
Lakehouse em linguagem simples: um só teto, duas promessas
Um lakehouse é uma combinação prática: a flexibilidade de um data lake (armazenar qualquer coisa, com rapidez) somada à confiabilidade de um data warehouse (tabelas consistentes e alto desempenho). Sob um único teto, você pode gerenciar dados estruturados e não estruturados, executar análises em tempo real e dar suporte a cargas de machine learning. Esse valor “tudo em um” também é o motivo pelo qual sua estratégia de arquitetura de lakehouse precisa incluir governança desde o primeiro dia.
Por que os lakehouses intensificam as necessidades de governança de dados em lakehouse
Os lakehouses avançam rapidamente: fluxos de streaming, retreinamento frequente de modelos e muitas equipes publicando painéis ao mesmo tempo. Essa velocidade multiplica os riscos. Tipos de dados variados e muitas ferramentas tornam mais fácil perder o controle sobre definições, permissões e linhagem. Quando você não consegue explicar uma métrica, as partes interessadas deixam de confiar no painel, mesmo que o número esteja correto.
- Dados em tempo real aumentam a chance de snapshots inconsistentes e de KPIs que estão sempre “em movimento”.
- Pipelines de ML acrescentam novos ativos a governar: atributos, conjuntos de treinamento, saídas de modelos e sinais de drift.
- Mais usuários (analistas, cientistas de dados, equipes de produto) significa mais caminhos de acesso e mais formas de violar a política.
Governança não é burocracia: é o que permite entregar com segurança, sem parar
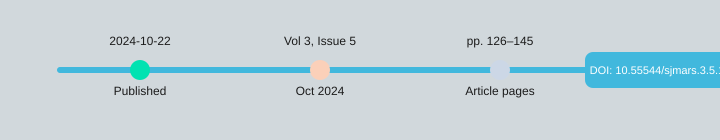
O estudo revisado por pares "Data Governance in Lakehouse", publicado no Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay) em 22-10-2024, no Volume 3, Número 5 (pp. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), apresenta a governança como uma necessidade estratégica e também operacional. A mensagem é direta: a governança protege você em termos de conformidade (GDPR, HIPAA, CCPA), reduz riscos e sustenta a qualidade dos dados e a confiança das partes interessadas.
Samarth Shah: "Em um lakehouse, velocidade sem governança não é agilidade, é apenas confusão mais rápida."
Na prática, governança de dados em lakehouse significa conseguir responder "o que é este KPI?" com evidências: metadados, entradas no catálogo, controles de acesso (como RBAC), trilhas de auditoria e linhagem. Não é burocracia. É o sistema que permite entregar análises rapidamente, sem violar leis nem perder a confiança.
| Item de metadados | Valor |
|---|---|
| Data de publicação | 22-10-2024 |
| Edição da revista | Volume 3, Número 5 (out. 2024) |
| Páginas | 126–145 |
| ISSN | 2583-3340 |
2) Como é uma "boa governança" quando seus dados estão em toda parte
Em um lakehouse, seus dados não estão "em um só lugar". Eles estão distribuídos entre tabelas, arquivos, streams e features de ML, muitas vezes em plataformas como AWS, Snowflake ou Databricks. Uma boa governança é o que mantém esses dados utilizáveis e seguros sem desacelerar as equipes. Pense nela como barreiras de proteção, não portões: você habilita a análise em tempo real e, ao mesmo tempo, atende às expectativas do GDPR, do HIPAA e do CCPA.
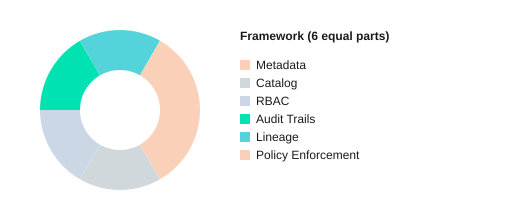
Os 6 pilares que você realmente vai implementar
- Governança orientada por metadados: defina proprietários, sensibilidade, retenção e regras de qualidade nos metadados para que os controles escalem com o volume e as mudanças.
- Boas práticas de catálogo de dados: um único lugar pesquisável com definições, tags e conjuntos de dados confiáveis, para que as pessoas parem de adivinhar.
- Controle de acesso RBAC: funções alinhadas às necessidades do trabalho (analista, engenheiro, clínico), e não permissões ad hoc.
- Rastreamento de linhagem de dados: mostre de onde os dados vieram, como foram alterados e o que alimentam.
- Trilhas de auditoria: quem acessou o quê, quando e o que fez, algo essencial para investigações e auditorias.
- Aplicação de políticas: verificações automatizadas (mascaramento, retenção, aprovações) que funcionam por padrão, e não mediante solicitação.
Governança documentada versus governança aplicada (só uma delas evita incidentes)
Governança documentada é uma página de wiki que diz "dados pessoais devem ser mascarados". Governança aplicada é quando seu lakehouse automaticamente mascara dados pessoais com base em tags de metadados, bloqueia exportações arriscadas e registra os acessos nas trilhas de auditoria. A pesquisa por trás da governança moderna de lakehouse mostra que automação e metadados reduzem o tempo de aplicação manual e os erros, porque a plataforma aplica as regras de forma consistente.
Governança unificada quando você lida com tabelas, arquivos, streams e features
Você precisa de um plano de controle único que funcione em tabelas em lote, arquivos em armazenamento de objetos, streams do tipo Kafka e conjuntos de features de ML. Quando a governança é unificada, o mesmo controle de acesso RBAC, as mesmas tags e as mesmas políticas acompanham os dados, e assim seus dashboards, notebooks e modelos permanecem alinhados e em conformidade.
Um breve desvio: como "um conjunto de dados compartilhado" vira 12 versões
Sem o rastreamento de linhagem de dados, um conjunto de dados de "cliente" é copiado para customer_v2, customer_clean, customer_final e "final_final". Logo, as equipes passam a discutir números, porque ninguém consegue provar qual versão alimentou qual relatório.
Shubham Jain: "Linhagem é a diferença entre 'acho que sim' e 'consigo provar' quando alguém questiona seus números."
Autoavaliação de 5 minutos
- Você consegue encontrar o proprietário e a tag de sensibilidade dos seus 10 principais conjuntos de dados no catálogo?
- As funções (e não indivíduos) controlam o acesso por meio do RBAC?
- Você consegue rastrear um KPI até as fontes, usando a linhagem, em menos de 2 minutos?
- As trilhas de auditoria respondem hoje a pergunta "quem visualizou/exportou isto"?
- As políticas são aplicadas automaticamente (mascaramento, retenção, aprovações), e não manualmente?
Cada controle se traduz em resultados: menos incidentes de acesso (RBAC + políticas), auditorias mais rápidas (trilhas de auditoria + catálogo) e análises mais limpas (metadados + linhagem).
3) Os números que fazem a governança parecer menos "sobrecarga"
Se a governança parecer “processo extra”, os resultados do estudo ajudam você a enquadrá-la como ganho operacional mensurável. Quando você aplica governança orientada por metadados com automação e ML em um lakehouse, você não está apenas “adicionando controles”. Está recuperando tempo, aumentando a confiança nos dados e reduzindo o risco de conformidade de formas que um CFO consegue acompanhar.
Governança orientada por metadados: ROI que cabe em um slide
O estudo relata três resultados principais quando as equipes apoiam-se em metadados robustos, catalogação, linhagem e controles de acesso:
- Até 40% de melhoria na eficiência da governança
- Aumento de 35% na qualidade dos dados
- Taxas de conformidade de 92% com GDPR e HIPAA (GDPR/HIPAA)
Na prática, esse ganho de eficiência de 40% geralmente significa menos revisões manuais, menos ciclos de “quem é o dono deste conjunto de dados?” e aprovações mais rápidas para acesso e compartilhamento. Seu backlog diminui porque as verificações rotineiras passam de pessoas para sistemas, e sua fila de incidentes cai porque menos problemas chegam à produção.
Aplicação automatizada de políticas: o antes e depois que muda a conversa
A prova mais clara de “custo operacional versus retorno” é a transição de controles manuais para a aplicação automatizada de políticas:
- Tempo de aplicação de políticas: 72% → 28%
- Taxa de erro: 45% → 15%
Isso não é uma otimização pequena. É a diferença entre a governança ser uma barreira e a governança ser uma proteção. Você gasta menos tempo correndo atrás de exceções e mais tempo habilitando o self-service seguro.
“A governança unificada só se sustenta quando o fluxo de trabalho é mais fácil do que o atalho.” —Taylor, Singh, & Green (2021)
Adoção na prática: forte entre usuários técnicos, mais difícil para os demais
As pontuações de usabilidade foram altas entre cientistas de dados, analistas de negócios e administradores de TI (4,2–4,7/5). Mas o artigo também aponta uma lacuna comum: usuários não técnicos precisam de interfaces mais simples, definições mais claras e fluxos de trabalho guiados. Se você quer os números acima, precisa prever orçamento para capacitação, e não apenas para ferramentas.
Principais métricas de relance
| Métrica | Resultado |
|---|---|
| Melhoria na eficiência da governança | Até 40% |
| Aumento na qualidade dos dados | 35% |
| Taxa de conformidade com GDPR e HIPAA | 92% |
| Tempo de aplicação de políticas | 72% (manual) vs. 28% (automatizado) |
| Taxa de erro | 45% (manual) vs. 15% (automatizado) |
| Avaliação de usabilidade | 4,2–4,7 de 5 |
| Redução do tempo de processamento | 25% |
4) Ferramentas, protótipos e a realidade confusa da implementação
O que a pesquisa fez (em termos simples)
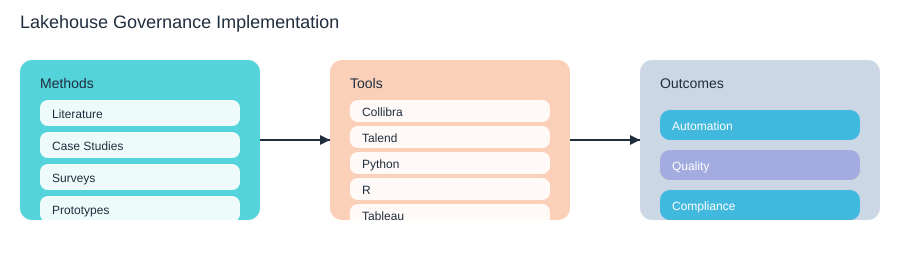
O estudo do Stallion Journal não tratou a governança como um problema de apresentação de slides. Ele usou quatro métodos que você reconhece do trabalho real: revisou a literatura (revisões sistemáticas), analisou estudos de caso do setor, pesquisou stakeholders e, por fim, testou protótipos. Esta última parte é importante, porque a governança em lakehouse falha nas lacunas entre a política e os pipelines, especialmente quando seus dados chegam rápido, mudam com frequência e vêm de muitas equipes.
Stack de protótipos: o que eles realmente testaram
Na experimentação, o estudo usou Collibra e Talend para padrões de governança e integração, além de ferramentas de análise (Python, R, Tableau) para validar a usabilidade e os resultados. Você pode replicar essa abordagem seja em governança no Databricks, em uma configuração de lakehouse no Snowflake ou em uma governança de dados nativa da nuvem mais ampla, com Kubernetes, Docker, Kafka, Postgres, PySpark e Elasticsearch no conjunto.
Um caminho de implantação que você pode copiar (e manter sob controle)
O sucesso da implementação depende de governança apoiada por ferramentas e da sua capacidade de lidar com velocidade, complexidade e limitações de recursos. Uma sequência prática é:
- Comece com catálogo + RBAC: adote boas práticas de catálogo de dados (propriedade clara, termos de negócio e conjuntos de dados “dourados”). Em seguida, mapeie o acesso usando RBAC.
- Adicione linhagem: capture o impacto a montante e a jusante para que as mudanças não surpreendam analistas ou auditores.
- Automatize a aplicação: migre das aprovações manuais para policy-as-code sempre que possível, com trilhas de auditoria.
Harris & Nguyen (2020): “RBAC é simples no papel; ele se torna real no dia em que você o mapeia para equipes, não para cargos.”
Seu inimigo diário: velocidade e fluxos de dados inconsistentes
Feeds de alta velocidade (pense em streams no estilo Kafka) criam “schema drift”, eventos atrasados e registros duplicados. É aí que a governança parece bagunçada: o catálogo diz que um campo é obrigatório, mas o stream o descarta; suas regras de qualidade esperam um timestamp, mas os produtores enviam três. O estudo aponta isso como um obstáculo recorrente, especialmente quando as equipes estão com pouco pessoal.
Proliferação de ferramentas: quando os sistemas não concordam
Fique atento ao clássico problema de split-brain: seu catálogo mostra que o Dataset A é “restrito”, mas os grupos do IAM ainda permitem acesso amplo. Ou suas políticas de governança do Databricks não correspondem ao que está configurado no IAM da nuvem. Trate “uma única fonte de verdade” como objetivo de design, não como slogan.
| Lente de decisão | Mantenha simples |
|---|---|
| Comprar ou construir | Compre para catálogo e fluxos de trabalho; construa apenas conectores e verificações enxutos. |
| Evite um labirinto de governança | Um catálogo, um modelo de política, papéis personalizados mínimos e auditorias automatizadas. |
5) Os principais pontos de dor da governança (e como você os prioriza)
Se a governança parece mais difícil do que “deveria ser”, você não está sozinho. Na síntese de pesquisa, 78% das organizações citam o desafio de gerenciamento de metadados como o principal ponto de dor. Esse dado deve fazer você se sentir compreendido, porque em um lakehouse tudo se move rápido, e os metadados são o mapa que você tenta atualizar enquanto as estradas ainda estão sendo construídas.
Por que os metadados quebram primeiro (e continuam quebrando)
Gerenciar metadados é difícil porque:
- As definições divergem: “Cliente ativo” significa uma coisa para Finanças e outra para Growth.
- A responsabilidade é nebulosa: ninguém tem certeza de quem aprova um novo campo, uma nova tabela ou uma nova regra de retenção.
- Os pipelines mudam toda semana: novas fontes, novos joins, novos recursos de ML — seu catálogo e suas tags ficam para trás.
Ainda assim, quando você investe em governança, obtém retornos mensuráveis: 88% relatam melhora na governança da qualidade dos dados, e 81% relatam melhor governança de segurança do lakehouse. É esse o retorno de fazer o trabalho pouco glamouroso.
Triagem de governança: corrija as coisas certas na ordem certa
- Metadados e responsabilidade primeiro: defina os elementos de dados críticos, atribua um proprietário e um curador de dados e padronize os termos de negócio no seu catálogo.
- Controle de acesso em seguida: implemente RBAC com privilégio mínimo, além de caminhos de aprovação claros para exceções.
- Linhagem e trilhas de auditoria: acompanhe de onde os dados vieram, como mudaram e quem os acessou. É aqui que as perguntas sobre GDPR/HIPAA/CCPA são respondidas rapidamente.
- Automação por último (mas de forma contínua): automatize verificações de política, etiquetagem e detecção de anomalias para que a aplicação não dependa de heroísmo.
O que quebra quando HIPAA encontra CCPA?
Imagine um lakehouse em que um conjunto de dados de saúde regulado pela HIPAA (encontros com pacientes) é combinado com um conjunto de dados de marketing coberto pela CCPA (comportamento na web). O que costuma quebrar primeiro é a classificação e o consentimento: as tags de PHI estão ausentes, os indicadores de consentimento não se propagam pelos joins e um painel downstream expõe mais do que o pretendido. Sem linhagem, você não consegue provar para onde os dados foram; sem RBAC, não consegue impedir o acesso amplo; sem trilhas de auditoria e gerenciamento de identidades, não consegue demonstrar responsabilidade.
“O verdadeiro desafio não é fazer a IA funcionar, e sim fazê-la funcionar de forma responsável dentro dos sistemas que você já tem.”
— Dra. Fei-Fei Li
Um ritual simples que mantém você sã: a retrospectiva mensal de governança
Realize uma retrospectiva mensal de 45 minutos com proprietários de TI, segurança e negócios. Revise: as 3 principais lacunas de metadados, as 3 principais exceções de acesso, uma falha de linhagem e uma vitória em automação. Registre as ações em um rastreador compartilhado e atribua um único responsável por item.
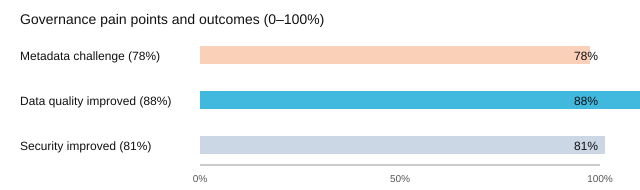
6) Conformidade sem paranoia: GDPR, HIPAA, CCPA no lakehouse
Em um lakehouse, trate a conformidade como uma restrição de design, não como uma correria de última hora. Quando você incorpora os controles à ingestão, ao armazenamento e ao acesso desde o primeiro dia, conformidade com GDPR e HIPAA e governança de dados CCPA deixam de parecer exercícios de emergência e passam a ser operações normais. O estudo da Stallion Journal sobre “Data Governance in Lakehouse” mostra o motivo: organizações que usam governança orientada por metadados, automação e ML relataram taxas de conformidade de até 92% para GDPR e HIPAA. Use isso como um benchmark de referência, não como garantia.
“Segurança é um processo, não um produto, e a governança é o que mantém esse processo honesto.”
— Bruce Schneier
Mapeie os controles para as regulamentações: seu kit essencial de conformidade
Você não "faz GDPR" nem "faz HIPAA" apenas escrevendo políticas. Você mapeia os requisitos para controles repetíveis dentro do lakehouse:
- RBAC (controle de acesso baseado em funções): limite quem pode ver PHI/PII e quem pode exportá-los.
- Trilhas de auditoria do lakehouse: comprove quem acessou o quê, quando, de onde e o que fez.
- Linhagem de dados: mostre de onde vieram os campos sensíveis, como mudaram e para onde foram.
- Aplicação de políticas: aplique mascaramento, retenção e limites de finalidade de forma consistente entre as ferramentas.
- Gerenciamento de metadados + catálogo: classifique os dados, marque a sensibilidade e direcione a automação.
| Regulamentação | O que os auditores procuram | Controle no lakehouse |
|---|---|---|
| GDPR | Acesso lícito, minimização, retenção | RBAC, mascaramento, políticas de retenção, linhagem |
| HIPAA | Registros de acesso, salvaguardas, privilégio mínimo | Trilhas de auditoria, RBAC, criptografia, monitoramento |
| CCPA | Inventário de dados, tratamento de acesso e exclusão | Catálogo + metadados, linhagem, fluxos de política |
A próxima onda: regras específicas por região e restrições de sistemas legados
O artigo aponta trabalhos futuros que você deve planejar desde já: conformidade específica por região e maior adaptabilidade para ambientes legados ou com restrições. Se você opera em vários estados ou países, crie políticas que possam variar por região (prazos de retenção, regras de consentimento, notificação de violações). Se ainda mantém sistemas mais antigos, comece com um escopo menor e integre gradualmente. A automação ajuda, mas a complexidade é real.
Roteiro do "dia da auditoria": o que você precisará apresentar
- Inventário de dados: onde estão os PII/PHI, os responsáveis e a finalidade (
catalog + tags). - Evidências de acesso: funções RBAC, aprovações e exportações das trilhas de auditoria do lakehouse.
- Prova de linhagem: caminhos da origem até o relatório para os principais conjuntos de dados e colunas sensíveis.
- Prova de políticas: mascaramento, retenção, fluxos de exclusão e registros de aplicação das políticas.
- Quem deve estar na sala: proprietário dos dados, segurança, administrador da plataforma, compliance/jurídico e um analista que usa os dados.
Visão de radar: linha de base versus lakehouse governado
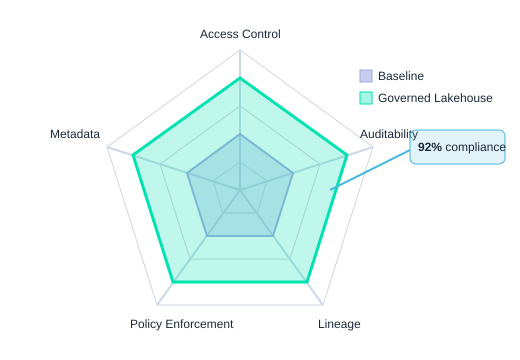
Um comentário breve e sincero: se sua organização é menor, comece com uma linha de base simples (RBAC, registro de logs e um catálogo leve) antes de comprar ferramentas corporativas. O estudo deixa claro que a complexidade de implementação pode ser uma barreira real, especialmente quando os recursos são limitados.
7) Viés de fornecedores, política e o que os slides de governança deixam de fora
Você pode desenhar um modelo limpo de governança para o lakehouse no papel e vê-lo se deformar no momento em que ferramentas de governança de dados entram na sala. A realidade incômoda é simples: ferramentas e fornecedores moldam o que parece "melhor prática", porque moldam o que é fácil de demonstrar, fácil de comprar e fácil de reportar.
O estudo sobre lakehouse da Stallion Journal aborda isso diretamente na seção de conflito de interesses. Ele aponta três fontes de viés que você deve presumir existirem em qualquer programa de governança: viés de fornecedor (favorecer plataformas como pilhas de governança Collibra Talend ou outras suítes comerciais), viés de relatório organizacional (compartilhar apenas métricas de "sucesso") e pressões financeiras/regulatórias (escolher o que parece mais seguro para os auditores, e não o que se adapta à sua arquitetura). A principal conclusão da pesquisa é clara: transparência e divulgação são necessárias para preservar a integridade da pesquisa e manter suas escolhas de governança úteis além das narrativas dos fornecedores.
Satya Nadella: "A confiança é a moeda definitiva, e em dados você a conquista sendo explícito sobre o que fez e por quê."
Riscos de viés que você deve nomear em voz alta
Pesquisa de governança e riscos de viés em ferramentas. Viés de fornecedor 40%. Viés de relatório 35%. Financeiro/regulatório 25%. Viés de fornecedor. Viés de relatório. Financeiro/regulatório
Seu checklist anti-viés (prático, não político)
- Amostragem: compare pelo menos uma suíte comercial e uma opção aberta nos ecossistemas AWS, Snowflake, Databricks, SAP e Oracle Cloud Infrastructure.
- Divulgação: documente patrocinadores, os motivos da seleção de ferramentas e o que você não testou.
- Critérios de avaliação: profundidade da linhagem, adequação de RBAC/ABAC, trilhas de auditoria, acesso via API, formatos de exportação e integração com as tabelas do seu lakehouse.
- Prova de valor: execute um piloto com prazo definido em um domínio; meça o tempo de aplicação das políticas, a taxa de erro e o atrito para os usuários.
- Verificação de risco de dependência de fornecedor na plataforma de dados: pergunte como o lock-in aparece em metadados, catálogos e regras de fluxo de trabalho.
Mini história: você media a decisão real
O setor de compras pressiona por um único fornecedor em nome da “padronização”. Os engenheiros querem código aberto para ter controle. A área de compliance quer recursos “certificados” e evidências de auditoria limpas. Seu trabalho é traduzir essas demandas: você pode atender ao compliance com controles fortes e trilhas de auditoria, atender aos engenheiros com APIs e portabilidade, e atender às compras com um ROI claro, sem deixar que nenhum grupo defina a governança como “o que a ferramenta vende”.
E se sua ferramenta for adquirida e o preço triplicar?
Considere que isso pode acontecer. Teste a portabilidade agora: você consegue exportar seu glossário de negócios, o lineage e as regras de política em formatos utilizáveis? Se seus metadados não puderem ser movidos, sua governança não é um programa, é uma assinatura.
8) Preparação para o futuro: IoT, edge, dados descentralizados e o lakehouse que você vai herdar
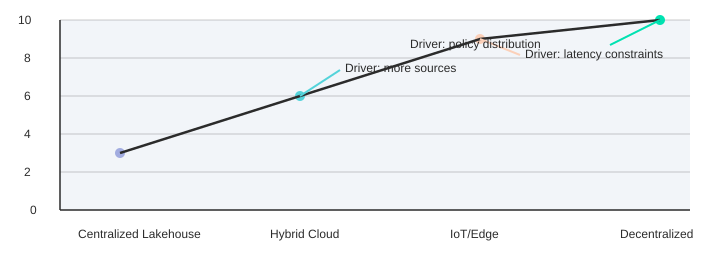
A governança do seu lakehouse funciona melhor quando os dados estão majoritariamente centralizados, são adequados para processamento em lote e são controlados por poucas plataformas. A governança de IoT e de computação em edge quebra essas premissas rapidamente: você enfrenta mais fontes (dispositivos, gateways, aplicativos), menos controle central (equipes implantam de forma independente) e limites de latência mais rígidos (você não pode “esperar o job noturno” para decidir acesso ou qualidade). O estudo do Stallion Journal aponta essa pressão diretamente e recomenda extensões de governança para três domínios emergentes: data lakes de IoT, arquiteturas descentralizadas e computação em edge.
Por que IoT e edge pressionam seu modelo atual
Em fluxos de IoT, o mesmo evento de “cliente” pode chegar de vários sensores, em formatos diferentes e em momentos diferentes. Se suas políticas dependerem de uma única atualização do catálogo central, você vai ou desacelerar as operações ou aceitar pontos cegos. Locais de edge também criam cópias locais dos dados para ganhar velocidade e resiliência, o que significa que suas trilhas de auditoria, o lineage e as regras de retenção precisam acompanhar os dados, e não ficar presos em um plano de controle centralizado, no estilo de data warehouse.
Arquitetura de dados descentralizada exige governança portátil
Em uma arquitetura de dados descentralizada, os domínios publicam produtos de dados e evoluem seus esquemas em cronogramas próprios. Isso é saudável para a velocidade de entrega, mas arriscado se suas definições de “PII”, “consentimento” ou “escopo da HIPAA” não forem consistentes. Preparar-se para o futuro significa projetar a governança como um serviço compartilhado: metadados extensíveis, políticas versionadas e controles de identidade que funcionem entre equipes e regiões, alinhados ao apelo do artigo por adaptabilidade a requisitos de compliance específicos de cada região.
Construa com blocos nativos da nuvem que você possa herdar
O conjunto de referência em torno do estudo aponta para blocos práticos: Docker para empacotar serviços de política, Kubernetes para executá-los em qualquer lugar, Kafka para transmitir hooks de aplicação de políticas, Elasticsearch para descoberta rápida e Postgres/PySpark para processamento governado. Você não está escolhendo ferramentas por moda: está escolhendo o que pode rodar na nuvem, no on-premises e no edge com os mesmos controles.
“Tudo falha, o tempo todo. Projete a governança esperando mudança, não estabilidade.” — Werner Vogels
Um roadmap de apostas pequenas que mantém você em movimento
Você não precisa resolver a governança de edge por completo hoje. Precisa, sim, de sistemas de metadados e de políticas que possam crescer sem reescritas. Comece pilotando a detecção de anomalias com IA sobre sinais de governança (desvio de esquema, caminhos de acesso incomuns, exportações fora do padrão) e depois expanda para verificações automatizadas de política na ingestão e no momento da consulta. À medida que sua presença crescer, adicione gestão de identidade mais robusta, considere evidências de adulteração no estilo blockchain para trilhas de auditoria críticas e planeje a recuperação de desastres de acordo com o nível de risco de cada um.
| Ambiente | Índice de complexidade de governança (ilustrativo) |
|---|---|
| Lakehouse centralizado | 3 |
| Nuvem híbrida | 6 |
| IoT/Edge | 9 |
| Descentralizado | 10 |
Escreva seus princípios de governança como se você fosse ser substituído: definições claras, políticas portáteis e registros de decisão que sobrevivam a reorganizações. O lakehouse que você herdar no futuro será mais bagunçado do que é hoje, e o seu eu do futuro vai dormir melhor se você projetar para isso desde já.
arquitetura de lakehouse no Microsoft Fabric: entenda o Microsoft Fabric para análises e engenharia de dados
O que é a arquitetura de lakehouse do Microsoft Fabric?
A arquitetura de lakehouse do Microsoft Fabric é um design de plataforma de dados unificada que combina elementos de data lakes e data warehouses para armazenar dados brutos e conjuntos de dados estruturados e transformados em um único local. Ela utiliza o Azure Data Lake Storage para os volumes de dados, mecanismos de computação do Fabric para processamento e padrões da arquitetura medallion para gerenciar as camadas bruta, enriquecida e curada, para que as equipes possam analisar dados, executar cargas de trabalho de ciência de dados e alimentar relatórios no Power BI sem duplicar dados.
Como funciona a arquitetura medallion em um lakehouse do Fabric?
A arquitetura medallion no Fabric organiza os dados em camadas — normalmente bronze (dados brutos), prata (limpos e enriquecidos) e ouro (curados, prontos para análises e BI). O Fabric integra ferramentas de ingestão e de transformação de dados para mover e transformar dados entre as camadas, viabilizando fluxos de engenharia e preparação de dados que mantêm uma única cópia dos seus dados e reduzem a duplicação, ao mesmo tempo que dão suporte a análises e ciência de dados.
Como implemento um lakehouse no Microsoft Fabric e como crio um lakehouse?
Para implementar um lakehouse no Microsoft Fabric, comece conectando suas fontes de dados e ingerindo os dados em um Azure Data Lake usando os recursos de ingestão de dados do Fabric. Use os mecanismos de computação do Fabric ou as transformações de dataflow para aplicar o processamento da arquitetura medallion, catalogue os conjuntos de dados no OneLake e proteja o acesso. Integre o Power BI e outras ferramentas de análise para geração de relatórios. A plataforma simplifica o gerenciamento de dados, oferece suporte à integração de dados entre dados existentes e big data, e permite transformar dados sem movê-los desnecessariamente.
Qual é a diferença entre um lakehouse e um data warehouse tradicional no Microsoft Fabric?
Um lakehouse combina a flexibilidade dos data lakes, para dados brutos e semiestruturados, com o desempenho e o gerenciamento de esquema de um data warehouse. No Microsoft Fabric, o lakehouse permite armazenar dados no Azure Data Lake Storage e, ao mesmo tempo, oferece desempenho de consulta semelhante ao de um warehouse por meio dos mecanismos de computação do Fabric. Isso possibilita recursos de data warehouse, como dados curados e estruturados para análises, mantendo a flexibilidade de um data lake para tarefas modernas de dados e engenharia de dados.
Como o Fabric lida com a ingestão de dados e evita a duplicação de dados?
O Fabric oferece suporte a múltiplos padrões de ingestão de dados — streaming, lote e conectores para fontes de dados corporativas — em um data lake central (Azure Data Lake). Com a arquitetura medallion e o OneLake, o Fabric promove uma única cópia dos seus dados e conjuntos de dados lógicos, em vez de cópias físicas duplicadas. As ferramentas de integração e transformação de dados permitem ingerir dados, transformá-los no próprio local e oferecer acesso consistente a cargas de trabalho de análise e ciência de dados, minimizando a duplicação de dados entre sistemas.
Posso usar data warehouses e dados do Azure existentes junto com um lakehouse do Fabric?
Sim. O Fabric se integra a sistemas da Microsoft e de terceiros, permitindo federar consultas a data warehouses existentes, ao Synapse e ao Azure Data Lake Storage, ao mesmo tempo que consolida o acesso ao seu ambiente de dados. Você pode ingerir ou referenciar dados existentes, implementar padrões de data mesh e escolher se move os dados para o lakehouse ou se os acessa diretamente, conforme as necessidades de governança, custo e desempenho.
Quais são os casos de uso comuns de um lakehouse do Fabric em análises e ciência de dados?
Os casos de uso comuns incluem o gerenciamento unificado de dados para BI com o Power BI, a preparação de grandes volumes de dados brutos para machine learning e ciência de dados, a criação de pipelines ELT com a arquitetura medallion, a análise de dados em sistemas corporativos e a criação de um único local para dados estruturados e não estruturados. O Fabric simplifica o processamento de dados, possibilita análises escaláveis e dá suporte a arquiteturas de dados modernas, como data mesh e catálogos corporativos de dados.
Como funcionam a segurança, a governança e o acesso a dados em um lakehouse do Fabric?
O Fabric oferece controle de acesso baseado em funções, políticas de dados e integração com o Microsoft Purview e o Microsoft Entra ID (antigo Azure Active Directory) para governança e linhagem de dados. O OneLake e os elementos do lakehouse permitem permissões refinadas sobre os dados armazenados no Azure Data Lake Storage, garantindo acesso seguro aos dados, conformidade e fluxos controlados de preparação de dados, com rastreabilidade em todas as etapas de ingestão e transformação.
Quais mecanismos de computação do Fabric devo usar para diferentes cargas de trabalho no lakehouse?
O Fabric oferece vários mecanismos de processamento otimizados para cargas de trabalho específicas: consultas SQL interativas para análises e BI, Spark para processamento de big data e engenharia de dados, e mecanismos especializados para ingestão em tempo real. Escolha os mecanismos de computação do Fabric com base nas características da carga de trabalho: use Spark para transformações em larga escala, SQL de warehouse para consultas de BI e mecanismos de streaming para ingestão contínua, de modo a equilibrar custo, desempenho e necessidades de processamento de dados.
Onde posso aprender mais e começar com a arquitetura de lakehouse do Microsoft Fabric?
Para começar, siga os tutoriais do Microsoft Learn, revise a documentação sobre arquitetura de lakehouse no Microsoft Fabric e explore exemplos de arquitetura medallion no Fabric. Comece conectando uma fonte de dados, ingerindo os dados brutos no Azure Data Lake Storage, implementando um pipeline medallion simples e visualizando os resultados no Power BI, para entender como o Fabric simplifica a criação de um lakehouse e a entrega de análises a partir de um ambiente de dados unificado.