 ES
 English
 Deutsch
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Gobierna los datos en un lakehouse de Microsoft Fabric: arquitectura sin quitarte el sueño
By Mirko Peters · · Updated
Gobierna los datos en una arquitectura lakehouse de Microsoft Fabric sin quitarte el sueño. Simplifica la analítica con una solución robusta y manejable.
Automatically translated with AI from the original post. Read the English original
¿Conoces ese momento incómodo en una reunión, cuando alguien pregunta: "¿Podemos demostrar de dónde salió este número?", y la sala se queda en silencio? He visto cómo ese silencio se alarga en empresas que tenían "todos los datos", pero ningún comprobante. Los lakehouses prometen una sola plataforma para todo (tablas estructuradas, archivos desordenados, flujos en tiempo real, características de ML), pero esa promesa solo se cumple si puedes gobernarla sin maniatar a tus equipos. Este artículo se apoya en gran medida en el estudio "Data Governance in Lakehouse" (Shah & Jain) del Stallion Journal de octubre de 2024, y luego añade la capa humana: los atajos a los que te sentirás tentado, los conflictos políticos con los que tropezarás y los hábitos sencillos que te evitarán el pánico que provoca una auditoría.
Preguntas frecuentes- Gobierno unificado entre artefactos: El gobierno de Fabric se aplica de forma uniforme a las tablas, los archivos, los cuadernos, las canalizaciones y los paneles del lakehouse, lo que permite directivas centralizadas que abarcan tanto los artefactos de datos como los de analítica.
- Captura automática del linaje: El linaje se captura automáticamente en muchas operaciones (ingesta, transformaciones, cuadernos y paneles), lo que ofrece visibilidad casi en tiempo real del origen de los datos sin instrumentación adicional.
- Integración de seguridad a nivel de fila y de columna: El lakehouse admite controles de acceso detallados (a nivel de fila y de columna) que se aplican en el momento de la consulta, de modo que el acceso gobernado viaja con los datos, independientemente del motor de consumo.
- Clasificación de datos y etiquetas de confidencialidad integradas: Fabric muestra la clasificación de datos (tipos de información confidencial) y se integra con las etiquetas de confidencialidad de Microsoft Purview, de modo que el gobierno puede usar las clasificaciones detectadas para aplicar directivas.
- Directivas como código para los controles del ciclo de vida: Las directivas de gobierno (retención, puertas de calidad, cifrado, cómputo permitido) pueden definirse y aplicarse mediante programación, lo que permite una aplicación automatizada en todo el ciclo de vida del lakehouse.
- Aislamiento de inquilino y de espacios de trabajo sin fricciones: El modelo de gobierno de Fabric admite el aislamiento entre varios espacios de trabajo y directivas que tienen en cuenta el inquilino, de modo que puedes restringir el uso compartido y el movimiento de datos entre proyectos y, aun así, habilitar una colaboración gobernada.
- Registros de auditoría de modificaciones y accesos: Todas las operaciones relevantes para el gobierno (lecturas y escrituras de datos, cambios de directivas, asignaciones de roles) son auditables y generan registros que se integran con Microsoft Sentinel y con los SIEM para la supervisión del cumplimiento normativo.
- Contratos de datos habilitados para el gobierno: Fabric permite crear contratos de datos y esquemas con comprobaciones de compatibilidad obligatorias, de modo que los consumidores obtienen interfaces estables y gobernadas para los datos del lakehouse y los productores pueden evolucionar con seguridad.
1) El problema de la "reunión silenciosa": por qué los lakehouses necesitan gobierno
Estás en una revisión con la dirección. En la pantalla aparece un KPI: retención de ingresos, tiempo de espera de pacientes, riesgo de abandono. Alguien pregunta: "¿De dónde salió este número?". La sala se queda en silencio. No puedes rastrear el conjunto de datos, la transformación ni quién cambió la lógica la semana pasada. En ese momento no tienes un problema de analítica, tienes un problema de confianza en los datos.
Lakehouse en lenguaje sencillo: un mismo techo, dos promesas
Un lakehouse es una combinación práctica: la flexibilidad de un data lake (almacenar cualquier cosa, con rapidez) más la fiabilidad de un data warehouse (tablas coherentes y un rendimiento sólido). Bajo un mismo techo puedes gestionar datos estructurados y no estructurados, ejecutar analítica en tiempo real y dar soporte a cargas de trabajo de machine learning. Ese valor "todo en uno" es también la razón por la que tu estrategia de arquitectura lakehouse debe incluir el gobierno desde el primer día.
Por qué los lakehouses intensifican las necesidades de gobierno de datos del lakehouse
Los lakehouses se mueven deprisa: flujos de streaming, reentrenamiento frecuente de modelos y muchos equipos publicando paneles al mismo tiempo. Esa velocidad multiplica el riesgo. Los tipos de datos mixtos y la cantidad de herramientas hacen más fácil perder el control de las definiciones, los permisos y el linaje. Cuando no puedes explicar una métrica, las partes interesadas dejan de confiar en el panel, aunque el número sea correcto.
- Los datos en tiempo real aumentan la probabilidad de instantáneas incoherentes y de KPI que son un "blanco móvil".
- Las canalizaciones de ML añaden nuevos activos que gobernar: características, conjuntos de entrenamiento, resultados de modelos y señales de deriva.
- Más usuarios (analistas, científicos de datos, equipos de producto) significa más vías de acceso y más formas de saltarse la directiva.
La gobernanza no es papeleo: es lo que te permite seguir entregando con seguridad
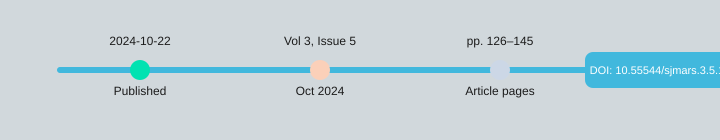
El estudio revisado por pares de Stallion Journal «Data Governance in Lakehouse» (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), publicado el 22-10-2024 en el Volumen 3, Número 5 (pp. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), plantea la gobernanza como una necesidad estratégica y, a la vez, como un requisito operativo imprescindible. El mensaje es sencillo: la gobernanza te protege en cumplimiento normativo (GDPR, HIPAA, CCPA), reduce riesgos y mantiene la calidad de los datos y la confianza de las partes interesadas.
Samarth Shah: «En un lakehouse, la velocidad sin gobernanza no es agilidad: es confusión más rápida».
En la práctica, la gobernanza de datos en lakehouse significa que puedes responder «¿qué es este KPI?» con pruebas: metadatos, entradas en el catálogo, controles de acceso (como RBAC), registros de auditoría y linaje. No es burocracia. Es el sistema que te permite entregar analítica rápidamente sin infringir la ley ni perder la confianza.
| Elemento de metadatos | Valor |
|---|---|
| Fecha de publicación | 22-10-2024 |
| Número de la revista | Volumen 3, Número 5 (oct. 2024) |
| Páginas | 126–145 |
| ISSN | 2583-3340 |
2) Cómo es una «buena gobernanza» cuando tus datos están en todas partes
En un lakehouse, tus datos no están «en un único lugar». Están repartidos entre tablas, archivos, flujos y características de ML, a menudo en plataformas como AWS, Snowflake o Databricks. Una buena gobernanza es lo que los mantiene utilizables y seguros sin frenar a los equipos. Piensa en ella como barandillas, no puertas: habilitas la analítica en tiempo real cumpliendo las expectativas de GDPR, HIPAA y CCPA.
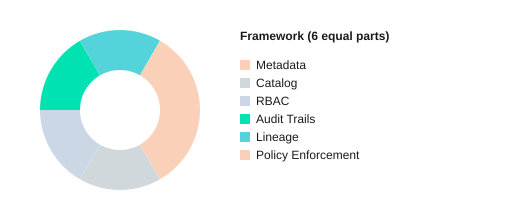
Los 6 bloques de construcción que realmente vas a implementar
- Gobernanza basada en metadatos: define propietarios, confidencialidad, retención y reglas de calidad en los metadatos para que los controles escalen con el volumen y el cambio.
- Buenas prácticas de catálogo de datos: un único lugar con capacidad de búsqueda para definiciones, etiquetas y conjuntos de datos de confianza, para que la gente deje de adivinar.
- Control de acceso RBAC: los roles se corresponden con las necesidades del puesto (analista, ingeniero, clínico), no con permisos ad hoc.
- Seguimiento del linaje de datos: muestra de dónde vienen los datos, cómo han cambiado y qué alimentan.
- Registros de auditoría: quién accedió a qué, cuándo y qué hizo, algo crítico para investigaciones y auditorías.
- Aplicación de directivas: comprobaciones automatizadas (enmascaramiento, retención, aprobaciones) que se ejecutan por defecto, no a petición.
Gobernanza documentada frente a gobernanza aplicada (solo una evita incidentes)
La gobernanza documentada es una página de wiki que dice «los datos PII deben enmascararse». La gobernanza aplicada es cuando tu lakehouse enmascara automáticamente los datos PII según las etiquetas de metadatos, bloquea las exportaciones arriesgadas y registra los accesos en los registros de auditoría. La investigación que sustenta la gobernanza moderna de lakehouse demuestra que la automatización y los metadatos reducen el tiempo y los errores de aplicación manual, porque la plataforma aplica las reglas de forma coherente.
Gobernanza unificada cuando gestionas tablas, archivos, flujos y características a la vez
Necesitas un plano de control único que funcione en tablas por lotes, archivos de almacenamiento de objetos, flujos tipo Kafka y conjuntos de características de ML. Cuando la gobernanza está unificada, el mismo control de acceso RBAC, las mismas etiquetas y las mismas directivas acompañan a los datos, de modo que tus paneles, cuadernos y modelos siguen alineados y cumpliendo la normativa.
Un inciso: cómo un «conjunto de datos compartido» se convierte en 12 versiones
Sin seguimiento del linaje de datos, un conjunto de datos «customer» acaba copiado en customer_v2, customer_clean, customer_final y «final_final». Pronto los equipos discuten por las cifras, porque nadie puede demostrar qué versión alimentó cada informe.
Shubham Jain: «El linaje marca la diferencia entre “creo que” y “puedo demostrarlo” cuando alguien cuestiona tus cifras».
Autoevaluación de 5 minutos
- ¿Puedes encontrar el propietario y la etiqueta de confidencialidad de tus 10 conjuntos de datos principales en el catálogo?
- ¿Son los roles (no las personas) los que controlan el acceso mediante RBAC?
- ¿Puedes rastrear un KPI hasta sus fuentes con el linaje en menos de 2 minutos?
- ¿Los registros de auditoría responden hoy a «quién vio o exportó esto»?
- ¿Las directivas se aplican automáticamente (enmascaramiento, retención, aprobaciones) y no de forma manual?
Cada control se traduce en resultados: menos incidentes de acceso (RBAC + directivas), auditorías más rápidas (registros de auditoría + catálogo) y analítica más limpia (metadatos + linaje).
3) Las cifras que hacen que la gobernanza deje de parecer un «gasto adicional»
Si la gobernanza te suena a «proceso extra», los resultados del artículo te ayudan a presentarla como una mejora operativa medible. Cuando aplicas gobernanza basada en metadatos con automatización y ML en un lakehouse, no solo estás «añadiendo controles»: recuperas tiempo, mejoras la confianza en los datos y reduces el riesgo de cumplimiento de una forma que un CFO puede seguir.
Gobernanza basada en metadatos: un ROI que cabe en una diapositiva
El estudio reporta tres resultados destacados cuando los equipos se apoyan en metadatos sólidos, catalogación, linaje y controles de acceso:
- Hasta un 40 % de mejora en la eficiencia de la gobernanza
- Un aumento del 35 % en la calidad de los datos
- Índices de cumplimiento del 92 % de GDPR y HIPAA (GDPR/HIPAA)
En términos prácticos, esa ganancia de eficiencia del 40 % suele significar menos revisiones manuales, menos bucles de «¿quién es el propietario de este conjunto de datos?» y aprobaciones más rápidas para el acceso y el uso compartido. Tu backlog se reduce porque las comprobaciones rutinarias pasan de las personas a los sistemas, y tu cola de incidentes baja porque llegan menos problemas a producción.
Aplicación automatizada de directivas: el antes y el después que cambia la conversación
La prueba más clara de «sobrecarga frente a beneficio» es el paso de los controles manuales a la aplicación automatizada de directivas:
- Tiempo de aplicación de directivas: 72 % → 28 %
- Tasa de errores: 45 % → 15 %
No es una optimización menor. Es la diferencia entre una gobernanza que actúa como barrera y una que actúa como barandilla. Dedicas menos tiempo a perseguir excepciones y más a habilitar el autoservicio seguro.
«La gobernanza unificada solo se mantiene cuando el flujo de trabajo es más fácil que la alternativa.» —Taylor, Singh, & Green (2021)
La realidad de la adopción: sólida entre los usuarios técnicos, más difícil para el resto
Las puntuaciones de usabilidad fueron altas entre científicos de datos, analistas de negocio y administradores de TI (4,2–4,7/5). Pero el artículo también señala una brecha habitual: los usuarios no técnicos necesitan interfaces más sencillas, definiciones más claras y flujos de trabajo guiados. Si quieres obtener las cifras de arriba, tienes que presupuestar la capacitación, no solo la herramienta.
Métricas clave de un vistazo
| Métrica | Resultado |
|---|---|
| Mejora en la eficiencia de la gobernanza | Hasta un 40 % |
| Aumento de la calidad de los datos | 35% |
| Índice de cumplimiento de GDPR y HIPAA | 92% |
| Tiempo de aplicación de directivas | 72 % (manual) frente a 28 % (automatizado) |
| Tasa de errores | 45 % (manual) frente a 15 % (automatizado) |
| Valoración de usabilidad | 4,2–4,7 sobre 5 |
| Reducción del tiempo de procesamiento | 25% |
4) Herramientas, prototipos y la cruda realidad de la implementación
Qué hizo la investigación (en términos sencillos)
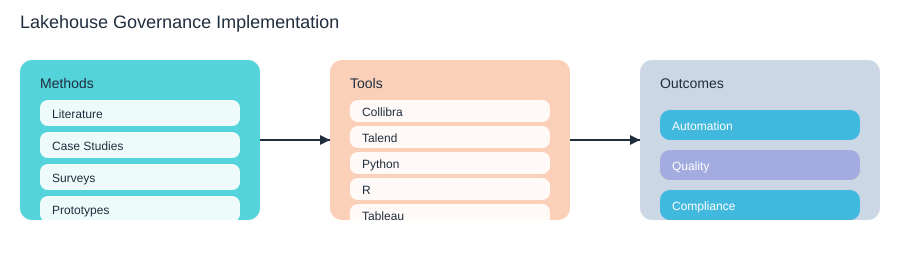
El estudio de Stallion Journal no trató la gobernanza como un problema de presentaciones. Utilizó cuatro métodos que reconocerás del trabajo real: revisó la literatura (revisiones sistemáticas), analizó casos de estudio del sector, encuestó a las partes interesadas y, por último, probó prototipos. Esa última parte es importante, porque la gobernanza de un lakehouse se rompe en los huecos entre la directiva y los pipelines, sobre todo cuando tus datos llegan rápido, cambian con frecuencia y proceden de muchos equipos.
Pila de prototipos: lo que realmente probaron
En la experimentación, el estudio usó Collibra y Talend para los patrones de gobernanza e integración, además de herramientas analíticas (Python, R, Tableau) para validar la usabilidad y los resultados. Puedes replicar este enfoque tanto si trabajas con gobernanza en Databricks, una configuración de lakehouse en Snowflake o una gobernanza de datos nativa de la nube más amplia, con Kubernetes, Docker, Kafka, Postgres, PySpark y Elasticsearch en el conjunto.
Una ruta de implantación que puedes copiar (y que se mantiene bajo control)
El éxito de la implementación depende de una gobernanza respaldada por herramientas y de tu capacidad para gestionar la velocidad, la complejidad y las restricciones de recursos. Una secuencia práctica es la siguiente:
- Empieza por el catálogo + RBAC: adopta las buenas prácticas de catálogo de datos (propiedad clara, términos de negocio y conjuntos de datos «dorados»). Después, asigna el acceso mediante RBAC.
- Añade el linaje: captura el impacto aguas arriba y aguas abajo para que los cambios no sorprendan a analistas ni auditores.
- Automatiza la aplicación: pasa de las aprobaciones manuales a políticas como código (policy-as-code) siempre que sea posible, con registros de auditoría.
Harris & Nguyen (2020): «RBAC es sencillo sobre el papel; se complica el día en que lo asignas a equipos y no a cargos.»
Tu enemigo diario: la velocidad y los flujos de datos inconsistentes
Los flujos de alta velocidad (piensa en streams al estilo de Kafka) generan “deriva de esquema”, eventos tardíos y registros duplicados. Ahí es donde la gobernanza se vuelve caótica: tu catálogo dice que un campo es obligatorio, pero el stream lo omite; tus reglas de calidad esperan una marca de tiempo, pero los productores envían tres. El estudio señala esto como un obstáculo recurrente, sobre todo cuando los equipos tienen poco personal.
Proliferación de herramientas: cuando los sistemas no coinciden
Cuidado con el clásico problema de split-brain: tu catálogo muestra que el conjunto de datos A está “restringido”, pero los grupos de IAM siguen permitiendo un acceso amplio. O bien, tus directivas de gobernanza de Databricks no coinciden con lo configurado en la IAM de la nube. Trata “una única fuente de verdad” como un objetivo de diseño, no como un eslogan.
| Criterio para decidir | Mantenlo simple |
|---|---|
| Comprar o construir | Compra para el catálogo y los flujos de trabajo; construye solo conectores y comprobaciones ligeros. |
| Evita un laberinto de gobernanza | Un catálogo, un modelo de directivas, roles personalizados mínimos y auditorías automatizadas. |
5) Los principales puntos débiles de la gobernanza (y cómo los priorizas)
Si sientes que la gobernanza es más difícil de lo que “debería” ser, no estás solo. En la síntesis de la investigación, el 78 % de las organizaciones cita el desafío de la gestión de metadatos como el principal punto débil. Esa cifra debería hacerte sentir comprendido, porque en un lakehouse todo se mueve rápido, y los metadatos son el mapa que intentas actualizar mientras las carreteras todavía se están construyendo.
Por qué los metadatos fallan primero (y siguen fallando)
Los metadatos son difíciles porque:
- Las definiciones se desvían: “Cliente activo” significa una cosa para Finanzas y otra para Growth.
- La propiedad no está clara: nadie tiene claro quién aprueba un campo nuevo, una tabla nueva o una nueva regla de retención.
- Los pipelines cambian cada semana: nuevas fuentes, nuevos joins, nuevas características de ML; tu catálogo y tus etiquetas se quedan atrás.
Y, aun así, cuando inviertes en gobernanza obtienes retornos medibles: el 88 % informa de una mejor gobernanza de la calidad de los datos, y el 81 % informa de una mejor gobernanza de la seguridad del lakehouse. Esa es la recompensa por hacer el trabajo poco vistoso.
Triaje de la gobernanza: arregla lo correcto en el orden correcto
- Primero, metadatos y propiedad: define los elementos de datos críticos, asigna un propietario y un responsable de datos, y estandariza los términos de negocio en tu catálogo.
- Después, control de acceso: implementa RBAC con el mínimo privilegio, junto con rutas de aprobación claras para las excepciones.
- Linaje y registros de auditoría: registra de dónde vienen los datos, cómo cambiaron y quién los tocó; aquí es donde las preguntas sobre GDPR/HIPAA/CCPA se responden rápido.
- La automatización va al final (pero de forma constante): automatiza las comprobaciones de directivas, el etiquetado y la detección de anomalías para que la aplicación no dependa de héroes.
¿Qué se rompe cuando HIPAA se encuentra con CCPA?
Imagina un lakehouse donde un conjunto de datos sanitarios regulado por HIPAA (encuentros con pacientes) se une a un conjunto de datos de marketing cubierto por CCPA (comportamiento web). Lo primero que suele romperse es la clasificación y el consentimiento: faltan las etiquetas de PHI, las marcas de consentimiento no se propagan a través de los joins y un panel posterior expone más de lo previsto. Sin linaje no puedes demostrar adónde fueron los datos; sin RBAC no puedes frenar el acceso amplio; y sin registros de auditoría e gestión de identidades no puedes demostrar la responsabilidad.
“El verdadero desafío no es hacer que la IA funcione, sino hacer que funcione de forma responsable dentro de los sistemas que ya tienes.”
— Dr. Fei-Fei Li
Un ritual sencillo que te mantiene cuerdo: la retrospectiva mensual de gobernanza
Realiza una retrospectiva mensual de 45 minutos con los responsables de TI, seguridad y negocio. Revisa: los 3 principales huecos en los metadatos, las 3 principales excepciones de acceso, un fallo de linaje y una mejora de automatización. Registra las acciones en un tracker compartido y asigna un único responsable por cada elemento.
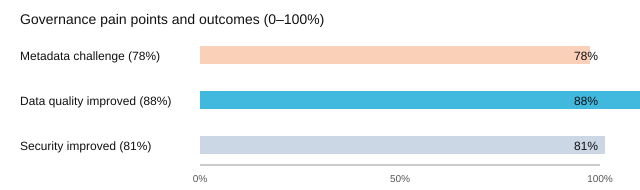
6) Cumplimiento sin paranoia: GDPR, HIPAA y CCPA en el lakehouse
En un lakehouse, trata el cumplimiento como una restricción de diseño, no como una carrera de última hora. Cuando incorporas los controles en la ingesta, el almacenamiento y el acceso desde el primer día, el cumplimiento de GDPR y HIPAA y la gobernanza de datos de CCPA dejan de parecer simulacros de incendio y pasan a ser operaciones normales. El estudio de Stallion Journal sobre “Data Governance in Lakehouse” muestra por qué: las organizaciones que usan gobernanza basada en metadatos, automatización y ML registraron tasas de cumplimiento de GDPR y HIPAA que subieron hasta el 92 %. Úsalo como un referente de referencia, no como una garantía.
“La seguridad es un proceso, no un producto, y la gobernanza es la forma de mantener ese proceso honesto.”
—Bruce Schneier
Asigna los controles a las regulaciones: tu kit de cumplimiento básico
No se "cumple con el RGPD" ni con "HIPAA" solo escribiendo directivas. Hay que asignar los requisitos a controles repetibles dentro del lakehouse:
- RBAC (control de acceso basado en roles): limita quién puede ver PHI/PII y quién puede exportarla.
- Registros de auditoría del lakehouse: demuestra quién accedió a qué, cuándo, desde dónde y qué hizo.
- Linaje de datos: muestra de dónde proceden los campos sensibles, cómo han cambiado y adónde han llegado.
- Aplicación de directivas: aplica el enmascaramiento, la retención y los límites de finalidad de forma coherente en todas las herramientas.
- Gestión de metadatos + catálogo: clasifica los datos, etiqueta la sensibilidad y habilita la automatización.
| Normativa | Lo que buscan los auditores | Control en el lakehouse |
|---|---|---|
| RGPD | Acceso lícito, minimización, retención | RBAC, enmascaramiento, directivas de retención, linaje |
| HIPAA | Registros de acceso, salvaguardas, mínimo privilegio | Registros de auditoría, RBAC, cifrado, monitorización |
| CCPA | Inventario de datos, gestión de accesos y eliminaciones | Catálogo + metadatos, linaje, flujos de directivas |
La siguiente ola: normativas regionales y restricciones heredadas
El estudio señala trabajo futuro que conviene planificar desde ya: cumplimiento específico por región y mejor adaptabilidad para entornos heredados o con restricciones. Si operas en varios estados o países, diseña directivas que puedan variar según la región (plazos de retención, reglas de consentimiento, notificación de brechas). Si todavía mantienes sistemas antiguos, empieza con un alcance más reducido e integra de forma gradual: la automatización ayuda, pero la complejidad es real.
Recorrido por el "día de auditoría": qué tendrás que demostrar
- Inventario de datos: dónde están los PII/PHI, sus propietarios y su finalidad (
catalog + tags). - Evidencias de acceso: roles RBAC, aprobaciones y exportaciones de registros de auditoría del lakehouse.
- Prueba de linaje: rutas de origen a informe para los conjuntos de datos clave y las columnas sensibles.
- Prueba de directivas: enmascaramiento, retención, flujos de eliminación y registros de aplicación.
- Quién debe estar en la sala: propietario de los datos, seguridad, administrador de la plataforma, cumplimiento/legal y un analista que use los datos.
Vista radar: línea base frente a lakehouse gobernado
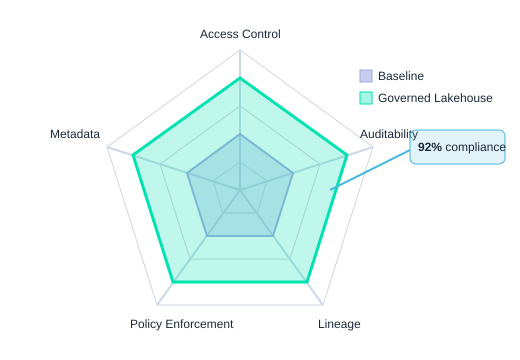
Un inciso breve y sincero: si eres una organización pequeña, empieza con una línea base sencilla (RBAC, registro y un catálogo ligero) antes de comprar herramientas empresariales. El estudio deja claro que la complejidad de implementación puede ser una barrera real, sobre todo cuando los recursos son escasos.
7) Sesgo de proveedores, política y lo que las presentaciones de gobernanza omiten
Puedes diseñar un modelo de gobernanza del lakehouse impecable sobre el papel y verlo torcerse en cuanto entren en juego las herramientas de gobernanza de datos. La realidad incómoda es simple: las herramientas y los proveedores moldean lo que parece "buenas prácticas", porque moldean lo que es fácil de demostrar, fácil de comprar y fácil de informar.
El estudio sobre lakehouse de Stallion Journal aborda esto directamente en su sección de conflictos de interés. Señala tres fuentes de sesgo que debes asumir presentes en cualquier programa de gobernanza: sesgo de proveedor (favorecer plataformas como las suites de gobernanza Collibra Talend u otras suites comerciales), sesgo de informes de la organización (compartir solo métricas de "éxito") y presiones financieras y regulatorias (elegir lo que parece más seguro ante los auditores, no lo que encaja con tu arquitectura). La conclusión de la investigación es clara: la transparencia y la divulgación son necesarias para preservar la integridad de la investigación y para que tus decisiones de gobernanza sigan siendo útiles más allá de los discursos de los proveedores.
Satya Nadella: "La confianza es la moneda definitiva, y en los datos se gana siendo explícito sobre lo que hiciste y por qué."
Riesgos de sesgo que debes nombrar en voz alta
Investigación de gobernanza y riesgos de sesgo en herramientas: sesgo de proveedor 40 %, sesgo de informes 35 %, financiero/regulatorio 25 %. Sesgo de proveedor, sesgo de informes, financiero/regulatorio
Tu lista de control contra el sesgo (práctica, no política)
- Muestreo: compara al menos una suite comercial y una opción abierta en los ecosistemas de AWS, Snowflake, Databricks, SAP y Oracle Cloud Infrastructure.
- Divulgación: documenta los patrocinadores, las razones de selección de herramientas y lo que no probaste.
- Criterios de evaluación: profundidad del linaje, ajuste de RBAC/ABAC, registros de auditoría, acceso por API, formatos de exportación e integración con tus tablas del lakehouse.
- Prueba de valor: ejecuta un piloto con plazo definido en un solo dominio; mide el tiempo de aplicación de directivas, la tasa de errores y la fricción para los usuarios.
- Comprobación de riesgo de dependencia de proveedor en la plataforma de datos: pregunta cómo se manifiesta el bloqueo (lock-in) en los metadatos, los catálogos y las reglas de flujo de trabajo.
Mini historia: tú medias en la decisión real
Compras impulsa un único proveedor en nombre de la "estandarización". Los ingenieros quieren código abierto para tener control. Cumplimiento quiere funciones "certificadas" y evidencias de auditoría limpias. Tu trabajo es traducir: puedes cumplir con cumplimiento mediante controles sólidos y trazas de auditoría, satisfacer a los ingenieros con APIs y portabilidad, y satisfacer a Compras con un ROI claro, sin permitir que ningún grupo defina la gobernanza como "lo que la herramienta venda".
¿Qué pasa si tu herramienta es adquirida y el precio se triplica?
Asúmelo como posible. Prueba la portabilidad ahora: ¿puedes exportar tu glosario de negocio, linaje y reglas de directiva en formatos utilizables? Si tus metadatos no pueden moverse, tu gobernanza no es un programa, es una suscripción.
8) Preparación para el futuro: IoT, edge, datos descentralizados y el lakehouse que heredarás
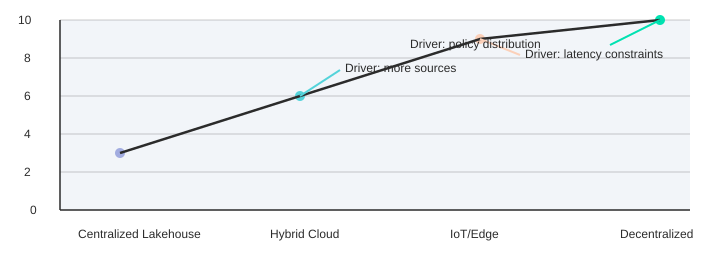
La gobernanza de tu lakehouse funciona mejor cuando los datos están centralizados en gran medida, son aptos para procesamiento por lotes y los controlan unas pocas plataformas. La gobernanza de IoT y de la computación en el edge rompe esas suposiciones rápidamente: te enfrentas a más fuentes (dispositivos, pasarelas, aplicaciones), menos control central (los equipos despliegan de forma independiente) y límites de latencia más estrictos (no puedes "esperar al trabajo nocturno" para decidir el acceso o la calidad). El estudio de Stallion Journal señala directamente esta presión y recomienda extensiones de gobernanza para tres ámbitos emergentes: lagos de datos IoT, arquitecturas descentralizadas y computación en el edge.
Por qué IoT y el edge ponen a prueba tu modelo actual
En los flujos de IoT, el mismo evento de "cliente" puede llegar desde varios sensores, en distintos formatos y en momentos diferentes. Si tus directivas dependen de una única actualización del catálogo central, o ralentizarás las operaciones o aceptarás puntos ciegos. Las ubicaciones de edge también crean copias locales de los datos para mejorar la velocidad y la resiliencia, lo que significa que tus trazas de auditoría, linaje y reglas de retención deben viajar con los datos, y no quedarse atrapadas en un plano de control tipo almacén de datos.
La arquitectura de datos descentralizada necesita una gobernanza portable
En una arquitectura de datos descentralizada, los dominios publican productos de datos y evolucionan sus esquemas con sus propios calendarios. Eso es sano para la velocidad de entrega, pero arriesgado si tus definiciones de "PII", "consentimiento" o "alcance de HIPAA" no son coherentes. Preparar el futuro significa diseñar la gobernanza como un servicio compartido: metadatos extensibles, directivas versionadas y controles de identidad que funcionen entre equipos y regiones, en línea con la petición del estudio de adaptabilidad al cumplimiento normativo específico de cada región.
Apóyate en bloques nativos de la nube que puedas heredar
El conjunto de referencias en torno al estudio te orienta hacia bloques de construcción prácticos: Docker para empaquetar los servicios de directivas, Kubernetes para ejecutarlos en cualquier lugar, Kafka para los enganches de aplicación de directivas en streaming, Elasticsearch para un descubrimiento rápido y Postgres/PySpark para el procesamiento gobernado. No eliges herramientas por moda: eliges lo que puede ejecutarse en la nube, en local y en el edge con los mismos controles.
"Todo falla, todo el tiempo: diseña la gobernanza esperando cambio, no estabilidad." — Werner Vogels
Una hoja de ruta de apuestas pequeñas que te mantiene en movimiento
No necesitas resolver hoy la gobernanza del edge por completo. Sí necesitas sistemas de metadatos y directivas que puedan ampliarse sin reescrituras. Empieza piloteando la detección de anomalías basada en IA sobre las señales de gobernanza (deriva de esquemas, rutas de acceso inusuales, exportaciones fuera de patrón) y después amplía a comprobaciones automatizadas de directivas en la ingesta y en el momento de la consulta. A medida que crezca tu superficie, añade una gestión de identidades más sólida, considera una evidencia de manipulación al estilo blockchain para las trazas de auditoría críticas y planifica la recuperación ante desastres acorde con tu nivel de riesgo.
| Entorno | Índice de complejidad de gobernanza (ilustrativo) |
|---|---|
| Lakehouse centralizado | 3 |
| Nube híbrida | 6 |
| IoT/Edge | 9 |
| Descentralizado | 10 |
Escribe tus principios de gobernanza como si fueras a ser reemplazado: definiciones claras, directivas portables y registros de decisiones que sobrevivan a las reorganizaciones. El lakehouse que heredes más adelante será más desordenado que hoy, y tu yo futuro dormirá mejor si diseñas para eso desde ahora.
Arquitectura de lakehouse en Microsoft Fabric: comprender Microsoft Fabric para análisis e ingeniería de datos
¿Qué es la arquitectura de lakehouse de Microsoft Fabric?
La arquitectura de lakehouse de Microsoft Fabric es un diseño de plataforma de datos unificada que combina elementos de los lagos de datos y los almacenes de datos para guardar datos sin procesar y conjuntos de datos estructurados y transformados en una única ubicación. Utiliza Azure Data Lake Storage para los volúmenes de datos, los motores de procesamiento de Fabric para el procesamiento y los patrones de arquitectura medallion para gestionar las capas sin procesar, enriquecida y curada, de modo que los equipos puedan analizar datos, ejecutar cargas de trabajo de ciencia de datos y alimentar informes en Power BI sin duplicar datos.
¿Cómo funciona la arquitectura medallion en un lakehouse de Fabric?
La arquitectura medallion en Fabric organiza los datos en capas: normalmente bronce (datos sin procesar), plata (limpios y enriquecidos) y oro (curados y listos para análisis e informes de BI). Fabric integra herramientas de ingesta y transformación de datos para mover y transformar los datos entre capas, lo que permite flujos de trabajo de ingeniería y preparación de datos que mantienen una única copia de tus datos y reducen la duplicación, a la vez que dan soporte al análisis y a la ciencia de datos.
¿Cómo implemento un lakehouse en Microsoft Fabric y cómo creo uno?
Para implementar un lakehouse en Microsoft Fabric, empieza por conectar tus orígenes de datos e ingiere los datos en un Azure Data Lake mediante las capacidades de ingesta de datos de Fabric. Utiliza los motores de procesamiento de Fabric o las transformaciones de dataflows para aplicar el procesamiento de la arquitectura medallion, cataloga los conjuntos de datos en OneLake y protege el acceso. Integra Power BI y otras herramientas analíticas para los informes. La plataforma simplifica la gestión de datos, admite la integración de datos existentes y de big data, y permite transformar los datos sin moverlos innecesariamente.
¿Cuál es la diferencia entre un lakehouse y un almacén de datos tradicional en Microsoft Fabric?
Un lakehouse combina la flexibilidad de los lagos de datos para datos sin procesar y semiestructurados con el rendimiento y la gestión de esquemas de un almacén de datos. En Microsoft Fabric, el lakehouse permite almacenar datos en Azure Data Lake Storage y, al mismo tiempo, ofrece un rendimiento de consulta similar al de un almacén gracias a los motores de procesamiento de Fabric. Esto permite disfrutar de las capacidades de un almacén de datos, como datos estructurados y curados para análisis, sin renunciar a la flexibilidad de un lago de datos para tareas modernas de datos e ingeniería de datos.
¿Cómo gestiona Fabric la ingesta de datos y evita la duplicación de datos?
Fabric admite varios patrones de ingesta de datos (streaming, por lotes y conectores a orígenes de datos empresariales) hacia un lago central (Azure Data Lake). Gracias a la arquitectura medallion y a OneLake, Fabric promueve una única copia de tus datos y conjuntos de datos lógicos en lugar de copias físicas duplicadas. Las herramientas de integración y transformación de datos te permiten ingerir datos, transformarlos en su ubicación y ofrecer un acceso coherente a las cargas de trabajo de análisis y ciencia de datos, minimizando la duplicación de datos entre sistemas.
¿Puedo usar almacenes de datos existentes y datos de Azure junto con un lakehouse de Fabric?
Sí. Fabric se integra con sistemas de Microsoft y de terceros, lo que te permite federar consultas a almacenes de datos existentes, a Synapse y a Azure Data Lake Storage, a la vez que consolidas el acceso a tu ecosistema de datos. Puedes ingerir o referenciar datos existentes, implementar patrones de data mesh y decidir si mueves los datos al lakehouse o accedes a ellos directamente, en función de las necesidades de gobernanza, coste y rendimiento.
¿Cuáles son los casos de uso habituales de un lakehouse de Fabric en análisis y ciencia de datos?
Entre los casos de uso habituales están la gestión unificada de datos para BI con Power BI, la preparación de grandes conjuntos de datos sin procesar para aprendizaje automático y ciencia de datos, la creación de pipelines ELT con la arquitectura medallion, el análisis de datos de sistemas empresariales y la creación de una ubicación única para datos estructurados y no estructurados. Fabric simplifica el procesamiento de datos, permite analizar datos a escala y da soporte a arquitecturas de datos modernas como data mesh y los catálogos de datos empresariales.
¿Cómo funcionan la seguridad, la gobernanza y el acceso a los datos en un lakehouse de Fabric?
Fabric ofrece control de acceso basado en roles, directivas de datos e integración con Microsoft Purview y Azure Active Directory para la gobernanza y el linaje de datos. OneLake y los elementos del lakehouse permiten definir permisos detallados sobre los datos almacenados en Azure Data Lake Storage, lo que garantiza un acceso seguro a los datos, el cumplimiento normativo y flujos de trabajo de preparación de datos controlados, manteniendo la auditabilidad en todos los pasos de ingesta y transformación.
¿Qué motores de procesamiento de Fabric debo usar para las distintas cargas de trabajo en el lakehouse?
Fabric ofrece varios motores de cómputo optimizados para cargas de trabajo específicas: consultas SQL interactivas para análisis y BI, Spark para el procesamiento de big data e ingeniería de datos, y motores especializados para la ingesta en tiempo real. Elige los motores de cómputo de Fabric según las características de cada carga de trabajo: usa Spark para transformaciones a gran escala, SQL de almacenamiento para consultas de BI y motores de streaming para la ingesta continua, de forma que se equilibren el coste, el rendimiento y las necesidades de procesamiento de datos.
¿Dónde puedo aprender más y empezar con la arquitectura de lakehouse de Microsoft Fabric?
Para empezar, sigue los tutoriales de Microsoft Learn, revisa la documentación sobre la arquitectura de lakehouse en Microsoft Fabric y explora ejemplos de arquitectura medallion en Fabric. Comienza conectando un origen de datos, ingiriendo los datos sin procesar en Azure Data Lake Storage, implementando un pipeline medallion sencillo y visualizando los resultados en Power BI para entender cómo Fabric simplifica la creación de un lakehouse y la entrega de análisis desde un entorno de datos unificado.