 PL
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Zarządzaj danymi w jeziorze domów (lakehouse) w Microsoft Fabric: architektura bez nieprzespanych nocy
By Mirko Peters · · Updated
Zarządzaj danymi w architekturze lakehouse w Microsoft Fabric bez nieprzespanych nocy. Uprość analitykę dzięki solidnemu, łatwemu w utrzymaniu rozwiązaniu.
Automatically translated with AI from the original post. Read the English original
Znasz ten niezręczny moment na spotkaniu, gdy ktoś pyta: „Czy możemy udowodnić, skąd wzięła się ta liczba?”, a w sali zapada cisza? Widziałem, jak ta cisza się przeciąga w firmach, które miały „wszystkie dane”, ale nie miały żadnych dowodów. Lakehouse obiecuje jedną platformę do wszystkiego: tabele strukturalne, chaotyczne pliki, strumienie danych w czasie rzeczywistym, cechy dla uczenia maszynowego. Ta obietnica działa jednak tylko wtedy, gdy potrafisz zarządzać tym wszystkim, nie krępując zespołów. Ten wpis w dużej mierze opiera się na badaniu „Data Governance in Lakehouse” (Shah & Jain) z października 2024 roku, opublikowanym w Stallion Journal, a następnie dodaje warstwę ludzką: skróty, na które będziesz kusić, polityczne przepychanki, z którymi się zetkniesz, oraz proste nawyki, które pozwolą uniknąć paniki wywołanej audytem.
8 zaskakujących faktów o zarządzaniu w lakehouse w Microsoft Fabric- Zunifikowane zarządzanie artefaktami: Zarządzanie w Fabric obejmuje w jednolity sposób tabele, pliki, notatniki, potoki i pulpity lakehouse, co umożliwia scentralizowane zasady obejmujące zarówno dane, jak i artefakty analityczne.
- Automatyczne przechwytywanie pochodzenia danych: Pochodzenie danych (lineage) jest przechwytywane automatycznie dla wielu operacji (pobieranie, przekształcenia, notatniki i pulpity), co zapewnia niemal natychmiastowy wgląd w proweniencję danych bez dodatkowej instrumentacji.
- Integracja zabezpieczeń na poziomie wierszy i kolumn: Lakehouse obsługuje szczegółowe kontrole dostępu (na poziomie wierszy i kolumn) egzekwowane w czasie zapytania, dzięki czemu kontrolowany dostęp podąża za danymi, niezależnie od silnika, który je wykorzystuje.
- Wbudowana klasyfikacja danych i etykiety poufności: Fabric udostępnia klasyfikację danych (typy informacji wrażliwych) i integruje się z etykietami poufności usługi Microsoft Purview, dzięki czemu zarządzanie może wykorzystywać wykryte klasyfikacje do egzekwowania zasad.
- Zasady jako kod dla kontroli cyklu życia: Zasady zarządzania (przechowywanie, bramki jakości, szyfrowanie, dozwolone zasoby obliczeniowe) mogą być definiowane i stosowane programowo, co umożliwia automatyczne egzekwowanie w całym cyklu życia lakehouse.
- Płynna izolacja dzierżaw i obszarów roboczych: Model zarządzania w Fabric obsługuje izolację wielu obszarów roboczych oraz zasady uwzględniające dzierżawę, dzięki czemu możesz ograniczyć udostępnianie i przepływ danych między projektami, zachowując jednocześnie kontrolowaną współpracę.
- Audytowalne dzienniki zmian i dostępu: Wszystkie operacje istotne dla zarządzania (odczyty i zapisy danych, zmiany zasad, przypisania ról) podlegają audytowi, a generowane dzienniki integrują się z Microsoft Sentinel i systemami SIEM na potrzeby monitorowania zgodności.
- Kontrakty danych wspierane przez zarządzanie: Fabric umożliwia tworzenie kontraktów danych i schematów z wymuszaniem kontroli zgodności, dzięki czemu odbiorcy otrzymują stabilne, zarządzane interfejsy do danych lakehouse, a producenci mogą bezpiecznie rozwijać swoje rozwiązania.
1) Problem „cichego spotkania”: dlaczego lakehouse potrzebuje zarządzania
Jesteś na przeglądzie kierownictwa. Na ekranie pojawia się wskaźnik KPI: retencja przychodów, czas oczekiwania pacjentów, ryzyko odejścia klientów. Ktoś pyta: „Skąd się wzięła ta liczba?”. W sali zapada cisza. Nie potrafisz prześledzić zbioru danych, przekształcenia ani tego, kto tydzień temu zmienił logikę. W tej chwili nie masz problemu z analityką, tylko problem z zaufaniem do danych.
Lakehouse prostym językiem: jeden dach, dwie obietnice
Lakehouse to praktyczne połączenie: elastyczność jeziora danych (przechowuj wszystko, szybko) oraz niezawodność hurtowni danych (spójne tabele, wysoka wydajność). Pod jednym dachem możesz zarządzać danymi strukturalnymi i niestrukturalnymi, uruchamiać analitykę w czasie rzeczywistym i obsługiwać obciążenia uczenia maszynowego. Właśnie ta wartość „wszystko w jednym” sprawia, że strategia architektury lakehouse musi uwzględniać zarządzanie od pierwszego dnia.
Dlaczego lakehouse zwiększa potrzeby w zakresie zarządzania danymi w lakehouse
Lakehouse działa szybko: strumienie danych, częste ponowne trenowanie modeli i wiele zespołów wdrażających jednocześnie pulpity. Ta szybkość mnoży ryzyko. Różnorodne typy danych i wiele narzędzi ułatwiają utratę kontroli nad definicjami, uprawnieniami i pochodzeniem danych. Gdy nie potrafisz wyjaśnić wskaźnika, interesariusze przestają ufać pulpitowi, nawet jeśli liczba jest poprawna.
- Dane w czasie rzeczywistym zwiększają ryzyko niespójnych migawek danych i wskaźników KPI, które stale się zmieniają.
- Potoki uczenia maszynowego dodają nowe zasoby do zarządzania: cechy, zbiory treningowe, wyniki modeli i sygnały dryfu.
- Więcej użytkowników (analityków, data scientistów, zespołów produktowych) oznacza więcej ścieżek dostępu i więcej sposobów na złamanie zasad.
Zarządzanie danymi to nie biurokracja, tylko sposób na bezpieczne dostarczanie kolejnych zmian
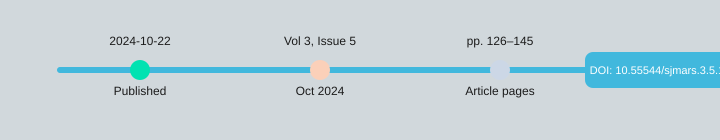
Recenzowane badanie „Data Governance in Lakehouse” (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), opublikowane w czasopiśmie Stallion Journal, ukazało się 22-10-2024 w tomie 3, numerze 5 (s. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12). Autorzy traktują zarządzanie danymi zarówno jako strategiczną konieczność, jak i wymóg operacyjny. Przesłanie jest proste: zarządzanie chroni zgodność z przepisami (GDPR, HIPAA, CCPA), ogranicza ryzyko i podtrzymuje jakość danych oraz zaufanie interesariuszy.
Samarth Shah: „W lakehouse szybkość bez zarządzania to nie zwinność, tylko po prostu szybsze zamieszanie.”
W praktyce zarządzanie danymi w lakehouse oznacza, że na pytanie „co to za wskaźnik KPI?” możesz odpowiedzieć, popierając odpowiedź dowodami: metadanymi, wpisami w katalogu, kontrolami dostępu (np. RBAC), śladami audytu i pochodzeniem danych (lineage). To nie biurokracja. To system, który pozwala dostarczać analitykę szybko, bez łamania prawa i bez utraty zaufania.
| Element metadanych | Wartość |
|---|---|
| Data publikacji | 22-10-2024 |
| Numer czasopisma | Tom 3, numer 5 (paździenik 2024) |
| Strony | 126–145 |
| ISSN | 2583-3340 |
2) Jak wygląda „dobre zarządzanie”, gdy dane są wszędzie
W lakehouse Twoje dane nie są „w jednym miejscu”. Rozciągają się na tabele, pliki, strumienie i cechy ML, często na platformach takich jak AWS, Snowflake czy Databricks. Dobre zarządzanie to sposób, by zachować ich użyteczność i bezpieczeństwo bez spowalniania zespołów. Traktuj je jak barierki, a nie bramki: umożliwiasz analitykę w czasie rzeczywistym, spełniając jednocześnie wymagania GDPR, HIPAA i CCPA.
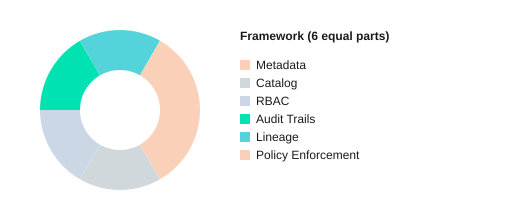
6 elementów, które faktycznie wdrożysz
- Zarządzanie oparte na metadanych: definiuj właścicieli, poufność, okresy przechowywania i reguły jakości w metadanych, tak aby kontrole skalowały się wraz z wolumenem danych i zmianami.
- Najlepsze praktyki katalogowania danych: jedno przeszukiwalne miejsce na definicje, tagi i zaufane zbiory danych, dzięki czemu ludzie przestają zgadywać.
- Kontrola dostępu RBAC: role odpowiadają potrzebom wynikającym z zadań (analityk, inżynier, klinicysta), a nie doraźnym uprawnieniom.
- Śledzenie pochodzenia danych (data lineage): pokazuj, skąd pochodzą dane, jak się zmieniały i czym zasilane są dalej.
- Ślady audytu: kto miał dostęp do czego, kiedy i co z tym zrobił. Kluczowe przy dochodzeniach i audytach.
- Egzekwowanie zasad: zautomatyzowane kontrole (maskowanie, przechowywanie, zatwierdzanie), które działają domyślnie, a nie na żądanie.
Zarządzanie udokumentowane a wymuszane (tylko jedno zapobiega incydentom)
Zarządzanie udokumentowane to strona wiki mówiąca, że „dane PII muszą być maskowane”. Zarządzanie wymuszane oznacza, że Twoje lakehouse automatycznie maskuje dane PII na podstawie tagów metadanych, blokuje ryzykowne eksporty i zapisuje dostęp w śladach audytu. Badania nad nowoczesnym zarządzaniem lakehouse pokazują, że automatyzacja i metadane skracają czas ręcznego egzekwowania reguł i ograniczają błędy, ponieważ platforma stosuje je konsekwentnie.
Zunifikowane zarządzanie, gdy żonglujesz tabelami, plikami, strumieniami i cechami
Potrzebujesz jednej płaszczyzny kontroli, która działa w tabelach wsadowych, plikach w magazynie obiektów, strumieniach w stylu Kafki i zestawach cech ML. Gdy zarządzanie jest zunifikowane, te same kontrole RBAC, tagi i zasady podążają za danymi, dzięki czemu pulpity, notatniki i modele pozostają spójne i zgodne z wymogami.
Mała dygresja: jak „jeden wspólny zbiór danych” staje się 12 wersjami
Bez śledzenia pochodzenia danych (data lineage) zbiór „customer” zostaje skopiowany do customer_v2, customer_clean, customer_final i „final_final”. Wkrótce zespoły spierają się o liczby, bo nikt nie potrafi udowodnić, która wersja zasiliła który raport.
Shubham Jain: „Lineage to różnica między »chyba tak« a »mogę to udowodnić«, gdy ktoś kwestionuje Twoje liczby.”
Samokontrola w 5 minut
- Czy w katalogu znajdziesz właściciela i tag poufności dla 10 najważniejszych zbiorów danych?
- Czy to role (a nie poszczególne osoby) kontrolują dostęp za pomocą RBAC?
- Czy potrafisz prześledzić wskaźnik KPI do źródeł za pomocą lineage w mniej niż 2 minuty?
- Czy ślady audytu odpowiadają dziś na pytanie „kto wyświetlił lub wyeksportował to”?
- Czy zasady są egzekwowane automatycznie (maskowanie, przechowywanie, zatwierdzanie), a nie ręcznie?
Każda kontrola przekłada się na konkretne efekty: mniej incydentów dostępu (RBAC + zasady), szybsze audyty (ślady audytu + katalog) i czystsza analityka (metadane + lineage).
3) Liczby, które sprawiają, że zarządzanie przestaje wyglądać jak „narzut”
Jeśli zarządzanie danymi brzmi jak „dodatkowa biurokracja”, wyniki badania pomogą spojrzeć na nie jako na mierzalną korzyść operacyjną. Gdy stosujesz zarządzanie oparte na metadanych z automatyzacją i uczeniem maszynowym w lakehouse, nie „dokładasz kontrole”. Odzyskujesz czas, zwiększasz zaufanie do danych i ograniczasz ryzyko zgodności w sposób, który dyrektor finansowy może śledzić.
Zarządzanie oparte na metadanych: zwrot z inwestycji, który można pokazać na slajdzie
Badanie podaje trzy najważniejsze wyniki, gdy zespoły opierają się na silnych metadanych, katalogowaniu, pochodzeniu danych (lineage) i kontroli dostępu:
- Do 40% poprawy efektywności zarządzania
- 35% wzrost jakości danych
- Wskaźnik osiągnięcia zgodności z RODO i HIPAA: 92% (GDPR/HIPAA)
W praktyce 40% wzrost efektywności oznacza zwykle mniej ręcznych przeglądów, mniej pętli typu „kto jest właścicielem tego zbioru danych?” i szybsze zatwierdzanie dostępu oraz udostępniania. Backlog się zmniejsza, bo rutynowe sprawdzenia przechodzą z ludzi na systemy, a kolejka incydentów spada, bo do środowiska produkcyjnego trafia mniej problemów.
Automatyczne egzekwowanie zasad: przed i po, które zmieniają dyskusję
Najwyraźniejszym dowodem na relację „koszt kontra korzyść” jest przejście od ręcznych kontroli do automatycznego egzekwowania zasad:
- Czas egzekwowania zasad: 72% → 28%
- Wskaźnik błędów: 45% → 15%
To nie jest drobna optymalizacja. To różnica między zarządzaniem jako bramką a zarządzaniem jako barierką ochronną. Mniej czasu spędzasz na ściganiu wyjątków, a więcej na umożliwianiu bezpiecznego samoobsługowego dostępu do danych.
„Zunifikowane zarządzanie utrzymuje się tylko wtedy, gdy proces jest łatwiejszy niż obejście.” —Taylor, Singh, & Green (2021)
Rzeczywistość wdrożenia: dobrze dla użytkowników technicznych, trudniej dla pozostałych
Oceny użyteczności były wysokie wśród naukowców danych, analityków biznesowych i administratorów IT (4,2–4,7/5). Badanie zwraca jednak uwagę na powszechną lukę: użytkownicy nietechniczni potrzebują prostszych interfejsów, jaśniejszych definicji i prowadzonych procesów. Jeśli chcesz osiągnąć wyniki podane powyżej, musisz zaplanować budżet na szkolenia i wsparcie, a nie tylko na narzędzia.
Kluczowe wskaźniki w skrócie
| Wskaźnik | Wynik |
|---|---|
| Poprawa efektywności zarządzania | Do 40% |
| Wzrost jakości danych | 35% |
| Wskaźnik zgodności z RODO i HIPAA | 92% |
| Czas egzekwowania zasad | 72% (ręcznie) vs 28% (automatycznie) |
| Wskaźnik błędów | 45% (ręcznie) vs 15% (automatycznie) |
| Ocena użyteczności | 4,2–4,7 z 5 |
| Skrócenie czasu przetwarzania | 25% |
4) Narzędzia, prototypy i niejednoznaczna prawda o wdrażaniu
Co zrobiło badanie (prostymi słowami)
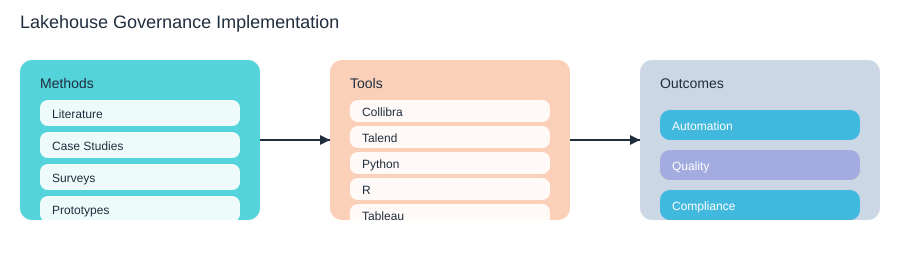
Badanie Stallion Journal nie traktowało zarządzania jak problemu do rozwiązania na slajdach. Wykorzystało cztery metody, które łatwo rozpoznać z codziennej pracy: przeanalizowano literaturę (przeglądy systematyczne), zbadano studia przypadków z branży, przeprowadzono ankiety wśród interesariuszy, a następnie przetestowano prototypy. Ta ostatnia część ma znaczenie, bo zarządzanie w lakehouse zawodzi w lukach między zasadami a potokami danych, zwłaszcza gdy dane napływają szybko, często się zmieniają i pochodzą z wielu zespołów.
Stos prototypowy: co faktycznie wypróbowano
W eksperymentach badanie wykorzystało Collibra i Talend do zarządzania i wzorców integracji, a także narzędzia analityczne (Python, R, Tableau) do weryfikacji użyteczności i wyników. Ten sposób działania możesz zastosować zarówno przy zarządzaniu w Databricks, konfiguracji lakehouse w Snowflake, jak i szerszym zarządzaniu danymi cloud-native, w którym pojawiają się Kubernetes, Docker, Kafka, Postgres, PySpark i Elasticsearch.
Ścieżka wdrożenia, którą możesz powtórzyć (i zachować zdrowy rozsądek)
Sukces wdrożenia zależy od zarządzania wspieranego narzędziami oraz od Twoich możliwości radzenia sobie z szybkością, złożonością i ograniczeniami zasobów. Praktyczna sekwencja wygląda następująco:
- Zacznij od katalogu i RBAC: przyjmij najlepsze praktyki katalogowania danych (jasna własność, terminy biznesowe i „złote” zbiory danych). Następnie zmapuj dostęp za pomocą RBAC.
- Dodaj pochodzenie danych (lineage): śledź wpływ w górę i w dół strumienia, aby zmiany nie zaskakiwały analityków ani audytorów.
- Zautomatyzuj egzekwowanie: tam, gdzie to możliwe, przejdź od ręcznych zatwierdzeń do policy-as-code, z zachowaniem ścieżek audytu.
Harris & Nguyen (2020): „RBAC jest prosty na papierze; staje się realny dnia, w którym mapujesz go na zespoły, a nie na stanowiska.”
Twój codzienny wróg: szybkość i niespójne strumienie danych
Strumienie danych o dużej prędkości (np. strumienie w stylu Kafka) powodują „dryf schematu”, opóźnione zdarzenia i zduplikowane rekordy. Właśnie wtedy zarządzanie danymi staje się chaotyczne: katalog mówi, że pole jest wymagane, ale strumień je pomija; reguły jakości oczekują jednego znacznika czasu, a producenci wysyłają trzy. Badanie wskazuje, że to powtarzający się problem, szczególnie gdy zespołom brakuje ludzi.
Rozrost narzędzi: kiedy systemy się ze sobą nie zgadzają
Uważaj na klasyczny problem „split-brain”: katalog pokazuje, że zbiór danych A jest „ograniczony”, ale grupy IAM nadal zezwalają na szeroki dostęp. Albo zasady zarządzania w Databricks nie odpowiadają temu, co skonfigurowano w chmurowym IAM. Traktuj „jedno źródło prawdy” jako cel projektowy, a nie hasło.
| Perspektywa decyzyjna | Zachowaj prostotę |
|---|---|
| Kupuj czy buduj | Kupuj katalog i przepływy pracy; buduj tylko cienkie łączniki i kontrole. |
| Unikaj labiryntu zarządzania | Jeden katalog, jeden model zasad, minimum niestandardowych ról i zautomatyzowane audyty. |
5) Najważniejsze problemy z zarządzaniem i sposób ich priorytetyzacji
Jeśli masz wrażenie, że zarządzanie danymi jest trudniejsze, niż „powinno być”, nie jesteś w tym sam. W syntezie badań 78% organizacji wskazuje wyzwanie związane z zarządzaniem metadanymi jako główny problem. Ta statystyka powinna pokazać, że nie jesteś odosobniony, bo w lakehouse wszystko porusza się szybko, a metadane są mapą, którą próbujesz aktualizować, gdy drogi wciąż są budowane.
Dlaczego metadane pękają jako pierwsze (i ciągle pękają)
Metadane są trudne, ponieważ:
- Definicje się rozjeżdżają: „aktywny klient” oznacza co innego dla działu finansowego, a co innego dla zespołu wzrostu.
- Odpowiedzialność jest niejasna: nikt nie jest pewien, kto zatwierdza nowe pole, nową tabelę lub nową regułę przechowywania.
- Potoki zmieniają się co tydzień: nowe źródła, nowe złączenia, nowe cechy ML – katalog i tagi nie nadążają.
A jednak inwestycja w zarządzanie przynosi mierzalne korzyści: 88% raportuje lepszą jakość zarządzania danymi, a 81% lepsze zarządzanie bezpieczeństwem lakehouse. To nagroda za wykonywanie mało efektownej pracy.
Priorytetyzacja zarządzania: najpierw właściwe rzeczy, we właściwej kolejności
- Najpierw metadane i odpowiedzialność: zdefiniuj krytyczne elementy danych, przypisz właściciela danych i opiekuna oraz ujednolić terminy biznesowe w katalogu.
- Następnie kontrola dostępu: wdróż RBAC zgodnie z zasadą najmniejszych uprawnień oraz jasne ścieżki zatwierdzania wyjątków.
- Pochodzenie danych i ślady audytu: śledź, skąd pochodzą dane, jak się zmieniały i kto miał do nich dostęp – to tutaj szybko znajdziesz odpowiedzi na pytania dotyczące RODO/GDPR, HIPAA i CCPA.
- Automatyzacja na końcu (ale stale): automatyzuj kontrolę zasad, tagowanie i wykrywanie anomalii, aby egzekwowanie nie zależało od bohaterskich wysiłków.
Co się psuje, gdy HIPAA spotyka CCPA?
Wyobraź sobie lakehouse, w którym zbiór danych medycznych objętych HIPAA (kontakty pacjentów) zostaje połączony ze zbiorem danych marketingowych objętym CCPA (zachowania w sieci). Pierwsze, co zwykle się psuje, to klasyfikacja i zgody: tagi PHI brakuje, flagi zgód nie propagują się przez złączenia, a dashboard dalej w łańcuchu ujawnia więcej, niż zamierzono. Bez pochodzenia danych nie udowodnisz, dokąd trafiły; bez RBAC nie powstrzymasz szerokiego dostępu; bez śladów audytu i zarządzania tożsamością nie wykażesz odpowiedzialności.
„Prawdziwym wyzwaniem nie jest sprawienie, by AI działała, lecz to, by działała odpowiedzialnie w systemach, które już masz.”
— dr Fei-Fei Li
Prosty rytuał, który utrzymuje zdrowy rozsądek: miesięczny przegląd zarządzania
Przeprowadzaj 45-minutowy miesięczny przegląd z udziałem działów IT, bezpieczeństwa i właścicieli biznesowych. Omów: 3 najważniejsze luki w metadanych, 3 najważniejsze wyjątki w dostępie, jedną awarię pochodzenia danych i jedno osiągnięcie w automatyzacji. Zapisuj działania we wspólnym trackerze i przypisuj jednego właściciela do każdej pozycji.
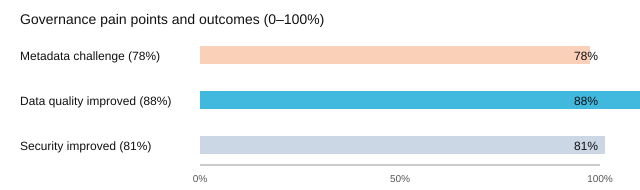
6) Zgodność bez paranoi: RODO/GDPR, HIPAA, CCPA w lakehouse
W lakehouse traktuj zgodność jako ograniczenie projektowe, a nie jako nerwowe nadrabianie zaległości na ostatnią chwilę. Gdy od pierwszego dnia wbudowujesz kontrole w pobieranie danych, przechowywanie i dostęp, zgodność z RODO/GDPR i HIPAA oraz zarządzanie danymi wg CCPA przestają być akcjami gaśniczymi, a stają się zwykłą codziennością. Badanie Stallion Journal „Data Governance in Lakehouse” pokazuje dlaczego: organizacje stosujące zarządzanie oparte na metadanych, automatyzację i ML odnotowały wzrost wskaźników zgodności z RODO/GDPR i HIPAA do 92% – traktuj to jako punkt odniesienia, a nie gwarancję.
„Bezpieczeństwo to proces, a nie produkt – a zarządzanie to sposób, by ten proces pozostał uczciwy.”
— Bruce Schneier
Mapowanie kontroli na przepisy: podstawowy zestaw narzędzi do zgodności
Nie „wdrażasz RODO” ani „wdrażasz HIPAA” samymi politykami. Wymagania mapujesz na powtarzalne mechanizmy kontroli wewnątrz lakehouse’u:
- RBAC (kontrola dostępu oparta na rolach): ogranicz, kto może zobaczyć dane PHI/PII i kto może je wyeksportować.
- Ścieżki audytu lakehouse’u: udowodnij, kto, kiedy, skąd i w jaki sposób uzyskał dostęp do danych oraz co z nimi zrobił.
- Pochodzenie danych (data lineage): pokaż, skąd pochodzą wrażliwe pola, jak się zmieniały i dokąd trafiły.
- Egzekwowanie zasad: konsekwentnie stosuj maskowanie, przechowywanie i ograniczenia celu przetwarzania we wszystkich narzędziach.
- Zarządzanie metadanymi i katalog: klasyfikuj dane, oznaczaj poziom poufności i napędzaj automatyzację.
| Regulacja | Na co zwracają uwagę audytorzy | Mechanizm kontroli w lakehouse’ie |
|---|---|---|
| RODO | Zgodny z prawem dostęp, minimalizacja, przechowywanie | RBAC, maskowanie, zasady przechowywania, lineage |
| HIPAA | Dzienniki dostępu, zabezpieczenia, zasada najmniejszych uprawnień | Ścieżki audytu, RBAC, szyfrowanie, monitorowanie |
| CCPA | Inwentaryzacja danych, obsługa dostępu i usuwania | Katalog + metadane, lineage, procesy zasad |
Kolejna fala: reguły specyficzne dla regionu i ograniczenia starszych systemów
Artykuł wskazuje przyszłe kierunki, które warto uwzględnić w planach już teraz: zgodność specyficzna dla regionu oraz lepszą adaptowalność do starszych lub ograniczonych środowisk. Jeśli działasz w kilku stanach lub krajach, buduj zasady, które mogą się różnić w zależności od regionu (okresy przechowywania, zasady zgody, zgłaszanie naruszeń). Jeśli nadal korzystasz ze starszych systemów, zacznij od mniejszego zakresu i integruj stopniowo. Automatyzacja pomaga, ale złożoność jest realna.
Przegląd „dnia audytu”: co trzeba będzie pokazać
- Inwentaryzacja danych: gdzie znajdują się dane PII/PHI, kto jest ich właścicielem i w jakim celu są przetwarzane (
catalog + tags). - Dowody dostępu: role RBAC, zatwierdzenia oraz eksporty ścieżek audytu lakehouse’u.
- Dowód pochodzenia danych: ścieżki od źródła do raportu dla kluczowych zbiorów danych i wrażliwych kolumn.
- Dowód zasad: maskowanie, przechowywanie, procesy usuwania oraz logi egzekwowania zasad.
- Osoby obecne na spotkaniu: właściciel danych, specjalista ds. bezpieczeństwa, administrator platformy, dział zgodności/prawny oraz jeden analityk, który korzysta z danych.
Widok radarowy: punkt wyjścia a zarządzany lakehouse
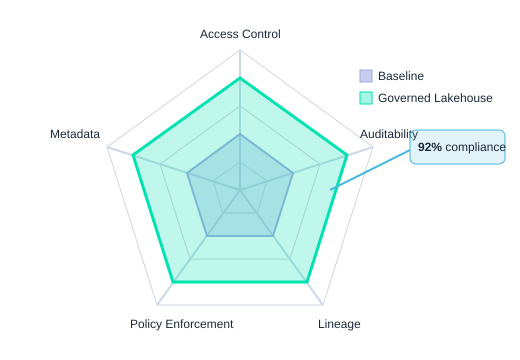
Krótka, szczera dygresja: jeśli działasz w mniejszej organizacji, zacznij od prostego punktu wyjścia: RBAC, logowanie i lekki katalog, zanim kupisz rozbudowane narzędzia korporacyjne. Badanie jasno pokazuje, że złożoność wdrożenia może być realną barierą, zwłaszcza gdy zasoby są ograniczone.
7) Stronniczość dostawców, polityka i to, o czym pomijają prezentacje o zarządzaniu
Na papierze możesz zaprojektować przejrzysty model zarządzania lakehouse’em, a potem patrzeć, jak się on zniekształca, gdy do gry wchodzi narzędzie do zarządzania danymi. Niewygodna prawda jest prosta: narzędzia i dostawcy kształtują to, jak wygląda „najlepsza praktyka”, ponieważ wpływają na to, co łatwo zademonstrować, łatwo kupić i łatwo zraportować.
Badanie lakehouse’u opublikowane w Stallion Journal wprost zwraca na to uwagę w sekcji dotyczącej konfliktu interesów. Wskazuje trzy źródła stronniczości, które należy zakładać w każdym programie zarządzania: stronniczość dostawcy (faworyzowanie platform, takich jak stosy Collibra Talend governance, czy innych komercyjnych pakietów), stronniczość raportowania w organizacji (udostępnianie wyłącznie wskaźników „sukcesu”) oraz presje finansowe i regulacyjne (wybieranie tego, co wygląda najbezpieczniej dla audytorów, a nie tego, co pasuje do architektury). Wniosek z badań jest jasny: przejrzystość i ujawnianie informacji są niezbędne, aby zachować rzetelność badań i sprawić, by wybory dotyczące zarządzania były przydatne poza narracją dostawców.
Satya Nadella: „Zaufanie to ostateczna waluta – a w danych zdobywa się je, będąc przejrzystym co do tego, co zrobiłeś i dlaczego.”
Ryzyka stronniczości, które warto nazwać wprost
Badania nad zarządzaniem i stronniczością narzędzi: ryzyka stronniczości. Stronniczość dostawcy 40%, stronniczość raportowania 35%, czynniki finansowe/regulacyjne 25%. Stronniczość dostawcy, stronniczość raportowania, czynniki finansowe/regulacyjne
Twoja lista kontrolna przeciwdziałania stronniczości (praktyczna, nie polityczna)
- Próbkowanie: porównaj co najmniej jeden komercyjny pakiet i jedno rozwiązanie open source w ekosystemach AWS, Snowflake, Databricks, SAP i Oracle Cloud Infrastructure.
- Ujawnianie informacji: dokumentuj sponsorów, powody wyboru narzędzi oraz to, czego nie testowano.
- Kryteria oceny: głębokość lineage, dopasowanie RBAC/ABAC, ścieżki audytu, dostęp przez API, formaty eksportu oraz integracja z tabelami lakehouse’u.
- Dowód wartości (proof-of-value): przeprowadź ograniczony w czasie pilotaż w jednej dziedzinie; mierz czas egzekwowania zasad, wskaźnik błędów i tarcia po stronie użytkowników.
- Kontrola ryzyka platformy danych dostawcy: zapytaj, jak uzależnienie od dostawcy (vendor lock-in) przejawia się w metadanych, katalogach i regułach procesów.
Mini historia: to ty mediujesz w prawdziwej decyzji
Dział zakupów naciska na jednego dostawcę ze względu na „standaryzację”. Inżynierowie chcą open source, żeby mieć kontrolę. Zgodność z przepisami wymaga funkcji „certyfikowanych” i czystych dowodów audytowych. Twoim zadaniem jest przetłumaczyć te potrzeby: możesz spełnić wymagania zgodności dzięki silnym mechanizmom kontroli i ścieżkom audytu, zaspokoić inżynierów dzięki interfejsom API i przenośności, a dział zakupów przekonać jasnym zwrotem z inwestycji — bez pozwalania, by jakakolwiek z tych grup definiowała zarządzanie danymi jako „cokolwiek, co sprzedaje narzędzie”.
Co, jeśli twoje narzędzie zostanie przejęte, a cena potroi się?
Zakładaj, że może to się zdarzyć. Przetestuj przenośność już teraz: czy możesz wyeksportować swój słownik biznesowy, pochodzenie danych (lineage) i reguły zasad w użytecznych formatach? Jeśli metadane nie mogą zostać przeniesione, zarządzanie danymi nie jest programem — jest subskrypcją.
8) Przyszłościowe podejście: IoT, brzegowe przetwarzanie (edge), zdecentralizowane dane i jezioro lakehouse, które odziedziczysz
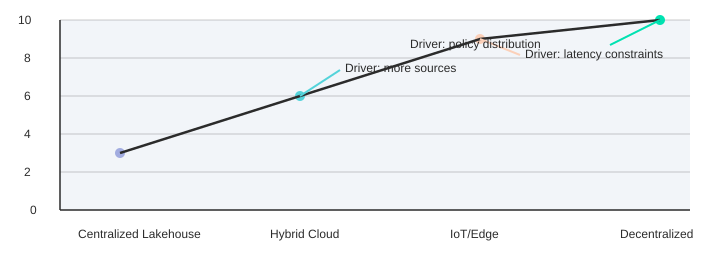
Zarządzanie lakehouse działa najlepiej, gdy dane są w większości scentralizowane, przystosowane do przetwarzania wsadowego i kontrolowane przez kilka platform. Zarządzanie danymi z IoT i przetwarzania brzegowego szybko łamie te założenia: masz do czynienia z większą liczbą źródeł (urządzenia, bramki, aplikacje), mniejszą centralną kontrolą (zespoły wdrażają rozwiązania niezależnie) oraz ostrzejszymi limitami opóźnień (nie możesz „czekać na nocne zadanie”, aby zdecydować o dostępie lub jakości). Badanie Stallion Journal wprost wskazuje tę presję i rekomenduje rozszerzenia zarządzania dla trzech nowych obszarów: jezior danych IoT, architektur zdecentralizowanych oraz przetwarzania brzegowego (edge computing).
Dlaczego IoT i edge obciążają obecny model
W strumieniach IoT to samo zdarzenie dotyczące „klienta” może napływać z wielu czujników, w różnych formatach i o różnych porach. Jeśli twoje zasady zależą od jednej centralnej aktualizacji katalogu, albo spowolnisz działanie, albo zaakceptujesz martwe punkty. Lokalizacje brzegowe tworzą też lokalne kopie danych w celu szybkości i odporności, co oznacza, że ścieżki audytu, pochodzenie danych i reguły przechowywania muszą podróżować razem z danymi — a nie pozostawać uwięzione w jednej płaszczyźnie sterowania w stylu hurtowni danych.
Zdecentralizowana architektura danych wymaga przenośnego zarządzania
W zdecentralizowanej architekturze danych domeny publikują produkty danych i rozwijają schematy według własnych harmonogramów. To dobre dla szybkości dostarczania, ale ryzykowne, jeśli definicje „danych osobowych (PII)”, „zgody” czy „zakresu HIPAA” nie są spójne. Przyszłościowe podejście oznacza projektowanie zarządzania jako usługi współdzielonej: rozszerzalnych metadanych, wersjonowanych zasad i mechanizmów tożsamości działających w różnych zespołach i regionach, zgodnie z postulatem pracy dotyczącym elastyczności zgodności z wymogami regionalnymi.
Opieraj się na blokach cloud-native, które możesz odziedziczyć
Zestaw referencyjny wokół tego badania wskazuje praktyczne elementy budulcowe: Docker do pakowania usług zasad, Kubernetes do uruchamiania ich wszędzie, Kafka do strumieniowania punktów egzekwowania zasad, Elasticsearch do szybkiego wyszukiwania i odkrywania danych oraz Postgres/PySpark do przetwarzania objętego zarządzaniem. Nie wybierasz narzędzi dla mody — wybierasz te, które mogą działać w chmurze, lokalnie i na brzegu sieci z tymi samymi mechanizmami kontroli.
„Wszystko zawodzi, cały czas — projektuj zarządzanie tak, jakbyś spodziewał się zmian, a nie stabilności.” — Werner Vogels
Plan małych zakładów, który pozwala iść naprzód
Nie musisz dziś w pełni rozwiązać zarządzania brzegowego. Potrzebujesz natomiast systemów metadanych i zasad, które da się rozszerzać bez przepisywania. Zacznij od pilotażu wykrywania anomalii opartego na AI w sygnałach zarządzania (dryf schematu, nietypowe ścieżki dostępu, eksporty odbiegające od wzorca), a następnie rozwijaj automatyczne kontrole zasad na etapie pozyskiwania danych i podczas zapytań. W miarę wzrostu skali dodaj mocniejsze zarządzanie tożsamością, rozważ mechanizmy wykrywania ingerencji w stylu blockchain dla krytycznych ścieżek audytu i zaplanuj odtwarzanie po awarii odpowiadające poziomowi ryzyka.
| Środowisko | Wskaźnik złożoności zarządzania (poglądowy) |
|---|---|
| Scentralizowany lakehouse | 3 |
| Chmura hybrydowa | 6 |
| IoT/Edge | 9 |
| Zdecentralizowane | 10 |
Spisuj zasady zarządzania danymi tak, jakby miały zostać zastąpione: jasne definicje, przenośne zasady i dzienniki decyzji, które przetrwają reorganizacje. Lakehouse, który odziedziczysz później, będzie bardziej chaotyczny niż dziś, a przyszły ty lepiej będzie spać, jeśli zaprojektujesz pod to już teraz.
Architektura lakehouse w Microsoft Fabric: poznaj Microsoft Fabric pod kątem analityki i inżynierii danych
Czym jest architektura lakehouse w Microsoft Fabric?
Architektura lakehouse w Microsoft Fabric to ujednolicona platforma danych, która łączy cechy jezior danych i hurtowni danych, pozwalając przechowywać surowe dane oraz ustrukturyzowane, przetworzone zbiory danych w jednym miejscu. Wykorzystuje usługę Azure Data Lake Storage do przechowywania wolumenów danych, silniki obliczeniowe Fabric do przetwarzania oraz wzorce architektury medalionu do zarządzania warstwami surowymi, wzbogaconymi i wyselekcjonowanymi. Dzięki temu zespoły mogą analizować dane, uruchamiać obciążenia data science i zasilać raporty w usłudze Power BI bez duplikowania danych.
Jak działa architektura medalionu w lakehouse w Fabric?
Architektura medalionu w Fabric porządkuje dane w warstwy – zazwyczaj brązową (surowe dane), srebrną (oczyszczone i wzbogacone) i złotą (wyselekcjonowane, gotowe do analityki i BI). Fabric integruje narzędzia do pozyskiwania i przekształcania danych, które przenoszą je i przetwarzają między warstwami. Umożliwia to procesy inżynierii danych i przygotowania danych, utrzymując jedną kopię danych i ograniczając ich duplikowanie, a jednocześnie wspierając analitykę i data science.
Jak wdrożyć lakehouse w Microsoft Fabric i jak utworzyć lakehouse?
Aby wdrożyć lakehouse w Microsoft Fabric, zacznij od połączenia źródeł danych i pozyskania danych do usługi Azure Data Lake za pomocą możliwości pozyskiwania danych w Fabric. Następnie użyj silników obliczeniowych Fabric lub transformacji typu dataflow, aby zastosować przetwarzanie zgodne z architekturą medalionu, katalogować zbiory danych w OneLake i zabezpieczyć dostęp. Zintegruj usługę Power BI oraz inne narzędzia analityczne na potrzeby raportowania. Platforma upraszcza zarządzanie danymi, wspiera integrację danych istniejących i dużych zbiorów danych oraz pozwala przekształcać dane bez zbędnego przenoszenia.
Czym różni się lakehouse od tradycyjnej hurtowni danych w Microsoft Fabric?
Lakehouse łączy elastyczność jezior danych w zakresie surowych i półstrukturalnych danych z wydajnością i zarządzaniem schematem typowymi dla hurtowni danych. W Microsoft Fabric lakehouse pozwala przechowywać dane w usłudze Azure Data Lake Storage, zapewniając jednocześnie wydajność zapytań zbliżoną do hurtowni dzięki silnikom obliczeniowym Fabric. Dzięki temu uzyskujesz możliwości hurtowni danych – na przykład wyselekcjonowane, ustrukturyzowane dane do analityki – przy zachowaniu elastyczności jeziora danych w nowoczesnych zadaniach związanych z danymi i inżynierią danych.
Jak Fabric obsługuje pozyskiwanie danych i jak unikać ich duplikowania?
Fabric obsługuje wiele wzorców pozyskiwania danych – strumieniowy, wsadowy oraz łączniki do przedsiębiorstwowych źródeł danych – do centralnego jeziora (Azure Data Lake). Dzięki architekturze medalionu i OneLake Fabric promuje jedną kopię danych oraz logiczne zbiory danych zamiast fizycznych duplikatów. Narzędzia integracji i transformacji danych umożliwiają pozyskiwanie danych, ich przekształcanie w miejscu przechowywania oraz spójny dostęp do danych dla obciążeń analitycznych i data science, co minimalizuje duplikowanie danych w różnych systemach.
Czy mogę korzystać z istniejących hurtowni danych i danych w usłudze Azure razem z lakehouse w Fabric?
Tak. Fabric integruje się z systemami Microsoft i zewnętrznymi, co pozwala federować zapytania do istniejących hurtowni danych, usługi Azure Synapse i usługi Azure Data Lake Storage przy jednoczesnej konsolidacji dostępu do zasobów danych. Możesz pozyskiwać lub wskazywać istniejące dane, wdrażać wzorce data mesh oraz decydować, czy przenieść dane do lakehouse, czy uzyskiwać do nich bezpośredni dostęp, w zależności od wymagań dotyczących zarządzania, kosztów i wydajności.
Jakie są typowe przypadki użycia lakehouse w Fabric w analityce i data science?
Typowe przypadki użycia obejmują ujednolicone zarządzanie danymi na potrzeby BI w usłudze Power BI, przygotowywanie dużych surowych zbiorów danych do uczenia maszynowego i data science, budowanie potoków ELT w oparciu o architekturę medalionu, analizowanie danych z systemów przedsiębiorstwa oraz tworzenie jednej lokalizacji dla danych ustrukturyzowanych i nieustrukturyzowanych. Fabric upraszcza przetwarzanie danych, umożliwia skalowalną analizę i wspiera nowoczesne architektury danych, takie jak data mesh i przedsiębiorstwowe katalogi danych.
Jak działa bezpieczeństwo, zarządzanie i dostęp do danych w lakehouse w Fabric?
Fabric zapewnia kontrolę dostępu opartą na rolach, zasady dotyczące danych oraz integrację z usługą Microsoft Purview i Azure Active Directory w zakresie zarządzania i pochodzenia danych (data lineage). Konstrukcje OneLake i lakehouse umożliwiają szczegółowe uprawnienia do danych przechowywanych w usłudze Azure Data Lake Storage, zapewniając bezpieczny dostęp do danych, zgodność z wymogami oraz kontrolowane procesy przygotowania danych, a jednocześnie zachowując możliwość audytu na etapach pozyskiwania i przekształcania danych.
Których silników obliczeniowych Fabric należy używać dla różnych obciążeń w lakehouse?
Fabric oferuje wiele silników obliczeniowych zoptymalizowanych pod kątem określonych obciążeń: interaktywne zapytania SQL do analityki i BI, Spark do przetwarzania dużych zbiorów danych i inżynierii danych oraz wyspecjalizowane silniki do pobierania danych w czasie rzeczywistym. Wybierając silniki obliczeniowe Fabric, kieruj się charakterystyką obciążenia: użyj Spark do transformacji na dużą skalę, SQL w magazynie do zapytań BI, a silniki strumieniowe do ciągłego pobierania danych, aby zrównoważyć koszty, wydajność i potrzeby przetwarzania danych.
Gdzie mogę dowiedzieć się więcej i zacząć pracę z architekturą lakehouse w Microsoft Fabric?
Aby zacząć, przejdź samouczki w Microsoft Learn, zapoznaj się z dokumentacją dotyczącą architektury lakehouse w Microsoft Fabric i przeanalizuj przykłady architektury medalionowej w Fabric. Zacznij od połączenia źródła danych, pobrania surowych danych do Azure Data Lake Storage, wdrożenia prostego potoku medalionowego oraz wizualizacji wyników w Power BI, aby zrozumieć, jak Fabric upraszcza tworzenie lakehouse i dostarczanie analiz z jednolitego zasobu danych.