 FR
 English
 Deutsch
 Español
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 日本語
 한국어
Gouverner les données dans un lakehouse Microsoft Fabric : une architecture sans nuits blanches
Par Mirko Peters · · Mis à jour
Gouvernez les données d’une architecture lakehouse dans Microsoft Fabric sans perdre le sommeil. Simplifiez l’analyse avec une solution robuste et facile à gérer.
Traduit automatiquement par IA à partir de l'article original. Lire l'original en anglais
Vous connaissez ce moment gênant où, en réunion, quelqu’un demande : « Pouvez-vous prouver d’où vient ce chiffre ? », et où la salle se tait ? J’ai vu ce silence s’installer dans des entreprises qui disposaient de « toutes les données », mais d’aucune preuve. Les lakehouses promettent une plateforme unique pour tout : tables structurées, fichiers hétérogènes, flux en temps réel, caractéristiques de machine learning. Mais cette promesse ne tient que si vous pouvez les gouverner sans entraver vos équipes. Cet article s’appuie largement sur l’étude « Data Governance in Lakehouse » (Shah & Jain) publiée en octobre 2024 dans le Stallion Journal, puis ajoute la dimension humaine : les raccourcis auxquels vous serez tenté de céder, les jeux politiques que vous rencontrerez et les habitudes simples qui vous évitent la panique provoquée par les audits.
8 faits surprenants sur la gouvernance dans un lakehouse Microsoft Fabric- Gouvernance unifiée des artefacts : la gouvernance de Fabric s’applique uniformément aux tables, aux fichiers, aux notebooks, aux pipelines et aux tableaux de bord du lakehouse, ce qui permet de définir des stratégies centralisées couvrant à la fois les artefacts de données et d’analyse.
- Capture automatique du lignage : le lignage est capturé automatiquement pour de nombreuses opérations (ingestion, transformations, notebooks et tableaux de bord), offrant une visibilité quasi temps réel sur la provenance des données sans instrumentation supplémentaire.
- Intégration de la sécurité au niveau des lignes et des colonnes : le lakehouse prend en charge des contrôles d’accès précis (au niveau des lignes et des colonnes) appliqués au moment de la requête. L’accès gouverné suit ainsi les données, quel que soit le moteur de consommation.
- Classification intégrée des données et étiquettes de confidentialité : Fabric affiche la classification des données (types d’informations sensibles) et s’intègre aux étiquettes de confidentialité de Microsoft Purview, afin que la gouvernance puisse exploiter les classifications détectées pour appliquer ses stratégies.
- Policy-as-code pour les contrôles du cycle de vie : les stratégies de gouvernance (rétention, points de contrôle de qualité, chiffrement, calcul autorisé) peuvent être définies et appliquées par programmation, ce qui permet une mise en œuvre automatisée sur l’ensemble du cycle de vie du lakehouse.
- Isolation transparente des locataires et des espaces de travail : le modèle de gouvernance de Fabric prend en charge l’isolation entre plusieurs espaces de travail ainsi que des stratégies tenant compte du locataire. Vous pouvez ainsi restreindre le partage et les transferts de données entre projets tout en permettant une collaboration gouvernée.
- Journaux d’audit des modifications et des accès : toutes les opérations pertinentes pour la gouvernance (lectures et écritures de données, modifications de stratégies, attributions de rôles) sont auditables. Ces journaux s’intègrent à Microsoft Sentinel et aux SIEM pour la surveillance de la conformité.
- Contrats de données compatibles avec la gouvernance : Fabric permet de créer des contrats de données et des schémas assortis de contrôles de compatibilité appliqués. Les consommateurs disposent ainsi d’interfaces stables et gouvernées vers les données du lakehouse, et les producteurs peuvent faire évoluer leurs données en toute sécurité.
1) Le problème de la « réunion silencieuse » : pourquoi les lakehouses ont besoin de gouvernance
Vous participez à une revue de direction. Un indicateur clé s’affiche à l’écran : taux de rétention du chiffre d’affaires, délai d’attente des patients, risque de désabonnement. Quelqu’un demande : « D’où vient ce chiffre ? » La salle se tait. Vous ne parvenez pas à retracer le jeu de données, la transformation, ni la personne qui a modifié la logique la semaine dernière. À cet instant, vous n’avez pas un problème d’analyse, mais un problème de confiance dans les données.
Le lakehouse en termes simples : un toit, deux promesses
Un lakehouse est un compromis pragmatique : la souplesse du data lake (tout stocker, rapidement) associée à la fiabilité de l’entrepôt de données (tables cohérentes, performances solides). Sous un même toit, vous pouvez gérer des données structurées et non structurées, exécuter des analyses en temps réel et prendre en charge des charges de travail de machine learning. Cette valeur « tout-en-un » est aussi la raison pour laquelle votre stratégie d’architecture lakehouse doit intégrer la gouvernance dès le premier jour.
Pourquoi les lakehouses accentuent les besoins de gouvernance des données
Les lakehouses évoluent vite : flux continus, réentraînement fréquent des modèles et nombreuses équipes publiant des tableaux de bord en parallèle. Cette rapidité multiplie les risques. La diversité des types de données et la multiplicité des outils compliquent le suivi des définitions, des autorisations et du lignage. Lorsqu’on ne peut plus expliquer un indicateur, les parties prenantes cessent de faire confiance au tableau de bord, même si le chiffre est exact.
- Les données en temps réel augmentent le risque d’instantanés incohérents et d’indicateurs « cibles mouvantes ».
- Les pipelines de ML ajoutent de nouveaux actifs à gouverner : caractéristiques (features), jeux d’entraînement, sorties de modèles et signaux de dérive.
- Davantage d’utilisateurs (analystes, data scientists, équipes produit) signifie davantage de chemins d’accès et davantage de risques de contourner la stratégie.
La gouvernance n’est pas de la paperasse : c’est ce qui vous permet de livrer en toute sécurité
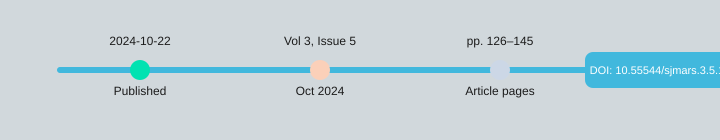
L’étude « Data Governance in Lakehouse » (Samarth Shah, University at Albany ; Shubham Jain, IIT Bombay), publiée dans la revue à comité de lecture Stallion Journal le 22-10-2024 dans le Volume 3, Issue 5 (pp. 126–145, ISSN 2583-3340 ; DOI : https://doi.org/10.55544/sjmars.3.5.12), présente la gouvernance à la fois comme une nécessité stratégique et comme un impératif opérationnel. Le message est simple : la gouvernance vous protège sur le plan de la conformité (RGPD, HIPAA, CCPA), réduit les risques et préserve la qualité des données ainsi que la confiance des parties prenantes.
Samarth Shah : « Dans un lakehouse, la vitesse sans gouvernance n’est pas de l’agilité, c’est simplement une confusion plus rapide. »
Concrètement, la gouvernance des données lakehouse vous permet de répondre à la question « Que représente ce KPI ? » en vous appuyant sur des preuves : métadonnées, entrées du catalogue, contrôles d’accès (comme le RBAC), journaux d’audit et traçabilité. Il ne s’agit pas de bureaucratie. C’est le système qui vous permet de livrer vos analyses rapidement, sans enfreindre la loi ni perdre la confiance.
| Élément de métadonnées | Valeur |
|---|---|
| Date de publication | 22-10-2024 |
| Numéro de la revue | Volume 3, Issue 5 (oct. 2024) |
| Pages | 126–145 |
| ISSN | 2583-3340 |
2) À quoi ressemble une bonne gouvernance quand vos données sont partout
Dans un lakehouse, vos données ne sont pas « à un seul endroit ». Elles sont réparties entre tables, fichiers, flux et features de machine learning, souvent sur des plateformes comme AWS, Snowflake ou Databricks. Une bonne gouvernance permet de les garder exploitables et sûres sans ralentir les équipes. Considérez-la comme des garde-fous, et non des barrières : vous activez l’analytique en temps réel tout en respectant les exigences du RGPD, de HIPAA et de CCPA.
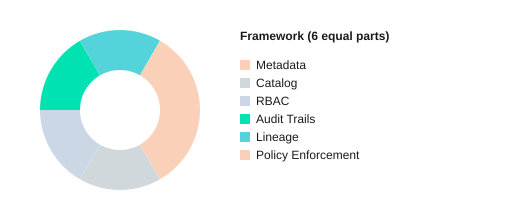
Les 6 briques que vous mettrez réellement en œuvre
- Gouvernance pilotée par les métadonnées : définissez les propriétaires, le niveau de sensibilité, la rétention et les règles de qualité dans les métadonnées, afin que les contrôles passent à l’échelle avec le volume et l’évolution des données.
- Bonnes pratiques de catalogue de données : un point d’entrée unique et consultable pour les définitions, les balises et les jeux de données de confiance, pour que les utilisateurs cessent de deviner.
- Contrôle d’accès RBAC : les rôles correspondent aux besoins métier (analyste, ingénieur, clinicien), et non à des autorisations ponctuelles.
- Suivi de la traçabilité des données : montrez d’où viennent les données, comment elles ont évolué et ce qu’elles alimentent.
- Journaux d’audit : qui a accédé à quoi, quand, et ce qu’il en a fait. Un élément essentiel pour les investigations et les audits.
- Application des stratégies : des contrôles automatisés (masquage, rétention, approbations) qui s’exécutent par défaut, et non sur demande.
Gouvernance documentée ou appliquée (seule la seconde prévient les incidents)
Une gouvernance documentée, c’est une page de wiki qui indique « les données personnelles doivent être masquées ». Une gouvernance appliquée, c’est quand votre lakehouse masque automatiquement les données personnelles à partir des balises des métadonnées, bloque les exports à risque et consigne les accès dans les journaux d’audit. Les travaux de recherche sur la gouvernance des lakehouses modernes montrent que l’automatisation et les métadonnées réduisent le temps d’application manuelle ainsi que les erreurs, car la plateforme applique les règles de façon homogène.
Une gouvernance unifiée lorsque vous jonglez entre tables, fichiers, flux et features
Il vous faut un plan de contrôle unique couvrant les tables batch, les fichiers du stockage objet, les flux de type Kafka et les jeux de features de machine learning. Lorsque la gouvernance est unifiée, les mêmes contrôles d’accès RBAC, balises et stratégies suivent les données : vos tableaux de bord, vos notebooks et vos modèles restent ainsi alignés et conformes.
Petite digression : comment « un jeu de données partagé » devient 12 versions
Sans suivi de la traçabilité des données, un jeu de données « client » est copié dans customer_v2, customer_clean, customer_final et « final_final ». Très vite, les équipes se disputent sur les chiffres, car personne ne peut prouver quelle version a alimenté quel rapport.
Shubham Jain : « La traçabilité fait la différence entre « je pense que » et « je peux le prouver » lorsqu’on remet vos chiffres en question. »
Autoévaluation en 5 minutes
- Pouvez-vous retrouver le propriétaire et la balise de sensibilité de vos 10 jeux de données les plus importants dans le catalogue ?
- Les rôles (et non les personnes) contrôlent-ils l’accès via RBAC ?
- Pouvez-vous remonter un KPI jusqu’à ses sources grâce à la traçabilité en moins de 2 minutes ?
- Les journaux d’audit permettent-ils aujourd’hui de savoir qui a consulté ou exporté ce contenu ?
- Les stratégies sont-elles appliquées automatiquement (masquage, rétention, approbations) et non manuellement ?
Chaque contrôle se traduit par des résultats : moins d’incidents d’accès (RBAC et stratégies), des audits plus rapides (journaux d’audit et catalogue) et des analyses plus fiables (métadonnées et traçabilité).
3) Les chiffres qui font de la gouvernance autre chose qu’un « coût de structure »
Si la gouvernance vous semble être un « processus supplémentaire », les résultats de l'étude peuvent vous aider à la présenter comme un gain opérationnel mesurable. Lorsque vous appliquez une gouvernance pilotée par les métadonnées avec de l'automatisation et du ML dans un lakehouse, vous ne vous contentez pas d'« ajouter des contrôles » : vous gagnez du temps, renforcez la confiance dans les données et réduisez le risque de conformité, d'une manière que un DAF peut suivre.
Gouvernance pilotée par les métadonnées : un retour sur investissement que vous pouvez présenter en une diapositive
L'étude relève trois résultats majeurs lorsque les équipes s'appuient sur des métadonnées solides, un catalogage, la traçabilité (lineage) et des contrôles d'accès :
- Jusqu'à 40 % d'amélioration de l'efficacité de la gouvernance
- Hausse de 35 % de la qualité des données
- Taux d'atteinte de 92 % en matière de conformité RGPD et HIPAA (RGPD/HIPAA)
Concrètement, ce gain d'efficacité de 40 % se traduit souvent par moins de revues manuelles, moins de échanges du type « qui est propriétaire de ce jeu de données ? » et des approbations plus rapides pour l'accès et le partage. Votre backlog se réduit, car les vérifications de routine passent des personnes aux systèmes, et votre file d'incidents diminue parce que moins de problèmes atteignent la production.
Application automatisée des stratégies : le comparatif avant/après qui change la discussion
La preuve la plus claire du rapport « contrainte contre bénéfice » est le passage des contrôles manuels à l'application automatisée des stratégies :
- Temps d'application des stratégies : 72 % → 28 %
- Taux d'erreur : 45 % → 15 %
Il ne s'agit pas d'une petite optimisation. C'est la différence entre une gouvernance qui fait office de barrière et une gouvernance qui joue le rôle de garde-fou. Vous passez moins de temps à traquer les exceptions et davantage à permettre un libre-service sûr.
« La gouvernance unifiée ne tient que lorsque le flux de travail est plus simple que le contournement. » —Taylor, Singh, & Green (2021)
Adoption : un bilan solide pour les utilisateurs techniques, plus difficile pour les autres
Les scores d'utilisabilité étaient élevés chez les data scientists, les analystes métier et les administrateurs informatiques (4,2 à 4,7 sur 5). Mais l'étude signale aussi un écart fréquent : les utilisateurs non techniques ont besoin d'interfaces plus simples, de définitions plus claires et de parcours guidés. Si vous voulez atteindre les résultats ci-dessus, prévoyez un budget pour l'accompagnement, et pas seulement pour les outils.
Principaux indicateurs en un coup d'œil
| Indicateur | Résultat |
|---|---|
| Amélioration de l'efficacité de la gouvernance | Jusqu'à 40 % |
| Hausse de la qualité des données | 35% |
| Taux de conformité RGPD HIPAA | 92% |
| Temps d'application des stratégies | 72 % (manuel) contre 28 % (automatisé) |
| Taux d'erreur | 45 % (manuel) contre 15 % (automatisé) |
| Note d'utilisabilité | 4,2 à 4,7 sur 5 |
| Réduction du temps de traitement | 25% |
4) Outils, prototypes et la réalité souvent désordonnée de la mise en œuvre
Ce que la recherche a fait (en termes simples)
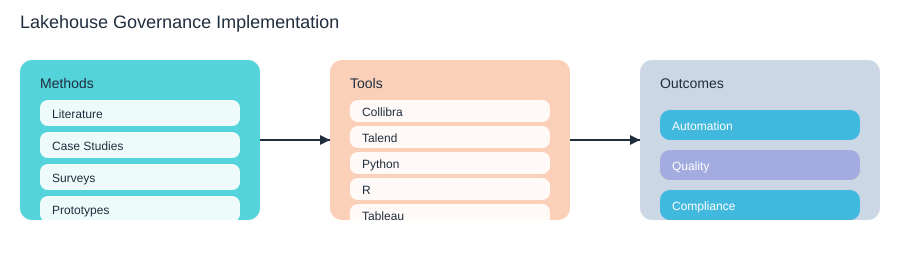
L'étude Stallion Journal n'a pas traité la gouvernance comme un simple problème de présentation. Elle a utilisé quatre méthodes que vous reconnaîtrez dans votre travail quotidien : elle a analysé la littérature (revues systématiques), examiné des études de cas sectorielles, interrogé des parties prenantes, puis testé des prototypes. Cette dernière étape compte, car la gouvernance d'un lakehouse se fragilise dans les écarts entre la stratégie et les pipelines, surtout lorsque vos données arrivent vite, changent souvent et proviennent de nombreuses équipes.
Pile de prototypes : ce qu'ils ont réellement testé
Lors de l'expérimentation, l'étude a utilisé Collibra et Talend pour les modèles de gouvernance et d'intégration, ainsi que des outils d'analyse (Python, R, Tableau) pour valider l'utilisabilité et les résultats. Vous pouvez reproduire cette approche que vous travailliez sur une gouvernance Databricks, sur une configuration de lakehouse Snowflake ou sur une gouvernance des données cloud-native plus large, avec Kubernetes, Docker, Kafka, Postgres, PySpark et Elasticsearch dans l'environnement.
Une feuille de route que vous pouvez reprendre (et qui reste soutenable)
La réussite de la mise en œuvre dépend d'une gouvernance outillée et de votre capacité à gérer la vélocité, la complexité et les contraintes de ressources. Une séquence pragmatique est la suivante :
- Commencer par le catalogue et le RBAC : appliquez les bonnes pratiques de catalogage des données (propriété claire, termes métier et jeux de données « de référence »). Attribuez ensuite les accès via le RBAC.
- Ajouter la traçabilité (lineage) : identifiez l'impact amont et aval afin que les changements ne surprennent ni les analystes ni les auditeurs.
- Automatiser l'application des stratégies : passez des approbations manuelles au policy-as-code lorsque c'est possible, avec des journaux d'audit.
Harris & Nguyen (2020) : « Le RBAC est simple sur le papier ; il devient concret le jour où vous le faites correspondre aux équipes, et non aux intitulés de poste. »
Votre ennemi quotidien : la vélocité et les flux de données incohérents
Les flux à haut débit (pensez aux flux de type Kafka) entraînent une « dérive de schéma », des événements en retard et des enregistrements en double. C’est là que la gouvernance devient confuse : votre catalogue indique qu’un champ est obligatoire, mais le flux le supprime ; vos règles de qualité attendent un seul horodatage, mais les producteurs en envoient trois. Selon l’étude, il s’agit d’un obstacle récurrent, en particulier lorsque les équipes sont en sous-effectif.
Prolifération d’outils : quand les systèmes se contredisent
Méfiez-vous du classique problème du « split-brain » : votre catalogue indique que le jeu de données A est « restreint », mais les groupes IAM autorisent toujours un large accès. Ou alors, vos stratégies Databricks governance ne correspondent pas à la configuration de l’IAM cloud. Considérez « une source de vérité unique » comme un objectif de conception, et non comme un slogan.
| Grille de décision | Restez simple |
|---|---|
| Acheter ou développer | Achetez pour le catalogue et les workflows ; ne développez que des connecteurs et des contrôles légers. |
| Évitez le labyrinthe de la gouvernance | Un seul catalogue, un seul modèle de stratégie, un minimum de rôles personnalisés, des audits automatisés. |
5) Les principaux points de friction de la gouvernance (et comment les trier)
Si vous avez l’impression que la gouvernance est plus difficile qu’elle ne « devrait » l’être, vous n’êtes pas seul. Dans la synthèse des recherches, 78 % des organisations citent le défi de la gestion des métadonnées comme principal point de friction. Ce chiffre devrait vous rassurer, car dans un lakehouse, tout va vite, et les métadonnées sont la carte que vous essayez de mettre à jour alors que les routes sont encore en construction.
Pourquoi les métadonnées cèdent en premier (et continuent de céder)
La gestion des métadonnées est difficile pour les raisons suivantes :
- Les définitions dérivent : « client actif » n’a pas la même signification pour la finance que pour l’équipe croissance.
- La propriété est floue : personne n’est vraiment certain de qui approuve un nouveau champ, une nouvelle table ou une nouvelle règle de rétention.
- Les pipelines évoluent chaque semaine : nouvelles sources, nouvelles jointures, nouvelles fonctionnalités de ML : votre catalogue et vos balises accusent un retard.
Pourtant, lorsque vous investissez dans la gouvernance, les bénéfices sont mesurables : 88 % déclarent une amélioration de la gouvernance de la qualité des données, et 81 % constatent une meilleure gouvernance de la sécurité du lakehouse. C’est le retour sur investissement de ce travail peu spectaculaire.
Triage de la gouvernance : traiter les bons sujets dans le bon ordre
- Métadonnées et propriété en premier : définissez les éléments de données critiques, désignez un propriétaire et un intendant des données, et normalisez les termes métier dans votre catalogue.
- Contrôle d’accès ensuite : mettez en œuvre le RBAC selon le principe du moindre privilège, avec des circuits d’approbation clairs pour les exceptions.
- Traçabilité et journaux d’audit : suivez l’origine des données, leurs modifications et les personnes qui y ont accédé. C’est ce qui permet de répondre rapidement aux questions relatives au RGPD, à HIPAA et au CCPA.
- Automatisation en dernier, mais de manière continue : automatisez les contrôles de stratégie, le balisage et la détection d’anomalies afin que l’application des règles ne repose pas sur l’héroïsme.
Que se passe-t-il lorsque HIPAA rencontre le CCPA ?
Imaginez un lakehouse où un jeu de données de santé soumis à HIPAA (rencontres avec les patients) est joint à un jeu de données marketing relevant du CCPA (comportement sur le web). Ce qui cède en premier, c’est généralement la classification et le consentement : les balises PHI sont absentes, les indicateurs de consentement ne se propagent pas lors des jointures, et un tableau de bord en aval expose plus de données que prévu. Sans traçabilité, vous ne pouvez pas prouver où les données sont allées ; sans RBAC, vous ne pouvez pas limiter les accès trop larges ; sans journaux d’audit ni gestion des identités, vous ne pouvez pas démontrer la responsabilité.
« Le véritable défi n’est pas de faire fonctionner l’IA, mais de la faire fonctionner de manière responsable au sein des systèmes que vous utilisez déjà. »
— Dr Fei-Fei Li
Un rituel simple pour garder le cap : la rétrospective mensuelle sur la gouvernance
Organisez une rétrospective mensuelle de 45 minutes avec les responsables informatiques, de la sécurité et métier. Passez en revue : les 3 principales lacunes de métadonnées, les 3 principales exceptions d’accès, une défaillance de traçabilité et une réussite d’automatisation. Consignez les actions dans un tableau de suivi partagé et attribuez un responsable unique à chaque élément.
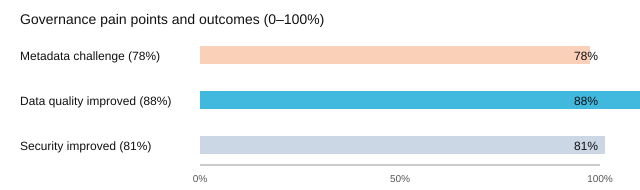
6) La conformité sans paranoïa : RGPD, HIPAA, CCPA dans le lakehouse
Dans un lakehouse, considérez la conformité comme une contrainte de conception, et non comme une course de dernière minute. Lorsque vous intégrez les contrôles dès le premier jour dans l’ingestion, le stockage et l’accès, la conformité RGPD HIPAA et la gouvernance des données CCPA cessent d’être des interventions d’urgence pour devenir des activités courantes. L’étude de Stallion Journal intitulée « Data Governance in Lakehouse » le montre : les organisations qui utilisent une gouvernance pilotée par les métadonnées, l’automatisation et le ML ont vu leur taux de conformité au RGPD et à HIPAA atteindre 92 %. Utilisez ce chiffre comme référence cible, et non comme garantie.
« La sécurité est un processus, pas un produit, et la gouvernance est ce qui permet de garder ce processus honnête. »
— Bruce Schneier
Faire correspondre les contrôles aux réglementations : votre boîte à outils de conformité essentielle
Vous ne « faites » pas le RGPD ni la HIPAA en rédigeant seulement des politiques. Vous faites correspondre les exigences à des contrôles reproductibles dans le lakehouse :
- RBAC (contrôle d’accès basé sur les rôles) : limiter qui peut voir les PHI/PII et qui peut les exporter.
- Journaux d’audit du lakehouse : prouver qui a accédé à quoi, quand, depuis où, et ce qui a été fait.
- Traçabilité des données (lineage) : montrer d’où proviennent les champs sensibles, comment ils ont évolué et où ils ont abouti.
- Application des stratégies : appliquer de manière cohérente le masquage, la rétention et les limitations de finalité à travers tous les outils.
- Gestion des métadonnées et catalogue : classifier les données, étiqueter la sensibilité et piloter l’automatisation.
| Réglementation | Ce que recherchent les auditeurs | Contrôle dans le lakehouse |
|---|---|---|
| RGPD | Accès licite, minimisation, rétention | RBAC, masquage, stratégies de rétention, traçabilité |
| HIPAA | Journaux d’accès, garanties, moindre privilège | Journaux d’audit, RBAC, chiffrement, supervision |
| CCPA | Inventaire des données, gestion des accès et des suppressions | Catalogue et métadonnées, traçabilité, workflows de stratégies |
La prochaine vague : règles spécifiques à chaque région et contraintes héritées
L’étude signale des travaux futurs à anticiper dès maintenant : la conformité spécifique à chaque région et une meilleure capacité d’adaptation pour les environnements hérités ou contraints. Si vous opérez dans plusieurs États ou pays, concevez des stratégies pouvant varier selon la région (durées de rétention, règles de consentement, notification des violations). Si vous exploitez encore d’anciens systèmes, commencez par un périmètre restreint et intégrez progressivement : l’automatisation aide, mais la complexité est réelle.
« Jour d’audit » : ce que vous devrez présenter
- Inventaire des données : où se trouvent les PII/PHI, leurs propriétaires et leur finalité (
catalog + tags). - Preuves d’accès : rôles RBAC, approbations et exports des journaux d’audit du lakehouse.
- Preuves de traçabilité : chemins de la source au rapport pour les jeux de données clés et les colonnes sensibles.
- Preuves des stratégies : masquage, rétention, workflows de suppression et journaux d’application.
- Les personnes présentes : propriétaire des données, sécurité, administrateur de la plateforme, conformité/juridique, et un analyste qui utilise les données.
Vue radar : référence de base comparée au lakehouse gouverné
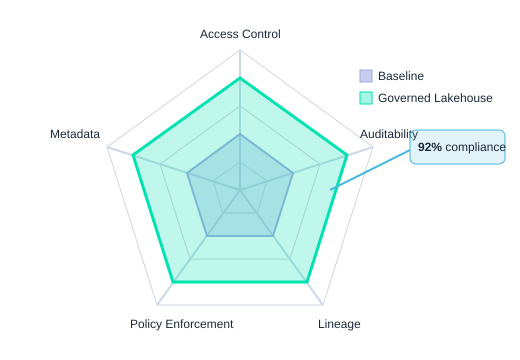
Petite remarque honnête : si votre organisation est de taille modeste, commencez par une référence simple (RBAC, journalisation et catalogue léger) avant d’acheter des outils d’entreprise. L’étude est claire : la complexité de mise en œuvre peut constituer un véritable obstacle, surtout lorsque les ressources sont limitées.
7) Biais des fournisseurs, politique et ce que les présentations sur la gouvernance omettent
Vous pouvez concevoir un modèle de gouvernance du lakehouse impeccable sur le papier, puis le voir plier dès que des outils de gouvernance des données entrent en jeu. La réalité dérangeante est simple : les outils et les fournisseurs façonnent ce que sont les « bonnes pratiques », parce qu’ils déterminent ce qui est facile à démontrer, facile à acheter et facile à présenter dans un rapport.
L’étude sur le lakehouse de Stallion Journal aborde directement ce point dans sa section sur les conflits d’intérêts. Elle identifie trois sources de biais que vous devez considérer comme présentes dans tout programme de gouvernance : le biais fournisseur (favoriser des plateformes comme les suites Collibra Talend governance ou d’autres suites commerciales), le biais de reporting organisationnel (ne partager que les indicateurs de « réussite ») et les pressions financières et réglementaires (choisir ce qui paraît le plus sûr aux auditeurs, et non ce qui convient à votre architecture). L’enseignement de la recherche est clair : la transparence et la divulgation sont indispensables pour préserver l’intégrité de la recherche et pour que vos choix de gouvernance restent utiles au-delà des discours des fournisseurs.
Satya Nadella : « La confiance est la monnaie ultime, et dans les données, on la mérite en étant explicite sur ce que l’on a fait et pourquoi. »
Les risques de biais à nommer à voix haute
Recherche sur la gouvernance et risques de biais liés aux outils&Biais fournisseur 40 %Biais de reporting 35 %Financier/réglementaire 25 %Biais fournisseurBiais de reportingFinancier/réglementaire
Votre liste de contrôle anti-biais (pragmatique, pas politique)
- Échantillonnage : comparez au moins une suite commerciale et une solution ouverte dans les écosystèmes AWS, Snowflake, Databricks, SAP et Oracle Cloud Infrastructure.
- Divulgation : documentez les sponsors, les raisons du choix des outils et ce que vous n’avez pas testé.
- Critères d’évaluation : profondeur de la traçabilité, adéquation RBAC/ABAC, journaux d’audit, accès aux API, formats d’export et intégration avec vos tables du lakehouse.
- Preuve de valeur : lancez un pilote à durée limitée sur un seul domaine ; mesurez le délai d’application des stratégies, le taux d’erreur et les frictions pour les utilisateurs.
- Contrôle des risques liés à la dépendance vis-à-vis du fournisseur : demandez comment l’enfermement (lock-in) se manifeste dans les métadonnées, les catalogues et les règles de workflow.
Mini-récit : vous arbitrez la véritable décision
Les achats poussent vers un fournisseur unique au nom de la « standardisation ». Les ingénieurs veulent de l’open source pour garder la main. La conformité réclame des fonctionnalités « certifiées » et des preuves d’audit propres. Votre rôle consiste à arbitrer : vous pouvez répondre aux exigences de conformité par des contrôles solides et des pistes d’audit, satisfaire les ingénieurs grâce aux API et à la portabilité, et convaincre les achats avec un retour sur investissement clair, sans laisser un seul groupe définir la gouvernance comme « tout ce que l’outil vend ».
Et si votre outil était racheté et que son prix triplait ?
Partez du principe que cela peut arriver. Testez dès maintenant la portabilité : pouvez-vous exporter votre glossaire métier, votre lignage et vos règles de stratégie dans des formats exploitables ? Si vos métadonnées ne peuvent pas être déplacées, votre gouvernance n’est pas un programme, c’est un abonnement.
8) Anticiper l’avenir : IoT, edge, données décentralisées et le lakehouse que vous hériterez
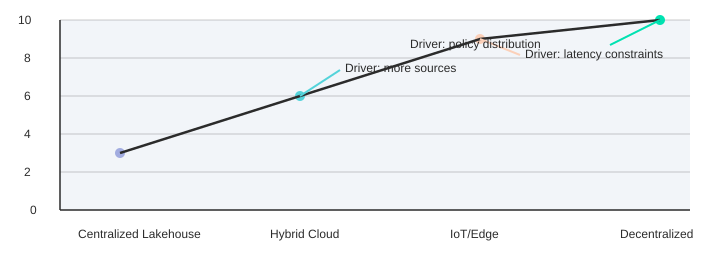
La gouvernance d’un lakehouse fonctionne au mieux lorsque les données sont principalement centralisées, adaptées au traitement par lots et contrôlées par quelques plateformes. La gouvernance de l’IoT et du edge computing bouscule rapidement ces hypothèses : vous faites face à davantage de sources (appareils, passerelles, applications), à un contrôle central moindre (les équipes déploient de manière indépendante) et à des contraintes de latence plus strictes (vous ne pouvez pas « attendre le traitement de nuit » pour décider de l’accès ou de la qualité). L’étude Stallion Journal souligne directement cette pression et recommande des extensions de gouvernance pour trois domaines émergents : les lacs de données IoT, les architectures décentralisées et le edge computing.
Pourquoi l’IoT et le edge mettent votre modèle actuel à l’épreuve
Avec les flux IoT, un même événement « client » peut arriver de plusieurs capteurs, dans des formats différents et à des moments différents. Si vos stratégies dépendent d’une mise à jour centrale unique du catalogue, vous devrez soit ralentir les opérations, soit accepter des angles morts. Les sites en edge créent également des copies locales des données pour gagner en rapidité et en résilience : vos pistes d’audit, votre lignage et vos règles de rétention doivent donc suivre les données, et non rester enfermés dans un plan de contrôle de type entrepôt.
Une architecture de données décentralisée exige une gouvernance portable
Dans une architecture de données décentralisée, les domaines publient leurs produits de données et font évoluer leurs schémas selon leur propre calendrier. C’est sain pour la vitesse de livraison, mais risqué si vos définitions de « DCP », de « consentement » ou de « périmètre HIPAA » ne sont pas cohérentes. Anticiper l’avenir signifie concevoir la gouvernance comme un service partagé : métadonnées extensibles, stratégies versionnées et contrôles d’identité fonctionnant pour toutes les équipes et toutes les régions, en phase avec l’appel de l’article à une adaptabilité de la conformité propre à chaque région.
S’appuyer sur des briques cloud-native que vous pourrez réutiliser
L’ensemble de référence autour de l’étude vous oriente vers des briques concrètes : Docker pour empaqueter les services de stratégie, Kubernetes pour les exécuter partout, Kafka pour diffuser les points d’application des contrôles, Elasticsearch pour une découverte rapide, et Postgres/PySpark pour un traitement gouverné. Vous ne choisissez pas des outils par effet de mode : vous choisissez ce qui peut fonctionner dans le cloud, sur site et en edge avec les mêmes contrôles.
« Tout échoue, tout le temps : concevez votre gouvernance en partant du principe que le changement est la norme, non la stabilité. » — Werner Vogels
Une feuille de route à petits paris pour avancer sans bloquer
Vous n’avez pas besoin de résoudre entièrement la gouvernance en edge dès aujourd’hui. En revanche, vous avez besoin de systèmes de métadonnées et de stratégies capables de s’étendre sans être réécrits. Commencez par piloter la détection d’anomalies assistée par l’IA sur les signaux de gouvernance (dérive de schéma, chemins d’accès inhabituels, exports hors des habitudes), puis étendez aux contrôles de stratégie automatisés à l’ingestion et au moment des requêtes. À mesure que votre périmètre grandit, renforcez la gestion des identités, envisagez une traçabilité inviolable de type blockchain pour les pistes d’audit critiques, et prévoyez un plan de reprise après sinistre adapté à votre niveau de risque.
| Environnement | Indice de complexité de la gouvernance (à titre illustratif) |
|---|---|
| Lakehouse centralisé | 3 |
| Cloud hybride | 6 |
| IoT/Edge | 9 |
| Décentralisé | 10 |
Rédigez vos principes de gouvernance comme si vous deviez être remplacé : définitions claires, stratégies portables et journaux de décisions qui survivent aux réorganisations. Le lakehouse que vous hériterez plus tard sera plus complexe qu’aujourd’hui, et votre futur vous-même dormira mieux si vous concevez dès maintenant en conséquence.
microsoft fabric lakehouse architecture : comprendre Microsoft Fabric pour l’analytique et l’ingénierie des données
Qu’est-ce que l’architecture lakehouse de Microsoft Fabric ?
L'architecture lakehouse de Microsoft Fabric est une conception de plateforme de données unifiée qui combine des éléments des lacs de données et des entrepôts de données pour stocker les données brutes ainsi que des jeux de données structurés et transformés dans un emplacement unique. Elle s'appuie sur Azure Data Lake Storage pour les volumes de données, sur les moteurs de calcul de Fabric pour le traitement et sur les modèles de l'architecture médaillon pour gérer les couches brute, enrichie et organisée. Les équipes peuvent ainsi analyser les données, exécuter des charges de travail de science des données et alimenter des rapports dans Power BI sans dupliquer les données.
Comment fonctionne l'architecture médaillon dans un lakehouse Fabric ?
L'architecture médaillon dans Fabric organise les données en couches : généralement bronze (données brutes), argent (données nettoyées et enrichies) et or (données organisées, prêtes pour l'analytique et la BI). Fabric intègre des outils d'ingestion et de transformation des données pour déplacer et transformer les données entre les couches. Vous pouvez ainsi mettre en œuvre des flux d'ingénierie et de préparation des données qui conservent une copie unique de vos données, réduisent la duplication et prennent en charge l'analytique et la science des données.
Comment implémenter un lakehouse dans Microsoft Fabric et en créer un ?
Pour implémenter un lakehouse dans Microsoft Fabric, commencez par connecter vos sources de données et ingérez-les dans un Azure Data Lake à l'aide des fonctionnalités d'ingestion de Fabric. Utilisez les moteurs de calcul de Fabric ou les flux de transformation de données (dataflows) pour appliquer le traitement de l'architecture médaillon, cataloguez les jeux de données dans OneLake et sécurisez les accès. Intégrez Power BI et d'autres outils d'analyse pour la production de rapports. La plateforme simplifie la gestion des données, prend en charge l'intégration des données existantes et du big data, et vous permet de transformer les données sans les déplacer inutilement.
Quelle est la différence entre un lakehouse et un entrepôt de données traditionnel dans Microsoft Fabric ?
Un lakehouse combine la souplesse des lacs de données, pour les données brutes et semi-structurées, avec les performances et la gestion de schéma d'un entrepôt de données. Dans Microsoft Fabric, le lakehouse permet de stocker les données dans Azure Data Lake Storage tout en offrant des performances de requête comparables à celles d'un entrepôt, grâce aux moteurs de calcul de Fabric. Vous bénéficiez ainsi des capacités d'un entrepôt de données, comme des données structurées et organisées pour l'analytique, tout en conservant la souplesse d'un lac de données pour les tâches modernes de données et d'ingénierie des données.
Comment Fabric gère-t-il l'ingestion des données et évite-t-il la duplication ?
Fabric prend en charge plusieurs modes d'ingestion des données (en flux continu, par lots et via des connecteurs vers les sources de données d'entreprise) vers un lac central, Azure Data Lake. En s'appuyant sur l'architecture médaillon et sur OneLake, Fabric privilégie une copie unique de vos données et des jeux de données logiques plutôt que des copies physiques multiples. Les outils d'intégration et de transformation des données vous permettent d'ingérer les données, de les transformer sur place et de fournir un accès cohérent à l'analytique et aux charges de travail de science des données, tout en limitant la duplication des données entre les systèmes.
Puis-je utiliser mes entrepôts de données et mes données Azure existants avec un lakehouse Fabric ?
Oui. Fabric s'intègre aux systèmes Microsoft et tiers, ce qui vous permet de fédérer les requêtes vers vos entrepôts de données existants, vers Synapse et vers Azure Data Lake Storage, tout en consolidant l'accès à l'ensemble de votre patrimoine de données. Vous pouvez ingérer ou référencer des données existantes, mettre en œuvre des modèles de data mesh et choisir entre le déplacement des données vers le lakehouse et leur accès direct, selon vos exigences en matière de gouvernance, de coûts et de performances.
Quels sont les cas d'usage courants d'un lakehouse Fabric en analytique et en science des données ?
Les cas d'usage courants incluent la gestion unifiée des données pour la BI avec Power BI, la préparation de grands jeux de données bruts pour le machine learning et la science des données, la création de pipelines ELT s'appuyant sur l'architecture médaillon, l'analyse des données à travers les systèmes d'entreprise, ainsi que la création d'un emplacement unique pour les données structurées et non structurées. Fabric simplifie le traitement des données, permet une analyse des données à grande échelle et prend en charge des architectures modernes comme le data mesh et les catalogues de données d'entreprise.
Comment fonctionnent la sécurité, la gouvernance et l'accès aux données dans un lakehouse Fabric ?
Fabric fournit un contrôle d'accès basé sur les rôles, des stratégies de données et une intégration avec Microsoft Purview et Azure Active Directory pour la gouvernance et la traçabilité des données. OneLake et les objets du lakehouse permettent des autorisations granulaires sur les données stockées dans Azure Data Lake Storage. Ils garantissent un accès sécurisé aux données, la conformité et des flux de préparation des données maîtrisés, tout en préservant l'auditabilité à chaque étape d'ingestion et de transformation.
Quels moteurs de calcul de Fabric dois-je utiliser pour les différentes charges de travail du lakehouse ?
Fabric propose plusieurs moteurs de calcul optimisés pour des charges de travail spécifiques : requêtes SQL interactives pour l’analytique et la BI, Spark pour le traitement de données volumineuses et l’ingénierie des données, ainsi que des moteurs spécialisés pour l’ingestion en temps réel. Choisissez les moteurs de calcul Fabric en fonction des caractéristiques de vos charges de travail : Spark pour les transformations à grande échelle, SQL d’entrepôt pour les requêtes BI et les moteurs de streaming pour l’ingestion continue, afin d’équilibrer coût, performances et besoins de traitement des données.
Où pouvez-vous en apprendre davantage et commencer à utiliser l’architecture lakehouse de Microsoft Fabric ?
Pour commencer, suivez les tutoriels Microsoft Learn, consultez la documentation sur l’architecture lakehouse dans Microsoft Fabric et explorez des exemples d’architecture médaillon dans Fabric. Commencez par connecter une source de données, ingérer les données brutes dans Azure Data Lake Storage, mettre en place un pipeline médaillon simple et visualiser les résultats dans Power BI, afin de comprendre comment Fabric simplifie la création d’un lakehouse et la diffusion d’analyses à partir d’un patrimoine de données unifié.