 UK
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 العربية
 עברית
 日本語
 한국어
Керуйте даними в lakehouse Microsoft Fabric: архітектура без безсонних ночей
By Mirko Peters · · Updated
Керуйте даними в архітектурі lakehouse у Microsoft Fabric без безсонних ночей. Спростіть аналітику завдяки надійному та легко керованому рішенню.
Automatically translated with AI from the original post. Read the English original
Знайома ситуація: на нараді хтось запитує: «Чи можемо ми довести, звідки взялося це число?», і в кімнаті стає тихо. Я бачив, як ця тиша тягнеться в компаніях, які мали «усі дані», але не мали жодних підтверджень. Lakehouse обіцяє одну платформу для всього: структурованих таблиць, хаотичних файлів, потокових даних у реальному часі, ознак для ML. Але ця обіцянка працює лише тоді, коли ви можете керувати всім цим, не зв’язуючи руки своїм командам. Цей допис значною мірою спирається на дослідження «Data Governance in Lakehouse» (Shah & Jain), опубліковане в журналі Stallion Journal у жовтні 2024 року, і додає людський вимір: скорочення, на які ви будете спокушатися, конфлікти інтересів, з якими зіткнетеся, та прості звички, які вберігають від паніки під час аудиту.
8 несподіваних фактів про керування в lakehouse Microsoft Fabric- Єдине керування артефактами: управління в Fabric однаково застосовується до таблиць lakehouse, файлів, блокнотів, конвеєрів і дашбордів, що дає змогу використовувати централізовані політики для даних і аналітичних артефактів.
- Автоматичне відстеження походження: походження даних фіксується автоматично для багатьох операцій (завантаження, трансформації, блокноти та дашборди), що забезпечує майже реальночасну видимість походження даних без додаткового налаштування.
- Інтеграція безпеки на рівні рядків і стовпців: lakehouse підтримує детальне керування доступом (на рівні рядків і стовпців), яке застосовується під час виконання запиту, тож керований доступ переміщується разом із даними незалежно від рушія, який їх використовує.
- Вбудована класифікація даних і мітки конфіденційності: Fabric показує класифікацію даних (типи чутливої інформації) та інтегрується з мітками конфіденційності Microsoft Purview, тож керування може використовувати виявлені класифікації для застосування політик.
- Політика як код для контролю життєвого циклу: політики керування (збереження, перевірки якості, шифрування, дозволені обчислювальні ресурси) можна описувати та застосовувати програмно, що забезпечує автоматичне дотримання правил на всіх етапах життєвого циклу lakehouse.
- Бездоганна ізоляція клієнта та робочих просторів: модель керування Fabric підтримує ізоляцію між кількома робочими просторами та політики, що враховують клієнт, тож ви можете обмежити спільний доступ і переміщення даних між проєктами, зберігаючи при цьому керовану співпрацю.
- Журнали змін і доступу з можливістю аудиту: усі операції, важливі для керування (читання та запис даних, зміни політик, призначення ролей), можна перевірити за журналами, які інтегруються з Microsoft Sentinel та SIEM-системами для моніторингу відповідності вимогам.
- Контракти даних із підтримкою керування: Fabric дає змогу створювати контракти даних і схеми з обов’язковими перевірками сумісності, тож споживачі отримують стабільні, керовані інтерфейси до даних lakehouse, а постачальники можуть безпечно змінювати свої дані.
1) Проблема «тихої наради»: навіщо lakehouse потрібне керування
Ви на огляді для керівництва. На екрані з’являється KPI: утримання доходу, час очікування пацієнтів, ризик відтоку клієнтів. Хтось питає: «Звідки взялося це число?» У кімнаті стає тихо. Ви не можете простежити набір даних, трансформацію чи те, хто минулого тижня змінив логіку. У цей момент проблема не в аналітиці, а в довірі до даних.
Lakehouse простими словами: один дах, дві обіцянки
Lakehouse — це практичне поєднання: гнучкість data lake (зберігати будь-що, швидко) та надійність data warehouse (узгоджені таблиці, висока продуктивність). Під одним дахом можна керувати структурованими та неструктурованими даними, виконувати аналітику в реальному часі й підтримувати навантаження машинного навчання. Саме ця цінність «все в одному» пояснює, чому ваша стратегія архітектури lakehouse має включати керування з першого дня.
Чому lakehouse посилює потребу в керуванні даними lakehouse
Lakehouse рухається швидко: потокові дані, часте перенавчання моделей і багато команд, які одночасно публікують дашборди. Ця швидкість множить ризики. Змішані типи даних і багато інструментів полегшують втрату контролю над визначеннями, дозволами та походженням даних. Коли ви не можете пояснити метрику, стейкхолдери перестають довіряти дашборду, навіть якщо число правильне.
- Дані в реальному часі збільшують ймовірність неузгоджених знімків і KPI, які постійно змінюються.
- Конвеєри ML додають нові артефакти для керування: ознаки, навчальні набори, результати моделей і сигнали дрейфу.
- Більше користувачів (аналітики, фахівці з даних, продуктові команди) означає більше шляхів доступу і більше способів порушити політику.
Governance — це не паперова робота, а спосіб безпечно випускати зміни
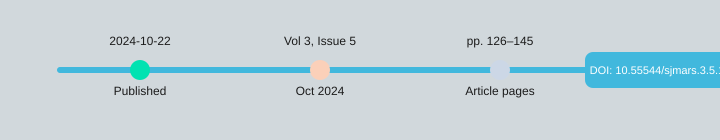
Рецензоване дослідження «Data Governance in Lakehouse» з журналу Stallion Journal (Samarth Shah, University at Albany; Shubham Jain, IIT Bombay), опубліковане 22-10-2024 у Volume 3, Issue 5 (pp. 126–145, ISSN 2583-3340; DOI: https://doi.org/10.55544/sjmars.3.5.12), розглядає governance як одночасно стратегічну необхідність і операційну вимогу. Головна думка проста: governance захищає вас у питаннях відповідності (GDPR, HIPAA, CCPA), знижує ризики та підтримує якість даних і довіру зацікавлених сторін.
Samarth Shah: «У lakehouse швидкість без governance — це не гнучкість, а просто швидша плутанина».
На практиці data governance у lakehouse означає, що ви можете відповісти на запитання «що означає цей KPI?» з доказами: метаданими, записами в каталозі, контролем доступу (наприклад, RBAC), журналами аудиту та лінійністю даних. Це не бюрократія. Це система, яка дозволяє швидко надавати аналітику, не порушуючи законів і не втрачаючи довіри.
| Елемент метаданих | Значення |
|---|---|
| Дата публікації | 22-10-2024 |
| Випуск журналу | Volume 3, Issue 5 (жовтень 2024) |
| Сторінки | 126–145 |
| ISSN | 2583-3340 |
2) Як виглядає «хороший governance», коли ваші дані скрізь
У lakehouse ваші дані не лежать «в одному місці». Вони розкидані по таблицях, файлах, потоках і ознаках для ML, часто на платформах на кшталт AWS, Snowflake або Databricks. Хороший governance — це спосіб зберегти дані придатними для використання та безпечними, не сповільнюючи команди. Думайте про це як про огородження, а не шлагбауми: ви забезпечуєте аналітику в реальному часі, одночасно відповідаючи вимогам GDPR, HIPAA та CCPA.
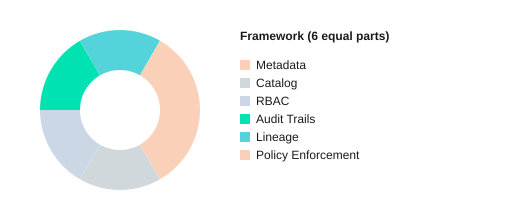
6 базових елементів, які ви справді впровадите
- Governance на основі метаданих: визначте власників, рівні конфіденційності, строки зберігання та правила якості в метаданих, щоб механізми контролю масштабувалися разом з обсягом і змінами.
- Найкращі практики каталогу даних: одне місце з можливістю пошуку для визначень, тегів і перевірених наборів даних, щоб люди перестали щось вгадувати.
- Контроль доступу RBAC: ролі відповідають завданням (аналітик, інженер, лікар), а не разовим дозволам.
- Відстеження лінійності даних: показуйте, звідки взялися дані, як вони змінювалися і що від них залежить.
- Журнали аудиту: хто, до чого, коли отримав доступ і що зробив, — критично для розслідувань і перевірок.
- Примусове виконання політик: автоматичні перевірки (маскування, збереження, погодження), які працюють за замовчуванням, а не за запитом.
Задокументований і примусовий governance (запобігає інцидентам лише другий)
Задокументований governance — це сторінка в wiki, де написано «PII має бути замасковано». Примусовий governance — це коли ваш lakehouse автоматично маскує PII на основі тегів у метаданих, блокує ризиковані експорти та веде журнал доступу. Дослідження сучасного governance для lakehouse показують, що автоматизація та метадані скорочують час ручного виконання правил і кількість помилок, бо платформа застосовує правила однаково.
Єдиний governance, коли ви працюєте з таблицями, файлами, потоками та ознаками
Потрібна єдина площина управління, яка працює з пакетними таблицями, файлами в об'єктному сховищі, потоками на кшталт Kafka та наборами ознак для ML. Коли governance єдиний, ті самі RBAC, теги та політики супроводжують дані, тож ваші дашборди, нотатники та моделі залишаються узгодженими й відповідними вимогам.
Невелике відступ: як «один спільний набір даних» перетворюється на 12 версій
Без відстеження лінійності даних набір «customer» копіюють у customer_v2, customer_clean, customer_final і «final_final». Незабаром команди сперечаються через цифри, бо ніхто не може довести, яка версія живила який звіт.
Shubham Jain: «Лінійність — це різниця між «мені здається» і «я можу довести», коли хтось ставить під сумнів ваші цифри».
Самоперевірка за 5 хвилин
- Чи можете ви знайти власника та тег конфіденційності для ваших 10 найважливіших наборів даних у каталозі?
- Чи контролюють доступ через RBAC ролі, а не окремі особи?
- Чи можете ви простежити KPI до джерел за допомогою лінійності менш ніж за 2 хвилини?
- Чи відповідають журнали аудиту сьогодні на запитання «хто переглянув або експортував це»?
- Чи виконуються політики автоматично (маскування, збереження, погодження), а не вручну?
Кожен механізм контролю пов'язаний з результатом: менше інцидентів доступу (RBAC + політики), швидші перевірки (журнали аудиту + каталог) і чистіша аналітика (метадані + лінійність).
3) Цифри, які роблять governance менш схожим на «накладні витрати»
Якщо управління даними звучить як «зайва бюрократія», результати дослідження допоможуть переосмислити його як вимірюваний операційний виграш. Коли ви застосовуєте управління на основі метаданих з автоматизацією та ML у lakehouse, ви не просто «додаєте контролі» — ви повертаєте час, підвищуєте довіру до даних і зменшуєте комплаєнс-ризики у спосіб, який фінансовий директор може відстежувати.
Управління на основі метаданих: ROI, який можна показати на слайді
Дослідження наводить три ключові результати за умови, що команди спираються на сильні метадані, каталогізацію, походження даних (lineage) і контроль доступу:
- До 40% покращення ефективності управління
- 35% зростання якості даних
- 92% досягнення відповідності GDPR та HIPAA (GDPR/HIPAA)
На практиці це 40% приросту ефективності часто означає менше ручних перевірок, менше циклів «хто відповідає за цей набір даних?» і швидші погодження доступу та спільного використання. Ваш беклог скорочується, бо рутинні перевірки переходять від людей до систем, а черга інцидентів зменшується, бо до продакшену доходить менше проблем.
Автоматизоване забезпечення політик: порівняння «до і після», яке змінює розмову
Найпереконливіший доказ співвідношення «накладні витрати vs. віддача» — перехід від ручних контролів до автоматизованого забезпечення політик:
- Час забезпечення політик: 72% → 28%
- Частка помилок: 45% → 15%
Це не незначна оптимізація. Це різниця між управлінням як шлагбаумом і управлінням як огорожею. Ви менше витрачаєте часу на винятки і більше — на безпечне самообслуговування.
«Уніфіковане управління приживається лише тоді, коли робочий процес простіший за обхідний шлях.» —Taylor, Singh, & Green (2021)
Реальність впровадження: добре для технічних користувачів, складніше для решти
Оцінки зручності були високими серед дata scientists, бізнес-аналітиків і ІТ-адміністраторів (4,2–4,7/5). Але дослідження також вказує на типовий розрив: нетехнічним користувачам потрібні простіші інтерфейси, зрозуміліші визначення та покрокові робочі процеси. Якщо ви хочете отримати наведені вище цифри, заплануйте бюджет на навчання й супровід, а не лише на інструменти.
Ключові показники з першого погляду
| Показник | Результат |
|---|---|
| Покращення ефективності управління | До 40% |
| Зростання якості даних | 35% |
| Частка відповідності GDPR та HIPAA | 92% |
| Час забезпечення політик | 72% (вручну) проти 28% (автоматизовано) |
| Частка помилок | 45% (вручну) проти 15% (автоматизовано) |
| Оцінка зручності | 4,2–4,7 з 5 |
| Скорочення часу обробки | 25% |
4) Інструменти, прототипи та невідворотна правда про впровадження
Що саме зробило дослідження (простими словами)
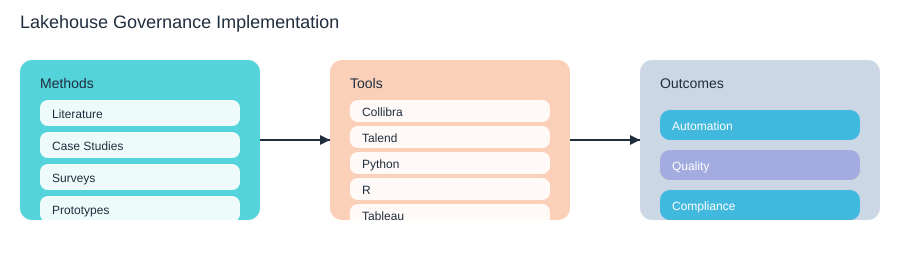
Дослідження Stallion Journal не розглядало управління як проблему для презентації. Воно використало чотири методи, які ви впізнаєте з реальної роботи: воно вивчило літературу (систематичні огляди), розглянуло галузеві кейси, опитало зацікавлених сторін і потім протестувало прототипи. Остання частина важлива, бо управління lakehouse ламається в проміжках між політикою та конвеєрами — особливо коли дані надходять швидко, часто змінюються і походять від багатьох команд.
Стек прототипів: що вони справді пробували
В експериментах дослідження використовувало Collibra і Talend для шаблонів управління та інтеграції, а також аналітичні інструменти (Python, R, Tableau) для перевірки зручності та результатів. Ви можете повторити цей підхід, працюючи з управлінням у Databricks, налаштуванням Snowflake lakehouse або ширшим cloud-native управлінням даними з Kubernetes, Docker, Kafka, Postgres, PySpark і Elasticsearch у складі.
Послідовність впровадження, яку можна скопіювати (і не збожеволіти)
Успіх впровадження залежить від управління, підтриманого інструментами, і від вашої здатності справлятися зі швидкістю, складністю та обмеженнями ресурсів. Практична послідовність така:
- Почніть із каталогу + RBAC: застосуйте найкращі практики каталогізації даних (чітка відповідальність, бізнес-терміни та «золоті» набори даних). Потім призначте доступ через RBAC.
- Додайте lineage: відстежуйте вплив на upstream і downstream, щоб зміни не заскакували аналітиків чи аудиторів.
- Автоматизуйте забезпечення політик: там, де це можливо, перейдіть від ручних погоджень до policy-as-code з журналами аудиту.
Harris & Nguyen (2020): «RBAC на папері простий; він стає реальним у день, коли ви прив'язуєте його до команд, а не до посад.»
Ваш щоденний ворог: швидкість і неузгоджені потоки
Високошвидкісні потоки даних (наприклад, потоки типу Kafka) створюють «дрейф схеми», запізнілі події та дублікати записів. Саме тут управління даними стає заплутаним: каталог каже, що поле є обов’язковим, але потік його пропускає; правила якості очікують один часовий штамп, а продюсери надсилають три. У дослідженні це названо повторюваною перешкодою, особливо коли команди недоукомплектовані.
Розростання інструментів: коли системи суперечать одна одній
Остерігайтеся класичної проблеми «розщепленого мозку»: каталог показує, що набір даних A має статус «обмежений», але групи IAM досі дозволяють широкий доступ. Або ваші політики управління в Databricks не збігаються з налаштуваннями хмарного IAM. Розглядайте «єдине джерело істини» як цільову архітектурну мету, а не як гасло.
| Призма для рішень | Тримайте все простим |
|---|---|
| Купувати чи створювати | Купуйте каталог і робочі процеси; створюйте власноруч лише тонкі коннектори та перевірки. |
| Уникайте лабіринту управління | Один каталог, одна модель політик, мінімум власних ролей, автоматизовані аудити. |
5) Найболючіші проблеми управління та їх пріоритезація
Якщо вам здається, що управління даними складніше, ніж «має бути», ви не одні такі. У результатах дослідження 78% організацій називають управління метаданими головною болючою точкою. Ця статистика має дати відчуття, що вас розуміють, адже в lakehouse все рухається швидко, а метадані є картою, яку ви намагаєтеся оновлювати, поки дороги ще будуються.
Чому метадані ламаються першими (і продовжують ламатися)
Метадані важко підтримувати, бо:
- Визначення розходяться: «активний клієнт» означає одне для фінансового відділу і інше для відділу зростання.
- Відповідальність розмита: ніхто не впевнений, хто затверджує нове поле, нову таблицю чи нове правило збереження.
- Конвеєри змінюються щотижня: нові джерела, нові з’єднання, нові ML-ознаки, а ваш каталог і теги відстають.
І все ж інвестиції в управління дають вимірний результат: 88% повідомляють про покращення управління якістю даних, а 81% – про краще управління безпекою lakehouse. Це і є віддача від невидимої, але необхідної роботи.
Пріоритезація управління: виправляйте правильні речі в правильному порядку
- Спочатку метадані та відповідальність: визначте критичні елементи даних, призначте власника даних і куратора, стандартизуйте бізнес-терміни в каталозі.
- Далі контроль доступу: впровадьте RBAC з принципом найменших привілеїв і чіткі шляхи погодження для винятків.
- Походження даних і журнали аудиту: відстежуйте, звідки взялися дані, як вони змінювалися і хто з ними працював. Саме тут швидко отримуються відповіді на питання щодо GDPR, HIPAA та CCPA.
- Автоматизація наостанок (але поступово): автоматизуйте перевірки політик, тегування та виявлення аномалій, щоб дотримання правил не залежало від героїзму окремих людей.
Що ламається, коли HIPAA зустрічається з CCPA?
Уявіть lakehouse, де набір медичних даних, що регулюється HIPAA (медичні візити пацієнтів), об’єднується з маркетинговим набором даних, на який поширюється CCPA (поведінка у вебі). Першим зазвичай ламається класифікація та згода: теги PHI відсутні, прапорці згоди не передаються через з’єднання, а downstream-дашборд показує більше, ніж задумано. Без походження даних ви не доведете, куди потрапили дані; без RBAC не зупините широкий доступ; без журналів аудиту та управління ідентичністю не продемонструєте відповідальність.
«Справжній виклик полягає не в тому, щоб змусити ШІ працювати, а в тому, щоб він працював відповідально в системах, які у вас уже є».
— Dr. Fei-Fei Li
Простий ритуал, який допомагає не втрачати глузд: щомісячна ретроспектива з управління
Проводьте 45-хвилинну щомісячну ретроспективу з ІТ, безпекою та бізнес-власниками. Розгляньте: три головні прогалини в метаданих, три головні винятки в доступі, одну помилку походження даних і одну перемогу в автоматизації. Фіксуйте дії у спільному трекері та призначайте одного відповідального на кожен пункт.
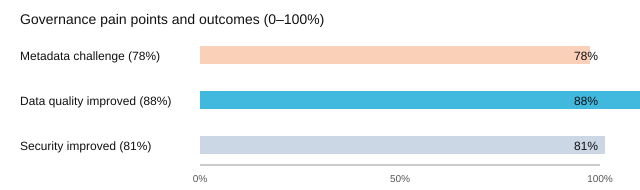
6) Відповідність без параної: GDPR, HIPAA, CCPA у lakehouse
У lakehouse ставтеся до відповідності як до обмеження дизайну, а не до поспішної підготовки в останню мить. Коли ви вбудовуєте механізми контролю в прийом даних, зберігання та доступ з першого дня, відповідність GDPR HIPAA і управління даними CCPA перестають бути пожежними тривогами та стають звичайною роботою. Дослідження Stallion Journal «Data Governance in Lakehouse» показує чому: організації, які використовували керування на основі метаданих, автоматизацію та ML, повідомили про зростання рівня відповідності для GDPR і HIPAA до 92%. Використовуйте це як орієнтир, а не як гарантію.
«Безпека є процесом, а не продуктом, а управління є тим, що дозволяє зберігати цей процес чесним».
— Bruce Schneier
Зіставте механізми контролю з вимогами регуляторів: ваш базовий набір інструментів відповідності
Недостатньо «виконати GDPR» чи «виконати HIPAA», просто написавши політики. Вимоги потрібно відобразити на повторювані контролі всередині lakehouse:
- RBAC (контроль доступу на основі ролей): обмежити, хто може бачити PHI/PII і хто може їх експортувати.
- Журнали аудиту lakehouse: довести, хто, коли, з якої локації отримав доступ до яких даних і що саме з ними зробив.
- Відстеження походження даних (data lineage): показати, звідки взялися чутливі поля, як вони змінювалися і куди потрапили.
- Примусове застосування політик: послідовно застосовувати маскування, збереження та обмеження мети використання в усіх інструментах.
- Керування метаданими та каталог: класифікувати дані, позначати рівень конфіденційності та запускати автоматизацію.
| Регулювання | На що звертають увагу аудитори | Контроль у lakehouse |
|---|---|---|
| GDPR | Законний доступ, мінімізація, збереження | RBAC, маскування, політики збереження, lineage |
| HIPAA | Журнали доступу, захисні заходи, мінімальні привілеї | Журнали аудиту, RBAC, шифрування, моніторинг |
| CCPA | Інвентаризація даних, обробка запитів на доступ і видалення | Каталог і метадані, lineage, робочі процеси політик |
Наступна хвиля: регіональні правила та застарілі обмеження
У дослідженні окремо згадано майбутню роботу, до якої варто готуватися вже зараз: відповідність вимогам, специфічним для регіону, і краща адаптивність для застарілих або обмежених середовищ. Якщо ви працюєте в кількох штатах або країнах, будуйте політики, які можуть відрізнятися залежно від регіону (строки зберігання, правила згоди, повідомлення про витоки). Якщо ви ще користуєтеся старішими системами, почніть з меншого обсягу і інтегруйте поступово. Автоматизація допомагає, але складність справжня.
Прохід «дня аудиту»: що знадобиться показати
- Інвентаризація даних: де зберігаються PII/PHI, хто є власником і для чого вони використовуються (
catalog + tags). - Докази доступу: ролі RBAC, погодження та експорти журналів аудиту lakehouse.
- Підтвердження походження даних: шляхи від джерела до звіту для ключових наборів даних і чутливих стовпців.
- Підтвердження політик: маскування, збереження, процеси видалення та журнали примусового застосування.
- Учасники зустрічі: власник даних, безпека, адміністратор платформи, комплаєнс/юридичний відділ і один аналітик, який використовує дані.
Огляд: базовий рівень проти керованого lakehouse
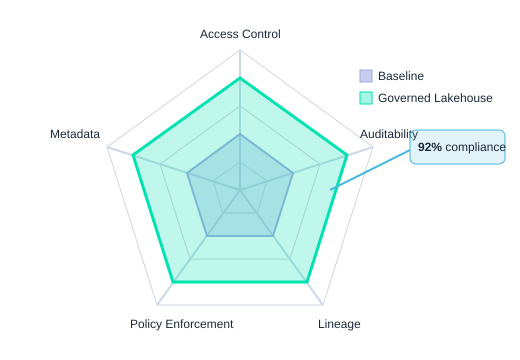
Коротке, але чесне зауваження: якщо ваша організація невелика, почніть з простої базової конфігурації: RBAC, логування та легкого каталогу, і лише потім купуйте корпоративні інструменти. Дослідження чітко показує, що складність впровадження може стати реальною перешкодою, особливо коли ресурсів бракує.
7) Упередженість щодо вендорів, політика і те, про що мовчать презентації з управління даними
Можна на папері спроєктувати чітку модель управління lakehouse, а потім побачити, як вона деформується, щойно в процесі з'являються інструменти управління даними. Неприємна правда проста: інструменти й вендори визначають, як виглядають «найкращі практики», бо саме вони визначають, що легко продемонструвати, легко купити і легко звітувати.
У розділі про конфлікт інтересів дослідження Stallion Journal щодо lakehouse пряме на це вказує. Воно виділяє три джерела упередженості, які слід припускати в будь-якій програмі управління: упередженість вендора (перевага платформам на кшталт стеків Collibra Talend governance або іншим комерційним пакетам), упередженість звітності організації (ділитися лише метриками «успіху») і фінансові та регуляторні тиски (вибір того, що виглядає найбезпечнішим для аудиторів, а не того, що пасує вашій архітектурі). Ключовий висновок дослідження такий: прозорість і розкриття інформації необхідні для збереження доброчесності досліджень і щоб ваші рішення щодо управління залишалися корисними, а не зводилися до наративів вендорів.
Satya Nadella: «Довіра — це найцінніша валюта, а в роботі з даними її здобувають, чітко пояснюючи, що ви зробили і чому».
Ризики упередженості, які варто назвати вголос
Дослідження управління та інструментів: ризики упередженості Упередженість вендора 40% Упередженість звітності 35% Фінансові/регуляторні 25% Упередженість вендора Упередженість звітності Фінансові/регуляторні
Ваш контрольний список щодо упередженості (практичний, а не політичний)
- Вибірка: порівняйте щонайменше один комерційний пакет і одне відкрите рішення в екосистемах AWS, Snowflake, Databricks, SAP і Oracle Cloud Infrastructure.
- Розкриття інформації: документуйте спонсорів, причини вибору інструментів і те, що ви не тестували.
- Критерії оцінювання: глибина lineage, відповідність RBAC/ABAC, журнали аудиту, доступ через API, формати експорту та інтеграція з вашими таблицями lakehouse.
- Доказ цінності: проведіть обмежений у часі пілотний проєкт на одному домені; вимірюйте час примусового застосування політик, частоту помилок і труднощі для користувачів.
- Перевірка ризику прив'язки до вендора на платформі даних: запитайте, як прив'язка до вендора проявляється в метаданих, каталогах і правилах робочих процесів.
Міні-історія: ви визначаєте реальне рішення
Закупівля просуває одного постачальника заради «стандартизації». Інженери хочуть відкритого коду для контролю. Комплаєнс вимагає «сертифікованих» функцій і чистих доказів для аудиту. Ваше завдання — перекласти ці вимоги: можна відповідати вимогам комплаєнсу через надійні контролі та журнали аудиту, задовольнити інженерів через API і переносимість, а закупівлю — через зрозумілу рентабельність, і при цьому не дозволити жодній групі визначати управління як «те, що продає інструмент».
Що, якщо ваш інструмент придбають, а ціну втричі підвищать?
Вважайте, що таке може статися. Перевірте переносимість уже зараз: чи можна експортувати бізнес-глосарій, лінійність даних і правила політик у придатних для використання форматах? Якщо метадані неможливо перенести, ваше управління — це не програма, а підписка.
8) Підготовка до майбутнього: IoT, edge, децентралізовані дані та лейкхаус, який вам дістанеться
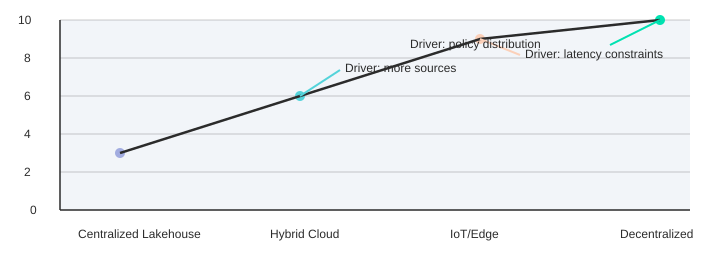
Управління вашим лейкхаусом найкраще працює, коли дані переважно централізовані, орієнтовані на пакетну обробку та контролюються кількома платформами. Управління IoT і edge-обчисленнями швидко руйнує ці припущення: вам доводиться мати справу з більшою кількістю джерел (пристрої, шлюзи, застосунки), меншим центральним контролем (команди розгортають рішення незалежно) і жорсткішими обмеженнями на затримку (ви не можете «чекати на нічне завдання», щоб вирішити питання доступу чи якості). Дослідження Stallion Journal прямо вказує на цей тиск і рекомендує розширення управління для трьох нових напрямів: IoT-озер даних, децентралізованих архітектур і edge-обчислень.
Чому IoT і edge випробовують вашу поточну модель
У потоках IoT одна і та сама подія про «клієнта» може надходити з кількох сенсорів, у різних форматах і в різний час. Якщо ваші політики залежать від єдиного централізованого оновлення каталогу, ви або сповільните роботу, або змиритеся зі сліпими зонами. Edge-локації також створюють локальні копії даних для швидкодії та стійкості, тож журнали аудиту, лінійність і правила збереження мають супроводжувати дані, а не залишатися в одній площині управління у стилі сховища.
Децентралізована архітектура даних потребує переносного управління
У децентралізованій архітектурі даних домени публікують дata-продукти та змінюють схеми за власним графіком. Це корисно для швидкості поставки, але ризиковано, якщо ваші визначення «PII», «згоди» або «сфери дії HIPAA» не є узгодженими. Підготовка до майбутнього означає, що ви проєктуєте управління як спільний сервіс: розширювані метадані, версіоновані політики та механізми ідентифікації, які працюють між командами і регіонами, відповідно до заклику статті щодо адаптивності до регіональних вимог комплаєнсу.
Спирайтеся на хмарно-нативні блоки, які можна успадкувати
Набір довідкових інструментів навколо дослідження вказує на практичні будівельні блоки: Docker для пакування сервісів політик, Kubernetes для їх запуску всюди, Kafka для потокових точок примусового застосування політик, Elasticsearch для швидкого пошуку та виявлення даних, а також Postgres/PySpark для керованої обробки. Ви обираєте інструменти не за модою — ви обираєте те, що може працювати в хмарі, локально та на edge з однаковими контролями.
«Усе ламається, весь час — проєктуйте управління так, ніби очікуєте змін, а не стабільності.» — Вернер Фогельс
Дорожня карта малих ставок, що дозволяє рухатися далі
Вам не потрібно повністю розв’язати управління на edge вже сьогодні. Але вам потрібні системи метаданих і політик, які можна розширювати без переписування. Почніть з пілотування виявлення аномалій на основі ШІ у сигналах управління (дрейф схем, незвичайні шляхи доступу, експорти, що не відповідають звичним шаблонам), а потім розширюйте до автоматизованих перевірок політик під час приймання даних і під час запитів. Із зростанням масштабу додавайте сильніше управління ідентифікацією, розгляньте захист критичних журналів аудиту від підробки за принципом блокчейну та плануйте аварійне відновлення відповідно до рівня ризику.
| Середовище | Індекс складності управління (ілюстративний) |
|---|---|
| Централізований лейкхаус | 3 |
| Гібридна хмара | 6 |
| IoT/Edge | 9 |
| Децентралізована модель | 10 |
Пишіть принципи управління так, ніби вас колись замінять: чіткі визначення, переносні політики та журнали рішень, які переживуть реорганізації. Лейкхаус, який ви успадкуєте пізніше, буде хаотичнішим, ніж сьогодні, і вашому майбутньому «я» буде спокійніше спати, якщо ви проєктуєте з цим уже зараз.
архітектура lakehouse у Microsoft Fabric: розуміємо Microsoft Fabric для аналітики та інжинірингу даних
Що таке архітектура лейкхаусу Microsoft Fabric?
Архітектура lakehouse у Microsoft Fabric – це єдина платформа даних, що поєднує елементи озер даних і сховищ даних, щоб зберігати як сирі дані, так і структуровані, трансформовані набори даних в одному місці. Вона використовує Azure Data Lake Storage для зберігання обсягів даних, обчислювальні движки Fabric для обробки та патерни архітектури medallion для керування шарами raw, enriched і curated. Це дозволяє командам аналізувати дані, виконувати навантаження з data science і створювати звіти в Power BI без дублювання даних.
Як працює архітектура medallion у lakehouse Fabric?
Архітектура medallion у Fabric організовує дані в шари – зазвичай bronze (сирі дані), silver (очищені та збагачені) і gold (підготовлені для аналітики та BI). Fabric інтегрує інструменти для завантаження та трансформації даних, які переміщують і перетворюють дані між шарами. Це забезпечує робочі процеси data engineering і підготовки даних, зберігає одну копію ваших даних, зменшує дублювання та підтримує аналітику і data science.
Як впровадити lakehouse у Microsoft Fabric і створити lakehouse?
Щоб впровадити lakehouse у Microsoft Fabric, почніть з підключення джерел даних і завантаження даних в Azure Data Lake за допомогою можливостей завантаження даних Fabric. Використовуйте обчислювальні движки Fabric або трансформації dataflow, щоб застосувати обробку за архітектурою medallion, каталогізувати набори даних в OneLake та захистити доступ. Під’єднайте Power BI та інші інструменти аналітики для звітності. Платформа спрощує керування даними, підтримує інтеграцію даних між наявними та великими даними і дозволяє трансформувати дані без зайвого переміщення.
Яка різниця між lakehouse і традиційним сховищем даних у Microsoft Fabric?
Lakehouse поєднує гнучкість озер даних для сирих і напівструктурованих даних з продуктивністю та керуванням схемами сховища даних. У Microsoft Fabric lakehouse дозволяє зберігати дані в Azure Data Lake Storage і водночас забезпечує продуктивність запитів, характерну для сховища, завдяки обчислювальним движкам Fabric. Це дає можливості сховища даних – наприклад, підготовлені структуровані дані для аналітики – і зберігає гнучкість озера даних для сучасних завдань з даними та data engineering.
Як Fabric забезпечує завантаження даних і уникає дублювання?
Fabric підтримує кілька патернів завантаження даних – потокове, пакетне та з’єднувачі до корпоративних джерел даних – у центральне озеро (Azure Data Lake). Використовуючи архітектуру medallion і OneLake, Fabric забезпечує одну копію ваших даних і логічні набори даних замість фізичних копій. Інструменти інтеграції та трансформації дозволяють завантажувати дані, трансформувати їх на місці та забезпечувати узгоджений доступ до даних для навантажень аналітики та data science, мінімізуючи дублювання даних між системами.
Чи можна використовувати наявні сховища даних і дані Azure разом з lakehouse Fabric?
Так. Fabric інтегрується із системами Microsoft і сторонніх вендорів, що дає змогу федеративно виконувати запити до наявних сховищ даних, Synapse і Azure Data Lake Storage та консолідувати доступ до масиву даних. Ви можете завантажувати або посилатися на наявні дані, впроваджувати патерни data mesh і вирішувати, чи переносити дані в lakehouse, чи отримувати до них доступ напряму, залежно від вимог до управління, вартості та продуктивності.
Які типові сценарії використання lakehouse Fabric в аналітиці та data science?
Типові сценарії включають єдине керування даними для BI з Power BI, підготовку великих сирих наборів даних для машинного навчання та data science, побудову конвеєрів ELT за архітектурою medallion, аналіз даних із корпоративних систем і створення єдиного місця для структурованих та неструктурованих даних. Fabric спрощує обробку даних, забезпечує масштабований аналіз і підтримує сучасні архітектури даних, як-от data mesh і корпоративні каталоги даних.
Як працюють безпека, управління та доступ до даних у lakehouse Fabric?
Fabric надає контроль доступу на основі ролей, політики даних та інтеграцію з Microsoft Purview і Azure Active Directory для управління та відстеження походження даних. OneLake і конструкції lakehouse дозволяють детально налаштовувати дозволи для даних, що зберігаються в Azure Data Lake Storage. Це забезпечує безпечний доступ до даних, відповідність вимогам і контрольовані робочі процеси підготовки даних, зберігаючи можливість аудиту на всіх етапах завантаження та трансформації.
Які обчислювальні движки Fabric варто використовувати для різних навантажень у lakehouse?
Fabric пропонує кілька обчислювальних движків, оптимізованих для конкретних типів навантажень: інтерактивні SQL-запити для аналітики та BI, Spark для обробки великих даних та інженерії даних, а також спеціалізовані движки для ingestion у реальному часі. Обирайте обчислювальні движки Fabric залежно від характеристик навантаження: використовуйте Spark для великомасштабних трансформацій, warehouse SQL для BI-запитів і потокові движки для безперервного ingest, щоб збалансувати вартість, продуктивність і потреби в обробці даних.
Де дізнатися більше та як почати роботу з архітектурою lakehouse у Microsoft Fabric?
Щоб почати, пройдіть навчальні матеріали Microsoft Learn, перегляньте документацію щодо архітектури lakehouse у Microsoft Fabric і ознайомтеся з прикладами архітектури medallion у Fabric. Почніть із підключення джерела даних, завантаження сирих даних до Azure Data Lake Storage, реалізації простого конвеєра medallion і візуалізації результатів у Power BI, щоб зрозуміти, як Fabric спрощує створення lakehouse і доставку аналітики з єдиного середовища даних.