 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
.NETマイクロサービスにおける「分散モノリス」の罠を避ける
By Mirko Peters ·
エンジニアリングチームがモノリシックなアプリケーションからマイクロサービスアーキテクチャへ移行する際、多くの場合、次のような明確な約束を追い求めています。機能の提供スピードの向上、独立したスケーラビリティ、障害の局所化、そして最新の技術スタックを自由に試せることです。
Automatically translated with AI from the original post. Read the English original
エンジニアリングチームがモノリシックなアプリケーションからマイクロサービスアーキテクチャへ移行する際、多くの場合、次のような明確な約束を追い求めています。機能の提供スピードの向上、独立したスケーラビリティ、障害の局所化、そして最新の技術スタックを自由に試せることです。しかし、多くの .NET 組織は開発の勢いが失速する壁に直面します。俊敏で疎結合なエコシステムではなく、分散システムの運用の複雑さと、従来のモノリスの密結合を併せ持つ「分散モノリス」を抱え込むことになるのです。
この問題は、悪意や意図から生じることはほとんどありません。複数のサービス間でデータベースを共有する、同期的な HTTP 呼び出しに過度に依存する、API ガバナンスが管理上のボトルネックになってしまう、といった目立たないアーキテクチャ上の選択から、徐々に入り込んでくるのが普通です。本記事では、分散モノリスの罠の兆候を確認し、ネットワーク層に潜む隠れたパフォーマンス問題を明らかにします。さらに、最新のオブザーバビリティツールを使ってアーキテクチャのボトルネックを特定し、.NET マイクロサービスで独立したスケーリングを取り戻すための実践的な戦略を順に解説します。開発スピードの低下に悩まされているチームは少なくありません。こうしたパターンを理解することが、俊敏性を取り戻す第一歩になります。
マイクロサービスアーキテクチャ:見えにくい複雑さ
分散モノリス
兆候
アプリケーションをマイクロサービスに分割すれば、パフォーマンスの問題は自動的に解決すると考えるかもしれません。しかし、簡単に分散モノリスに陥ってしまいます。これは、サービス同士が互いに強く依存し、分割による本来の利点が失われる状態です。次のような典型的な兆候が見られる場合があります。
- 標準的な業務処理のたびに、同期呼び出しに依存している。
- 個々の変更をデプロイするたびに、ダウンタイムや後続サービスの破損を招くリスクがあり、チームが苦労している。
- データベースを共有しているため、スキーマの変更を複数の開発チーム間で密接に調整しなければならない。
- 別々のプロセスやコンテナで実行されているにもかかわらず、コンポーネントが密結合したままである。
速度への影響
分散モノリスは、当初は予想しなかった形でシステムを遅くすることがあります。サービス間の呼び出しが一回行われるたびに遅延が加わるため、ネットワーク遅延が増加します。メモリ内で瞬時に完了するモノリシックなアプリケーションとは異なり、マイクロサービスアーキテクチャでは、パフォーマンスのボトルネックがデータベースや CPU からネットワーク層へ移ります。マイクロサービス間の同期呼び出しは遅延を積み重ね、モノリスではこれらの呼び出しはプロセス内で処理されます。その結果、サービスを独立してスケーリングすることや、障害を効果的に分離することができなくなり、依存関係のツリーが大きくなるにつれてパフォーマンスの課題も深刻化していきます。
適切な境界設計をせずにモノリシックなアプリケーションを分散させようとすると、深刻なパフォーマンス課題に直面することがよくあります。コンポーネント同士が強く依存したままになり、適切に構造化されたマイクロサービスがもたらす独立したスケーリングや障害分離の利点は得られません。
調整のオーバーヘッド
API ガバナンス
マイクロサービスアーキテクチャには、強固なAPI ガバナンスが欠かせません。技術的負債や重複した作業が蓄積しないよう、すべての変更をレビューして承認する必要があります。ガバナンスが厳しすぎれば開発は極端に遅くなり、緩すぎれば、ほとんど一夜にして構造的な技術的負債が積み上がるおそれがあります。
ガバナンスが緩すぎても厳しすぎても、技術的負債、重複した作業、開発プロセスの大幅な減速につながりかねません。
要するに、技術的負債を非常に速いペースで積み上げているのです。そして最終的には、それらすべてを取り除いて一からやり直すために、より多くの費用と時間をかけなければならなくなります。
ガバナンスモデルは、開発者に実際に恩恵をもたらすように設計する必要があります。自動化は、管理上の負担を増やすことなく、API の品質、セキュリティ、一貫性の向上に役立ちます。
ガバナンスが開発者のメリットになるように設計され、自動化によって強化されると、API の品質、セキュリティ、一貫性を高めるきっかけになります。
API は、より広範なビジネス戦略において重要な役割を果たします。API を最優先の存在として扱う必要があります。
最新の「state of API integration」レポートでは、企業の 84 パーセントが、API は中核的なビジネス戦略にとって重大または非常に重大であると回答しています。
チーム間のコラボレーション
マイクロサービスでは、チーム間の継続的な調整が欠かせません。会議の準備、ドメインをまたぐコンテキストの切り替え、チーム横断的な役割の明確化に、何時間も費やすことになります。こうした作業だけで、週の労働時間の大部分を簡単に占めてしまう可能性があります。
| 調整コストの要因 | 説明 |
|---|---|
| 意思決定の遅延 | 多数の関係者や煩雑な承認プロセスによる遅延 |
| コンテキストの切り替え | 部門横断的な調整ポイントに注意が分散すること |
| 情報の劣化 | 組織の階層を経由する過程で、重要な知識が失われたり歪められたりすること |
| 役割の曖昧さ | 責任の所在が不明確になり、作業の漏れや開発の重複が生じること |
| 調整作業 | 所要時間 |
|---|---|
| 会議の準備 | 週に 8 時間以上 |
| 調整作業全般 | ナレッジワーカーの作業時間の 35~80% |
調整のオーバーヘッドは、気づかないうちに開発のスピードを損なう可能性があることを認識する必要があります。作業の漏れや重複を避けるには、責任範囲を明確にし、コミュニケーションのチャネルを効率化することが必須です。
.NET エコシステムの課題
プラットフォームエンジニアリング
.NET エコシステムにおけるマイクロサービスアーキテクチャには、固有のエンジニアリング上の課題があります。コードの重複や冗長性に頻繁に直面します。これらは保守の負担を増やし、データの不整合を招くリスクもあります。開発者は、インフラを稼働させるためだけに過剰な定型コードを扱うことがよくあります。ドメインモデルをサービス間で不適切に共有すると、ソースコードの整理が極端に難しくなります。コピー&ペーストのアンチパターンは、バグ修正を遅らせ、長期的な保守をいっそう複雑にします。
- コードの重複は、継続的な保守コストの増大につながります。
- サービス間で共有されるモデルは、スキーマの更新を危険なものにします。
- 開発者がサービスのロジックをコピー&ペーストすると、重要なバグ修正が遅れる可能性があります。
ドメインの境界
.NET でマイクロサービスを構築する際は、ドメインの境界を明確に定義する必要があります。これを怠ると、開発者の認知負荷が大幅に増大します。同時に多くのアーキテクチャ上の要求が重なると、チームは対応しきれなくなります。標準やコンプライアンスの遵守も難しくなり、信頼性の問題を引き起こしたり、全体的なセキュリティ態勢を弱めたりする可能性があります。
- 開発者が複数の相互依存するサービスを同時に扱うため、認知負荷が急激に高まります。
- 標準化とエンタープライズ コンプライアンスを一貫して適用することが、より困難になります。
- ドメインの境界が不適切に定義されていると、信頼性とセキュリティが損なわれます。
マイクロサービスアーキテクチャには魅力的なメリットがある一方で、その隠れた複雑さに先手を打って対処する必要があります。分散モノリスの兆候に注意し、調整のオーバーヘッドを管理し、.NET 特有のプラットフォームの課題に正面から取り組みましょう。
時限爆弾: パフォーマンスの問題
マイクロサービス化すればシステムは自然に高速になると考えるかもしれません。しかし、厳密な設計がなければ、インフラにとって時限爆弾になりかねません。多くのエンジニアリングチームは、一般的なパフォーマンスの問題を本番環境にデプロイした後に初めて発見します。これらの問題は表面下に潜んでおり、ピーク時の負荷の下でアプリケーションの足を引っ張る機会をうかがっています。ネットワークの遅延、連鎖的な障害ポイント、データベースの競合が、どのようにアーキテクチャを慢性的な本番環境の悩みの種に変えてしまうのかを理解しておく必要があります。
ネットワークの遅延
プロセス内呼び出しとネットワーク呼び出しの比較
モノリシックなアプリケーションをマイクロサービスに分割すると、プロセス内の関数呼び出しからネットワーク呼び出しへと移行します。このアーキテクチャの変化により、避けられない遅延が生じます。モノリシックなアプリケーションでは、関数呼び出しはほぼ瞬時に完了します。マイクロサービスでは、サービス間のすべての呼び出しがネットワークを経由するため、数ミリ秒の遅延が加わります。
| アーキテクチャの種類 | 平均レイテンシ |
|---|---|
| プロセス内の関数呼び出し(モノリス) | 0.001 ms(1マイクロ秒) |
| 同一データセンター内での HTTP 呼び出し(マイクロサービス) | 1~5 ms(1,000~5,000マイクロ秒) |
ネットワーク呼び出しは、プロセス内の関数呼び出しと比べて桁違いに遅くなります。この差はシステムの規模が拡大するにつれて急速に積み重なります。リクエストのチェーンにサービスが追加されるたびに遅延が増え、単純な処理でもエンドユーザーにとって遅く、ストレスの多い体験になってしまいます。
リソース使用量
ネットワーク呼び出しは遅延を増やすだけではなく、貴重なシステムリソースも消費します。呼び出しのたびに CPU サイクル、メモリバッファ、ネットワーク帯域幅が使われます。マイクロサービスを増やすほど、ネットワークトラフィックは指数関数的に増加します。この追加の負荷はクラウドインフラのコスト増加と応答の遅延につながります。
サービス間の不要な呼び出しを積極的に減らすことで、パフォーマンスを改善できます。一部の先進的なチームは、遅延を抑えてレジリエンスを高めるために、インテリジェントなトラフィック管理を活用しています。
- MCG のアプローチは、サービス間の通信遅延が減ったことにより、ネットワーク遅延が増加した状況で応答時間を 15% 改善しました。
- ピーク負荷時には、MCG を組み込んだ構成が、標準的なサービスメッシュ構成と比べて優れたレジリエンスを示し、エラー率も低く抑えられました。
- パフォーマンス評価では、スマートなトラフィック配置戦略によってサイドカープロキシのオーバーヘッドが軽減され、応答時間が短縮されてスループットも安定することが示されました。
ネットワークトラフィックがシステムのパフォーマンスにどう影響するかを、継続的に監視する必要があります。小さな遅延も積み重なると、大きなボトルネックに発展しかねません。
障害ポイント
障害の伝播リスク
マイクロサービスは、システムの障害特性を根本から変えます。すべてのサービスが互いに依存しているため、1 つの障害がインフラ全体に波及することがあります。
| アーキテクチャの種類 | 障害伝播のリスク | 障害の分離 | システムのレジリエンス |
|---|---|---|---|
| モノリシック | 高 | なし | 低 |
| マイクロサービス | 低 | あり | 高 |
モノリシックなシステムでは、致命的なバグ 1 つでアプリケーションのプロセス全体が停止することがあります。マイクロサービスは障害の分離に優れており、重要度の低いサービスが故障しても、ほかのサービスは稼働を続けられます。サーキットブレーカーなどのレジリエンスパターンは、障害が全体に広がるのを防ぐのに役立ちます。
- モノリスでは、1 つのバグが全面的な停止を招き、単一障害点になる可能性があります。
- マイクロサービスでは真の意味で耐障害性を確保でき、重要度の低いコンポーネントの障害がプラットフォーム全体を沈めることを防げます。
- サーキットブレーカーなどのパターンは、障害が発生した下流の依存関係を切り離すことで、レジリエンスを高めます。
オブザーバビリティの課題
広範囲に広がるマイクロサービスのメッシュ全体でパフォーマンスの問題を検出して修正するには、包括的なオブザーバビリティが必要です。サービスが増えるほど、遅延や断続的なエラーの根本原因を突き止めることは飛躍的に難しくなります。実行中のすべてのインスタンスからログ、インフラメトリック、分散トレースを集約する必要があります。堅牢なオブザーバビリティツールがなければ、本番環境の速度低下の原因を探すために膨大な時間を失うことになります。
よくあるパフォーマンスのボトルネックは、複雑な非同期の呼び出しチェーンの中に隠れていることが多いです。分散トレーシングを活用してリクエストを境界をまたいで追跡すれば、ユーザーに影響が出る前にボトルネックを見つけられます。
次の典型的なアンチパターンに注意してください。
- God Service(責任の集中): 互いに異なる複数の業務ドメインを扱うサービスで、アーキテクチャの基本原則に反します。
- サービス間の密結合: スキーマが変更されるたびに下流のシステムが壊れる、直接的にハードコードされた依存関係です。
データベースの競合
共有データストア
複数のマイクロサービスでデータベースを共有してしまうのは、多くのチームが犯す重大なミスです。この方式はスキーマを介した強い結合を生みます。データベース構造を変更すると外部サービスが壊れる危険があるため、変更が難しくなり、開発速度と独立したスケーラビリティが損なわれます。
共有データベースの最大の問題は、スキーマによる結合を生み出すことです。どのサービスに影響を与えずに変更を安全に行えるかが分かりにくくなるため、変更のコストが大きく上がります。これはシステムのスケーラビリティにも連鎖的に影響します。複数のサービスが共有のデータストアに依存していると、サービスを個別にスケールさせることができません。サービスのスケーラビリティは最も遅い構成要素によって制限されるため、共有データベースはすぐに大きなボトルネックになります。
共有データストアは完全に廃止すべきです。マイクロサービスごとに専用のデータベースを割り当て、データレイヤーを分離してパフォーマンスを回復させましょう。
スケーラビリティの問題
データベースの競合は、エンタープライズアプリケーションにとって時限爆弾のような存在です。複数のマイクロサービスが同じデータベースエンジンを奪い合うと、深刻なパフォーマンスのボトルネックが生じます。最も遅いクエリやサービスがシステム全体の処理能力を制限し、接続プールの枯渇、レイテンシーの増加、トラフィックの急増時における壊滅的な障害につながります。
マイクロサービスアーキテクチャにおけるボトルネックの特定
監視ツール
メトリック
パフォーマンスの低下を早期に発見するには、適切な運用メトリックを追跡する必要があります。メトリックはシステムの状態をその時点で把握する手段となり、本番環境に影響が出る前に傾向を捉えるのに役立ちます。技術的なメトリックに加えて、ビジネスに関連する指標にも重点を置いてください。p99 応答時間、エラー率、リクエストスループットを追跡しましょう。
可視性
分散システムでは可視性が不可欠です。見えないものは修正できません。すべてのサービスインスタンスからテレメトリを取り込む監視ツールを導入してください。
- Prometheus、Datadog、Grafana によるリアルタイムのインフラストラクチャおよびアプリケーションの監視。
- 集中ログ集計のための Elasticsearch、Logstash、Kibana(ELK)または Graylog。
- コードレベルの呼び出しプロファイリングのための New Relic や Dynatrace などのアプリケーションパフォーマンス監視(APM)ツール。
- 基盤となるクラスターの可観測性のための Kubernetes またはコンテナオーケストレーター。
- エッジのトラフィック分析のための Kong や Zuul などの API ゲートウェイ。
分散トレーシング
リクエストフロー
分散トレーシングを使うと、マイクロサービスアーキテクチャを通過する HTTP リクエストを追跡できます。OpenTelemetry、Jaeger、Zipkin などのトレーシングツールがこれらの呼び出しを関連付け、エンドツーエンドの実行経路を表示し、正確なレイテンシーのホットスポットを明らかにします。
- 分散トレーシングにより、サービスの境界を越えた詳細な可視性が得られます。
- 隠れたボトルネックが明らかになり、デバッグ作業が大幅に速くなります。
- エンジニアリングチームはトレースを使ってレイテンシーの原因を突き止め、信頼性を向上させています。
レイテンシーの発生源
リクエストが複数のサービスを経由するたびに、レイテンシーは積み重なります。標準的なログやインフラストラクチャのメトリックだけでは、このレベルのトランザクション単位の詳細は見えません。トレーシングはネットワーク経由のたびにリクエストのコンテキストを保持するため、速度低下の原因となっている正確なメソッドやデータベースクエリを特定できます。
隠れた速度低下の発見
兆候
隠れた速度低下は、完全な停止がなくてもユーザーエクスペリエンスを損なう可能性があります。応答時間の増加、エラー率の上昇、メモリフットプリントの増大に注意してください。相関 ID を使ってシステム内のリクエストを追跡し、厳格なサービスレベル目標(SLO)に基づく事前のアラートを設定しましょう。
実際の事例
実際のエンジニアリング事例からは、事前のボトルネック検出の重要性が分かります。例えば、負荷の高い Spring Boot マイクロサービスで深刻なパフォーマンス低下が発生したケースがあります。詳細な APM とプロファイリングツールを使って、エンジニアリングチームは最適化されていないクエリループを発見しました。データベース操作をバッチ処理する特定の句を導入することで、1 秒あたりのクエリ数を 300 から 30 に削減し、CPU 使用率を即座に安定させ、ガベージコレクションの負荷も解消しました。
ヒント:メトリック、ログ、トレースは必ず一元化された可観測性パイプラインにまとめてください。この組み合わせにより、システムの状態を即座に全体像として把握できます。
マイクロサービスのパフォーマンス問題の解決策
非同期通信
メッセージングの利点
非同期通信を取り入れると、マイクロサービス アーキテクチャにおけるスケーリングの課題の多くを解決できます。メッセージキューを介してリクエストを切り離すことで、各サービスは自身のペースで処理を進められ、トラフィックが急増してもリクエストを落とすことなく安全に吸収できます。
| パフォーマンスの向上 | 説明 |
|---|---|
| スケーラビリティ | 非同期メッセージングにより大規模なスケーリングが可能になり、キューを使ってトラフィックの急増を吸収できます。 |
| 信頼性 | 非同期ブローカーはメッセージの再試行とデッドレターキューをサポートしており、ダウンタイム中でもメッセージを一切失わないようにします。 |
| テスト容易性 | 利用側のサービスはペイロードの検証用にモックキューがあれば済むため、テストが簡単になります。 |
実装
RabbitMQ、Azure Service Bus、Apache Kafka などの信頼性の高いメッセージブローカーを使って非同期通信を実装します。パブリッシュ/サブスクライブ パターンを使うと、独立したサービス間でドメインイベントをすっきりとブロードキャストできます。
バルクヘッドとサーキットブレーカー
分離戦略
バルクヘッドとサーキットブレーカーを使って、マイクロサービスを連鎖的な障害から保護します。バルクヘッドはリソースプールを分割し、ひとつのサービスの障害がシステム全体のスレッドや接続を使い果たさないようにします。
バルクヘッドは、サービスごとに個別のリソースプールやクォータを設けることで障害の影響範囲を分離するよう設計されています。局所的な障害がアプリケーション全体を停止させることを防ぎます。
障害の緩和
サーキットブレーカーはエラー率を監視し、正常に動作していない依存先へのリクエストを即座に失敗させます。これにより、ネットワーク全体に障害が連鎖することを防ぎます。
マイクロサービス アーキテクチャにおけるバルクヘッド パターンは、システムの一部で発生した障害がプラットフォーム全体をクラッシュさせることを防ぐために使われ、障害を発生源で効果的に分離します。
キャッシュとスケーリング
データストアの選択
キャッシュは高性能なマイクロサービスに欠かせないツールです。繰り返し行われるデータベースの読み取りや、コストの高いAPI計算は、RedisやMemcachedのような高速なインメモリキャッシュに任せましょう。
| 利点 | 説明 |
|---|---|
| きめ細かな制御 | 変動性と更新頻度に基づいて、ドメインの断片ごとにキャッシュできます。 |
| キャッシュ無効化の削減 | 影響を受けたデータ部分だけを更新するため、パージのオーバーヘッドを最小限に抑えられます。 |
| キャッシュヒット率の向上 | より小さく最適化されたキャッシュエントリを利用できるため、インメモリでのヒット率が高まります。 |
| 動的/静的ハイブリッド処理 | 静的なレコードをキャッシュしながら、リアルタイムの統計情報は動的に取得できます。 |
独立したスケーリング
キャッシュと分離されたデータストアにより、個々のサービスを独立してスケーリングでき、リソース競合によるボトルネックを解消できます。
- システムのスケーラビリティ向上
- 開発の俊敏性向上と市場投入の迅速化
- 堅牢な障害分離とシステムの回復力
- コスト効率の高いクラウドリソースの活用
- DevOpsとの統合強化と継続的デプロイ パイプラインの改善
依存関係の削減
疎結合化
真のマイクロサービスには、徹底的な疎結合が必要です。サービスが同期呼び出しでブロックされることなく独立して動作すれば、人為的なボトルネックを取り除けます。
疎結合化とは、各マイクロサービスが外部プロセスの同期的な完了を待たずに内部の作業を処理することを意味します。この独立性がボトルネックを避け、プラットフォームを円滑に稼働させ続けます。
依存関係を減らすことによる主なアーキテクチャ上の利点は次のとおりです。
- サービスの独立したスケーリングを、リアルタイムの負荷に基づいて行えます。
- チーム間の境界を越えて連鎖的な障害が広がるリスクを最小限に抑えられます。
- 開発チームが独自のスケジュールでコードをリリースできる自律性が得られます。
- インシデント対応時に、根本原因の切り分けを迅速に行えます。
簡素化
依存関係グラフを単純化すると認知負荷が下がり、アーキテクチャのテスト、監視、セキュリティ確保が格段に容易になります。
| アプローチ | 意味 | 重要性 |
|---|---|---|
| 個別のSLO | マイクロサービスごとに信頼性を個別に追跡する | システム全体のユーザー体験の低下を見落とす可能性がある |
| 複合SLO | 相互に依存するサービス間で信頼性の目標を組み合わせる | エンドツーエンドのシステム全体の健全性を正しく反映する |
マイクロサービス アーキテクチャの適合性を評価する
適切なアーキテクチャモデルの選択は、開発の速度と運用コストを左右します。Microsoft Development Podcastでは、このトレードオフがよく取り上げられており、過度に細分化されたマイクロサービスを、管理しやすいモジュラーモノリスに統合し直す動きが増えていることが紹介されています。
意思決定マトリックス
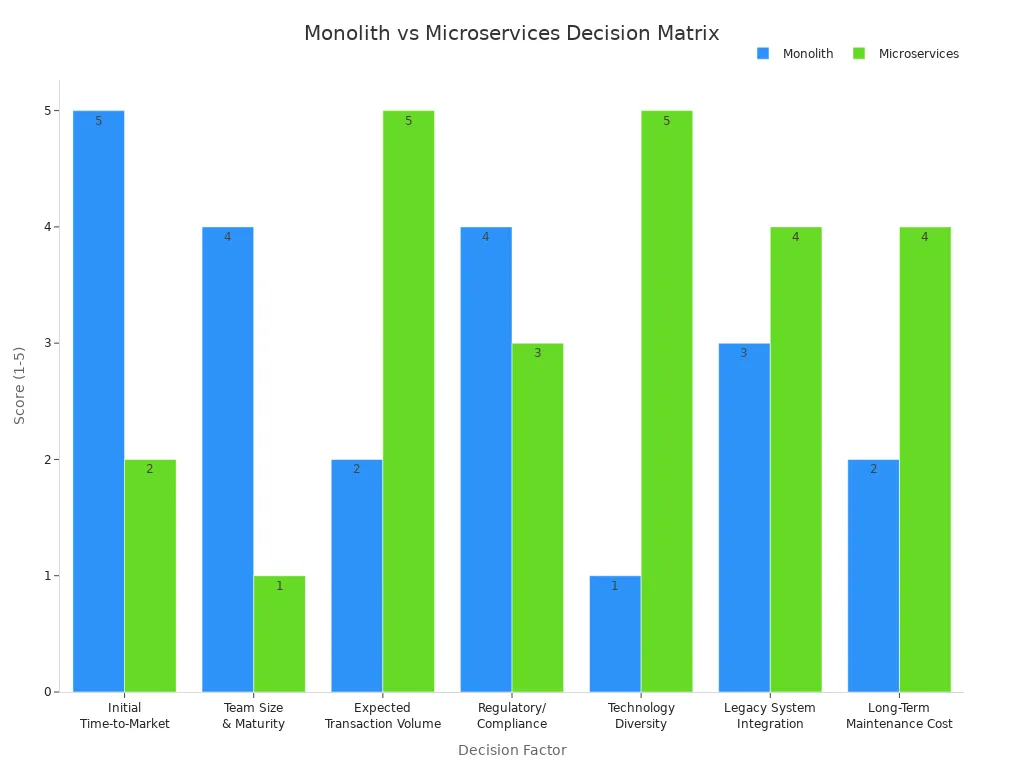
マイクロサービスが組織の成熟度に本当に適しているかを評価するには、構造化された意思決定マトリックスを使用してください:
| 判断要素 | モノリスのスコア (1~5) | マイクロサービスのスコア (1~5) | 戦略的な根拠 |
|---|---|---|---|
| 初期の市場投入までの時間(スピード) | 5 | 2 | モノリスは、初期のインフラストラクチャ設定が最小限で済みます。 |
| チームの規模と成熟度(DevOps) | 4 | 1 | マイクロサービスには、高度なCI/CD、自動化、オブザーバビリティが求められます。 |
| 想定されるトランザクション量(スケール) | 2 | 5 | マイクロサービスでは、リソースを多く消費するボトルネックを、独立して的確にスケールできます。 |
| 規制/コンプライアンスの複雑さ | 4 | 3 | 単一の成果物は、初期のセキュリティ監査やコンプライアンスチェックを簡素化します。 |
| テクノロジの多様性/実験 | 1 | 5 | マイクロサービスでは、サービスのドメインごとに専門的な技術スタックを採用できます。 |
| レガシーシステムとの統合 | 3 | 4 | マイクロサービスは、レガシーコンポーネントのラッピングと近代化に優れています。 |
| 長期的な保守コスト(TCO) | 2 | 4 | マイクロサービスは時間の経過とともに機能あたりのコストを下げられますが、その代わりに運用上のオーバーヘッドが増えます。 |
主な評価の質問
- エンジニアリングチームは、堅牢なDevOps、プラットフォームエンジニアリング、SREのスキルを備えていますか?
- 分散によるオーバーヘッドを正当化するほどの極端なスケール要件がありますか?
- ポリグロット永続化と技術の多様性が必要ですか?
- 組織の文化は、チーム間の密接な調整コストに対応できる状態ですか?
再検討すべき兆候
マイクロサービス・アーキテクチャの再構成が必要になるサインとして、次のような兆候に注意してください。
- チーム間の絶え間ない依存関係により、デリバリーの速度が停滞しています。
- クラウドの運用費用が、ビジネスの収益成長を上回っています。
- 障害が複数のドメインに容易に連鎖します。
モノリス対マイクロサービス
| アーキテクチャの種類 | チーム規模の推奨 | 主な特徴 |
|---|---|---|
| モノリシック | 8~10人未満の開発者 | シンプルなデプロイ、運用上のオーバーヘッドが小さい |
| マイクロサービス | 10~15人超の開発者 | チームの独立した自律性、複雑な分散型の調整 |
マイクロサービスアーキテクチャを実装する際には、見えにくい複雑さとパフォーマンス上のリスクに直面します。ボトルネックは、予想外のネットワーク層やデータ層に必ず現れます。Microsoft Development Podcastでは、迅速なデリバリーには厳格なアーキテクチャの規律が不可欠であると強調されています。.NETシステムを健全に保つために、次の点を心がけてください:
- サービス間のリクエストとタイムアウトポリシーを慎重に管理してください。
- 弾力性のある負荷分散と自動スケーリングを実装してください。
- データストアを分離し、各サービスが自身のデータベースを所有するようにしてください。
- 繰り返し発生するAPIおよびデータベースクエリは、積極的にキャッシュしてください。
さらに、アーキテクチャのガバナンスを徹底し、堅牢なAPIゲートウェイを活用して、定期的にアーキテクチャレビューを実施してください。継続的な評価により、技術スタックがビジネスとともに効果的にスケールできるようになります。
よくある質問
分散モノリスとは何ですか?
分散モノリスとは、アプリケーションが物理的には複数のマイクロサービスに分割されているものの、同期HTTP呼び出し、共有データベース、密結合したデプロイ依存関係によって論理的には結合したままになっているアンチパターンです。その結果、マイクロサービスの本来の利点が失われます。
マイクロサービスのパフォーマンスボトルネックは、どのように見つけますか?
p99応答時間、エラー率、リクエストスループットを監視してください。分散トレーシングツールを活用して、サービス境界をまたぐリクエストを追跡し、遅いネットワークホップやデータベースクエリを特定します。
マイクロサービスアーキテクチャにおいて、ネットワークレイテンシが重要なのはなぜですか?
ネットワークレイテンシは、サービス間のすべての呼び出しに数ミリ秒の遅延を加えます。モノリス内での即時のインプロセスメモリ呼び出しとは異なり、分散ネットワークのホップは急速に累積し、アプリケーション全体の応答性を低下させます。
チーム間の調整オーバーヘッドを減らすには、どうすればよいですか?
明確なドメインの所有境界を定義し、API ガバナンスのチェックを自動化し、不要なステータス会議を減らし、非同期コミュニケーションを取り入れることで、チームが自律的に動けるようにします。
.NET マイクロサービスのオブザーバビリティに役立つツールにはどのようなものがありますか?
代表的なオブザーバビリティ ツールには、Prometheus、Grafana、OpenTelemetry、Jaeger、Zipkin、そして ELK スタックのような集中ログ基盤があります。これらを組み合わせることで、メトリック、ログ、分散トレースをまとめて収集できます。
マイクロサービスの統合を検討すべきなのはどのようなときですか?
機能のデリバリー速度が低下したとき、クラウド インフラストラクチャのコストが制御できないほど膨らんだとき、または連鎖的な障害が頻繁に起きて稼働時間を維持できなくなったときは、統合を検討してください。
マイクロサービスで共有データを扱う最善の方法は何ですか?
各マイクロサービスに専用のプライベート データベースを持たせてください。サービス間でデータベースを共有しないことで、スキーマの結合を断ち切り、データベースを独立してスケールできるようになります。
非同期通信は、マイクロサービスのパフォーマンスをどのように向上させますか?
メッセージ ブローカーを使った非同期通信では、各サービスが自分のペースでイベントを処理できます。トラフィックのスパイクをバッファリングし、同期処理によるブロッキングのボトルネックを取り除けます。
🎧 このエピソードを聴く
Why Microservice Architecture Slows Software Delivery について、実践的で掘り下げた解説をお探しですか?このエピソードでは、重要なアーキテクチャのテーマを分かりやすく解説し、Microsoft 365、Azure、Power Platform、エンタープライズ セキュリティ、AI、そして現代のソフトウェア エンジニアリングにとってなぜ重要なのかを示します。
次のような方は、このエピソードをお聴きください:
- マイクロサービスがソフトウェアのデリバリーを遅らせる理由の根底にある中核的な概念を理解したい方
- アーキテクチャが Microsoft の技術エコシステム全体のなかでどこに位置づけられるかを知りたい方
- エンタープライズ組織において、実践的で測定可能な価値をどこで生み出せるかを学びたい方
あわせて楽しんでいただける関連する M365 FM のエピソード:
- モノレポの神話: なぜアーキテクチャが分断されるのか
- Microsoft Graph の自動化アーキテクチャ: スクリプトの先へ
- Graph を活用した AI エージェント: エンタープライズ向けアーキテクチャガイド
- Miguel Castro [MVP] と学ぶ .NET の拡張性とクリーンアーキテクチャ
- エンタープライズ AI エージェントファブリック: チャットボットを超えるアーキテクチャ
M365 FM で、Microsoft のエンジニアリングに関する実践的な会話をさらにご覧いただけます。