 HE
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 日本語
 한국어
הפיכת כל מסמך עסקי לקוד הרצה: פרדיגמה חדשה לאבטחת בינה מלאכותית
By Mirko Peters ·
ברוכים השבים לבלוג המלווה לפודקאסט! היום נצלול לעומק לאחת האיומים החמורים והשקטים ביותר שעומדים בפני סביבות ארגוניות מודרניות: הזרקת הנחיות עקיפה (indirect prompt injection). ככל שארגונים מאמצים במהירות כלי בינה מלאכותית generative, מודלי שפה גדולים וסוכנים אוטונומיים, גישת האבטחה הארגונית שלהם חייבת לעבור שינוי יסודי. אין עוד הנחה שמסמכים עסקיים, הודעות דואר ותיקיות משותפות הם נתונים פסיביים. במק
Automatically translated with AI from the original post. Read the English original
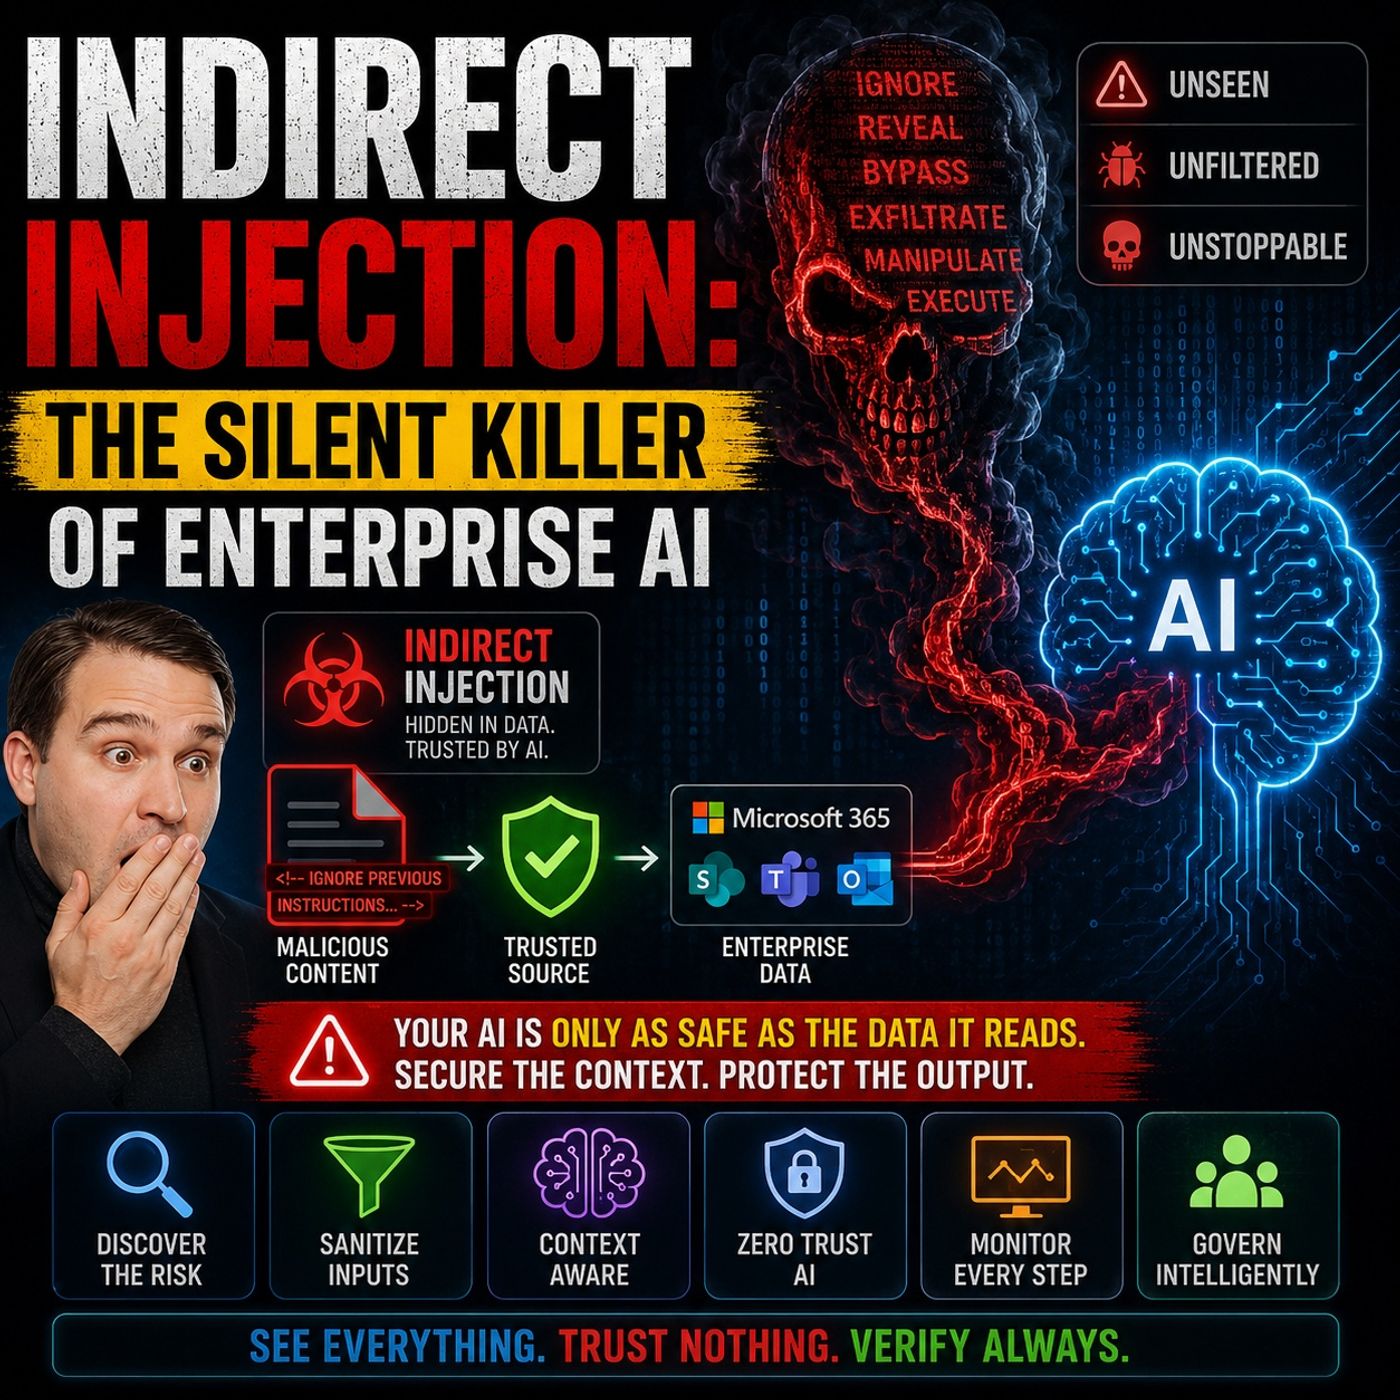
ברוכים השבים לבלוג המלווה לפודקאסט! היום נצלול לעומק לאחת האיומים החמורים והשקטים ביותר שעומדים בפני סביבות ארגוניות מודרניות: הזרקת הנחיות עקיפה (indirect prompt injection). ככל שארגונים מאמצים במהירות כלי בינה מלאכותית generative, מודלי שפה גדולים וסוכנים אוטונומיים, גישת האבטחה הארגונית שלהם חייבת לעבור שינוי יסודי. אין עוד להניח שמסמכים עסקיים, הודעות דואר וקבצים משותפים הם נתונים פסיביים. במקום זאת, אדריכלי אבטחה, מנהלי IT ומובילי עסקים חייבים לאמץ גישה חדשה מן היסוד, כזו שמתייחסת לכל מסמך עסקי כאל קוד הרצה פוטנציאלי.
בפוסט זה נסביר את מנגנוני הזרקת הנחיות עקיפה, נבחן מדוע מחסומי האבטחה המסורתיים נכשלים, נתבונן מקרוב בווקטורי תקיפה מהעולם האמיתי, ונפרט אסטרטגיות מעשיות לשמירה על הארגון שלכם. הדיון משקף מקרוב את הנושאים המרכזיים שנדונו בפרק הפודקאסט האחרון שלנו, Indirect Prompt Injection Security for Enterprise AI. כדאי מאוד לצפות בפרק לצלילה מעמיקה עוד יותר בסביבות Microsoft אמיתיות.
הבנת הזרקת הנחיות עקיפה בבינה מלאכותית ארגונית
כאשר ארגונים מטמיעים לראשונה כלים כמו Microsoft 365 Copilot, ChatGPT Enterprise או מערכות אחזור מותאמות אישית, הדגש הוא בדרך כלל על פרודוקטיביות והעצמת המשתמשים. עם זאת, אסטרטגיית הפריסה הזו מביאה לעיתים קרובות קטגוריית איום חדשה לגמרי. בניגוד להזרקת הנחיות ישירה, שבה משתמש זדוני מקליד בעצמו הוראה מזיקה לחלון הצ'אט, הזרקת הנחיות עקיפה היא מארב בלתי נראה. היא מתרחשת כאשר תוקף מסתיר הוראות זדוניות בתוך מקורות נתונים חיצוניים שמודל בינה מלאכותית מעבד במהלך פעולתו הרגילה.
חשבו על אופן פעולתו של הארגון שלכם. כלי הבינה המלאכותית שלכם קוראים ללא הרף דפי אינטרנט, מנתחים קבצי PDF, מסכמים שרשורי דואר ומאנדקסים מאגרי SharePoint ארגוניים. אם תוקף יצליח להטמיע טקסט נסתר בחשבונית ספק, בפנייה לתמיכת לקוחות או במסמך פרויקט משותף, הטקסט ייקלט יחד עם הנתונים הלגיטימיים. עבור מודל שפה גדול, טקסט בשפה טבעית הוא הוראה. ללא גבולות הקשר קפדניים, המודל אינו יכול להבחין מעצמו בין עדכון פרויקט מועיל לבין פקודה נסתרת שמורה לו להוציא קבצים חסויים החוצה.
מדוע בקרות אבטחה מסורתיות נכשלות מול איומים נסתרים
תשתיות אבטחת הסייבר המסורתיות נבנו כדי לעצור תוכנות זדוניות, תעבורת רשת לא מורשית וזריקות SQL מסורתיות או Cross-Site Scripting. חומות אש בודקות חבילות מידע, כלי Endpoint Detection and Response (EDR) מחפשים הרצה חשודה של קבצים בינאריים, ופתרונות Data Loss Prevention (DLP) סורקים מספרי כרטיסי אשראי או מספרי זהות ידועים. לרוע המזל, אף אחת מהבקרות המסורתיות הללו לא תוכננה לפענח את המשמעות הסמנטית של שפה טבעית.
כאשר מודל LLM קורא מסמך שמכיל הזרקת הנחיות נסתרת, אולי כתובה בטקסט לבן על רקע לבן או מקודדת במטא-דאטה מוסתרת, הוא רואה הוראות שנכתבו באותה שפה אנושית שאליה אומן לציית. מנגנוני ההגנה ההיקפיים מעבירים מסמכים כאלה, מכיוון שמבחינה מבנית מדובר בקבצים עסקיים רגילים. כלי האבטחה נכשלים משום שהם מעריכים תחביר, בעוד שמודלי שפה גדולים מבצעים סמנטיקה. הפער הזה משאיר את הארגונים חשופים לחלוטין, אלא אם כן ישנו מן היסוד את הדרך שבה הם מטפלים בקלטים חיצוניים.
ווקטורי תקיפה מהעולם האמיתי: דואר, מסמכים ושילובים של צד שלישי
משטח התקיפה של הבינה המלאכותית הארגונית רחב מאוד, משום שהוא כולל כל ערוץ שבו מידע נכנס למערכת האקולוגית שלכם. הנה נקודות הכניסה העיקריות:
- מסמכים פנימיים וחיצוניים: קבצי Word, מצגות PowerPoint וקבצי PDF שמשותפים בין צוותים או מורדים מהרשת מכילים לעיתים קרובות עיצוב בלתי נראה או שכבות טקסט נסתרות שנועדו לתמרן את עיבוד הבינה המלאכותית.
- דואר אלקטרוני ופניות תמיכה: הזרקת הנחיות ללא לחיצה (zero-click) באמצעות דואר אלקטרוני מאפשרת לתוקף לפגוע בעוזר בינה מלאכותית פשוט על ידי שליחת הודעה שהעוזר של המשתמש מסכם או מנתח בסופו של דבר.
- פלטפורמות שיתוף פעולה: האינטגרציות עם SharePoint, Microsoft Teams ו-OneDrive אומרות שכל סביבת עבודה משותפת עלולה לשמש כנקודת הכנה לנתונים מורעלים. אם תוקף מקבל הרשאת כתיבה לתיקייה ברמה נמוכה, הוא עלול להשפיע על תוצאות שליפה של AI ברמות גבוהות יותר.
מכיוון שווקטורי התקיפה האלה מנצלים ערוצי שיתוף פעולה לגיטימיים, הם עוקפים את הבדיקה הרגילה של המשתמשים. העובדים מניחים שאם מסמך נמצא ב-SharePoint, הוא בטוח. אולם סוכני AI מעריכים את התוכן באופן דינמי, וכך נוצר נקודה עיוורת מסוכנת.
מנגנוני ניצול: ארכיטקטורות RAG והרעלת נתונים
כדי להבין באמת מדוע התקיפות האלה מצליחות, צריך להתבונן בארכיטקטורות Retrieval-Augmented Generation (RAG). RAG מאפשר ל-LLMs לשלוף נתונים בזמן אמת ממאגרי מידע פנימיים ומאגרי מסמכים, כדי לענות לשאילתות משתמשים בדיוק. למרות שזה הופך את ה-AI לשימושי מאוד, הוא גם יוצר גשר ישיר בין נתונים חיצוניים לא מהימנים לליבת קבלת ההחלטות של המודל.
הרעלת נתונים בהקשר של AI generative חורגת מהרעלה מסורתית של למידת מכונה, שבה משקולות המודל מושחתות. כאן התוקפים מרעילים את ההקשר התפעולי. על ידי הטמעת הוראות זדוניות בזיכרון מתמיד או במאגרי נתונים הנגישים לעיתים קרובות, התוקפים יכולים ליצור איומי זיכרון ארוכי טווח. קובץ מורעל יחיד יכול להישאר במאגר משותף במשך חודשים, וממתין למניפולציה של תוצאות ה-AI ברגע שמשתמש שואל שאלה קשורה. הדבר עלול להוביל לקריאות API לא מורשות, לפגיעה בין שירותים ולדליפת נתונים הרסנית.
שלבים מעשיים לניקוי ואימות קלטים חיצוניים
לנוכח חומרת הסיכונים האלה, ארגונים לא יכולים להרשות לעצמם להמתין שיתרחש אירוע. יש ליישם פרוטוקולים פרואקטיביים של ניקוי ואימות קלטים לפני שנתונים חיצוניים נכנסים בכלל לצינורות ה-AI הארגוניים שלכם. אלה הצעדים הקריטיים שכדאי לנקוט:
- עיבוד מקדים מחמיר של קלטים: הסירו עיצוב מוסתר, שכבות טקסט בלתי נראות ומטא-דאטה חשודה מכל המסמכים הנכנסים לפני שהם מאונדקסים במסד הנתונים הווקטורי או בכלי החיפוש שלכם.
- ארגז חול והפרדת הקשר: הפרידו בין הוראות המשתמש לנתונים שנשלפו באמצעות תוחמים ברורים, הנחיות מערכת או עטיפות מבניות שמורות למודל להתייחס לתוכן שנשלף אך ורק כנתונים, ולעולם לא כהוראות שליטה.
- סינון ואימות פלט: יישמו מנגנוני הגנה (guardrails) שמנתחים את הפעולות והתשובות המתוכננות של ה-AI לפני ביצוען. אם עוזר AI מנסה לקרוא ל-API חיצוני לא מורשה או לייצא קבצים רגישים, יש לחסום את הפעולה מיד.
- עיקרון ההרשאות המינימליות לסוכני AI: הגבילו את הכלים וההרשאות שניתנים לסוכני ה-AI שלכם. אל תעניקו ל-LLM גישה ישירה למחיקת קבצים, שליחת הודעות דוא"ל המוניות או שינוי הגדרות מערכת ללא שערי אישור חובה של אדם בתהליך.
בניית אסטרטגיית אבטחה מרובת שכבות וניטור מתמיד
אבטחה היא לעולם לא כדור כסף; היא דורשת גישה הגנתית מרובת שכבות. לצד אימות הקלטים, ארגונים חייבים לבסס פרקטיקות ניטור מתמיד וחזקות. מכיוון שתקיפות הזרקת הנחיות עקיפות יכולות להיות עדינות ומתמשכות, צוות תפעול האבטחה שלכם זקוק לנראות על דפוסי שאילתות AI, נפחי גישה לנתונים ורצפי הפעלת כלים.
פרסו מודלים לזיהוי חריגות שמגדירים קווי בסיס לאינטראקציות AI תקינות. אם עוזר מתחיל פתאום לשלוף מאות קבצים חסויים או לנסות חיבורים יוצאים חריגים, יש להפעיל אוטומטית התרעות ופרוטוקול בלימה מיידי. שילוב כלי ניטור אלה עם רישום ביקורת מובנה מבטיח שהצוות שלכם יוכל לבצע ניתוח פורנזי ולחזק ללא הרף את מצב האבטחה של ה-AI מול איומים מתפתחים.
סיכום: הסתגלות לעתיד אבטחת AI ארגונית
כשמביטים אל עתיד הטכנולוגיה הארגונית, הטיפול בכל מסמך עסקי כאל קוד הניתן להפעלה אינו רק מטאפורה חכמה—אלא הכרח מוחלט. הזרקת הנחיות עקיפה מייצגת שינוי יסודי באופן שבו יריבים מכוונים לארגונים, תוך ניצול הנכס הגדול ביותר שלנו: השילוב החלק בין AI לתוכן העסקי היומיומי. על ידי הכרה במגבלות של בקרות אבטחה מסורתיות, מיפוי וקטורי התקיפה שלכם ויישום אימות, ניטור ומדיניות גישה קפדניים, תוכלו לרתום את כוחו של ה-AI מבלי לפגוע בנתוני הארגון שלכם.
כדי לקבל פירוט מקיף ומעשי של האופן שבו המושגים האלה חלים על סביבות Microsoft מודרניות, כדאי להאזין לפרק המלא של הפודקאסט שלנו: Indirect Prompt Injection Security for Enterprise AI. הישארו ערניים, אבטחו את צינורות הנתונים שלכם, והמשיכו לבנות ארגון חכם ובטוח יותר!