 JA
 English
 Deutsch
 Español
 Français
 Italiano
 Português
 Nederlands
 Polski
 Bahasa Indonesia
 Русский
 Українська
 العربية
 עברית
 한국어
Microsoft Fabric のレイクハウスでデータを統制する:安心して運用できるアーキテクチャ
By Mirko Peters · · Updated
Microsoft Fabric のレイクハウスアーキテクチャにおけるデータガバナンスを、安心して運用できる方法を解説します。堅実で管理しやすいソリューションで分析をシンプルにします。
Automatically translated with AI from the original post. Read the English original
会議で誰かに「この数字はどこから来たの? 根拠を示せますか?」と聞かれ、部屋が静まり返る。あの気まずい瞬間に心当たりはありませんか? 「データなら全部ある」と言いながら、根拠を示せない企業で、私は何度もその沈黙が長引くのを見てきました。レイクハウスは、構造化テーブル、雑多なファイル、リアルタイムのフィード、ML 用の特徴量といったあらゆるものを一つのプラットフォームで扱えると約束します。しかし、その約束が成り立つのは、チームを縛りすぎずにガバナンスを効かせられる場合だけです。この記事では、2024 年 10 月に発表された Stallion Journal の「Data Governance in Lakehouse」に関する研究(Shah & Jain)を大いに参考にしつつ、現場の視点も加えます。つい取りたくなる近道、ぶつかりがちな社内の政治的な問題、そして監査前にあわてないための単純な習慣を紹介します。
Microsoft Fabric のレイクハウスにおけるガバナンスについて知っておきたい 8 つの意外な事実- 成果物をまたぐ統合ガバナンス: Fabric のガバナンスは、レイクハウスのテーブル、ファイル、ノートブック、パイプライン、ダッシュボードに一律で適用されます。そのため、データと分析の成果物の両方にまたがる一元的なポリシーを設定できます。
- 自動的なデータ系列の取得: 取り込み、変換、ノートブック、ダッシュボードなど、多くの操作でデータ系列が自動的に記録されます。追加の計測作業なしで、データの出所をほぼリアルタイムに把握できます。
- 行レベルおよび列レベルのセキュリティとの統合: レイクハウスは、クエリ実行時に適用される行レベルと列レベルのきめ細かなアクセス制御に対応しています。そのため、どの分析エンジンから利用されても、統制されたアクセス権はデータとともに維持されます。
- 組み込みのデータ分類と秘密度ラベル: Fabric はデータ分類(機密情報の種類)を表示し、Microsoft Purview の秘密度ラベルと統合されています。これにより、ガバナンスで検出された分類を使ってポリシーを適用できます。
- ライフサイクル制御のためのポリシーのコード化: 保持、品質ゲート、暗号化、利用可能なコンピューティングなどのガバナンスポリシーを、プログラムで定義して適用できます。これにより、レイクハウスのライフサイクル全体で自動的な実施が可能になります。
- テナントとワークスペースの分離を円滑に: Fabric のガバナンスモデルは、複数ワークスペースの分離とテナントを意識したポリシーに対応しています。そのため、統制された共同作業を可能にしつつ、プロジェクト間の共有やデータ移動を制限できます。
- 監査可能な変更およびアクセスのログ: ガバナンスに関わるすべての操作(データの読み取りと書き込み、ポリシーの変更、ロールの割り当て)は監査可能です。生成されるログは Microsoft Sentinel や SIEM と統合でき、コンプライアンスの監視に活用できます。
- ガバナンスに対応したデータコントラクト: Fabric では、互換性チェックを強制するデータコントラクトとスキーマを作成できます。そのため、利用者はレイクハウスのデータに対して安定した統制済みのインターフェースを得られ、データを提供する側も安全に変更を加えられます。
1) 「静まり返る会議」問題:レイクハウスにガバナンスが必要な理由
経営層のレビューで、画面に KPI が表示されます。収益維持率、患者の待ち時間、解約リスクなどです。誰かが「この数字はどこから来たの?」と尋ねると、部屋は静まり返ります。データセット、変換処理、先週ロジックを変更した人物を追跡できないのです。この瞬間、直面しているのは分析の問題ではなく、データへの信頼の問題です。
平易に言えば、レイクハウスとは:一つの屋根の下で、二つの約束
レイクハウスは、実用的な両取りのアーキテクチャです。データレイクの柔軟性(何でも素早く保存できる)と、データウェアハウスの信頼性(一貫したテーブルと高いパフォーマンス)を兼ね備えています。一つの屋根の下で、構造化データと非構造化データを管理し、リアルタイム分析や機械学習のワークロードを実行できます。この「オールインワン」の価値こそが、レイクハウスのアーキテクチャ戦略に初日からガバナンスを組み込むべき理由です。
レイクハウスでデータガバナンスの必要性が高まる理由
レイクハウスは動きが速く、ストリーミングのフィード、頻繁なモデルの再トレーニング、多数のチームによる同時のダッシュボード公開が行われます。この速さがリスクを増幅させます。データの型が混在し、多くのツールが使われるため、定義、アクセス許可、データ系列を見失いやすくなります。指標を説明できなければ、数値が正しくても、関係者はダッシュボードを信頼しなくなります。
- リアルタイムデータは、一貫性のないスナップショットや「動き続ける」KPI が生じる可能性を高めます。
- ML パイプラインは、統制すべき新たな資産を増やします。特徴量、学習用データセット、モデルの出力、ドリフトのシグナルがそれにあたります。
- 利用者が増える(アナリスト、データサイエンティスト、プロダクトチームなど)ことは、アクセス経路が増えることを意味し、ポリシーを破る機会も増えます。
ガバナンスは書類作業ではなく、安全に提供を続けるための仕組みです
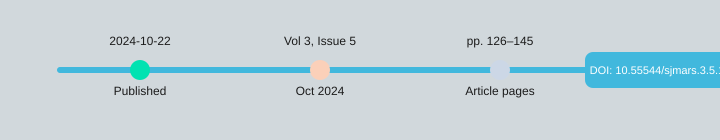
Stallion Journal に掲載された査読付きの研究「Data Governance in Lakehouse」(Samarth Shah、University at Albany、Shubham Jain、IIT Bombay)は、2024年10月22日にVolume 3, Issue 5(ページ 126–145、ISSN 2583-3340、DOI: https://doi.org/10.55544/sjmars.3.5.12)で発表されました。この研究はガバナンスを、戦略上の必要性であり、運用上も欠かせないものとして位置づけています。主旨は明快です。ガバナンスは、コンプライアンス(GDPR、HIPAA、CCPA)を守り、リスクを減らし、データ品質とステークホルダーの信頼を維持するという役割を果たします。
Samarth Shah: 「レイクハウスでは、ガバナンスのないスピードは俊敏性ではなく、より速い混乱にすぎません。」
実際には、レイクハウスのデータガバナンスとは、「このKPIは何か?」という問いに、根拠をもって答えられることを意味します。根拠とは、メタデータ、カタログのエントリ、アクセス制御(RBACなど)、監査証跡、そしてリネージです。これは形式的な手続きではありません。法令を破ることなく、信頼を損なうことなく、分析を素早く提供できるようにする仕組みです。
| メタデータ項目 | 値 |
|---|---|
| 発行日 | 22-10-2024 |
| 号 | Volume 3, Issue 5(2024年10月) |
| ページ | 126–145 |
| ISSN | 2583-3340 |
2) データがあらゆる場所に散在するとき、「良いガバナンス」とはどのような姿か
レイクハウスでは、データは「一か所」にあるわけではありません。テーブル、ファイル、ストリーム、MLフィーチャーにまたがり、多くはAWS、Snowflake、Databricksなどのプラットフォーム上にあります。良いガバナンスとは、チームの速度を落とさずに、データを使いやすく安全に保つことです。ゲートではなくガードレールと考えてください。そうすることで、GDPR、HIPAA、CCPAの要件を満たしながら、リアルタイム分析を実現できます。
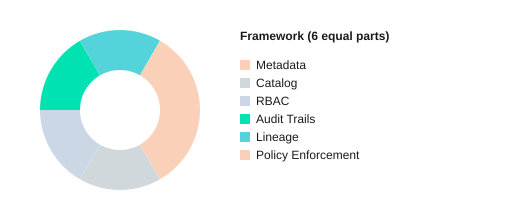
実際に実装する6つの構成要素
- メタデータ駆動型ガバナンス:所有者、秘密度、保持期間、品質ルールをメタデータとして定義します。そうすることで、データ量や変化に合わせて統制を拡張できます。
- データカタログのベストプラクティス:定義、タグ、信頼できるデータセットを検索できる一か所にまとめます。これにより、人が推測に頼らなくなります。
- RBACによるアクセス制御:ロールを業務上の役割(アナリスト、エンジニア、臨床医)に対応させ、場当たり的なアクセス許可を避けます。
- データリネージの追跡:データの出所、変化の過程、そして何に利用されているかを可視化します。
- 監査証跡:誰が、いつ、何にアクセスし、何をしたかを記録します。調査や監査では欠かせません。
- ポリシーの適用:マスキング、保持、承認などの自動チェックを、リクエストに応じてではなく、既定で常に実行します。
文書化されたガバナンスと強制されるガバナンス(インシデントを防げるのは後者だけです)
文書化されたガバナンスとは、「PIIはマスクすること」と書かれたwikiページです。強制されるガバナンスとは、レイクハウスがメタデータのタグに基づいて自動的にPIIをマスクし、リスクの高いエクスポートをブロックし、アクセスを監査証跡に記録する状態です。最新のレイクハウスガバナンスを支える研究では、プラットフォームがルールを一貫して適用するため、自動化とメタデータによって手作業による適用時間とミスが減ることが示されています。
テーブル、ファイル、ストリーム、フィーチャーを同時に扱うときの統合ガバナンス
必要なのは、バッチテーブル、オブジェクトストアのファイル、Kafkaのようなストリーム、MLフィーチャーセットをまたいで機能する、一つの統制の基盤です。ガバナンスが統合されていれば、同じRBACによるアクセス制御、タグ、ポリシーがデータに追随します。その結果、ダッシュボード、ノートブック、モデルの整合性とコンプライアンスが保たれます。
余談:「共有データセット」が12のバージョンになる仕組み
データリネージの追跡がないと、「customer」データセットは customer_v2、customer_clean、customer_final、そして「final_final」へとコピーされていきます。やがて、どのバージョンがどのレポートに使われたのかを誰も証明できなくなり、チーム同士が数字をめぐって議論するようになります。
Shubham Jain: 「数字に異議を唱えられたとき、リネージは『そう思う』と『証明できる』の違いを生みます。」
5分でできるセルフチェックリスト
- 主要な10個のデータセットについて、カタログで所有者と秘密度タグを見つけられますか?
- アクセスは個人ではなくロールによってRBACで制御されていますか?
- リネージを使って、2分以内にKPIを元のソースまでたどれますか?
- 監査証跡で、「このデータを誰が閲覧またはエクスポートしたか」にいま答えられますか?
- ポリシー(マスキング、保持、承認)は、手動ではなく自動的に適用されていますか?
それぞれの統制は成果に結びつきます。アクセス関連のインシデントの減少(RBAC+ポリシー)、監査の迅速化(監査証跡+カタログ)、分析の品質向上(メタデータ+リネージ)です。
3) ガバナンスを「オーバーヘッド」に感じさせなくする数字
ガバナンスが「余計な手続き」に感じられるときは、この論文の結果を、測定可能な運用上の効果として捉え直すと役立ちます。レイクハウスで自動化と機械学習を組み合わせてメタデータ駆動型ガバナンスを適用すると、単に「統制を増やす」のではなく、時間を取り戻し、データへの信頼を高め、コンプライアンスリスクを減らせます。これらはCFOが追跡できる形の成果です。
メタデータ駆動型ガバナンス:スライドに載せられるROI
この研究では、チームがメタデータ、カタログ化、リネージ、アクセス制御を強化した場合に、次の3つの主要な成果が報告されています。
- ガバナンス効率が最大40%向上
- データ品質が35%向上
- 92%のGDPR・HIPAA準拠の達成率(GDPR/HIPAA)
実務的に言えば、この40%の効率化は、手作業によるレビューの削減、「このデータセットは誰の管理なのか」という確認のやり取りの減少、アクセス許可や共有の承認の迅速化につながることが多いです。日常的なチェックが人からシステムに移るため、バックログが縮小し、本番環境に到達する問題が減るため、インシデントの件数も下がります。
自動化されたポリシーの適用:議論の前提を変える前後比較
「負荷と効果」を最も明確に示すのは、手動による統制から自動化されたポリシーの適用への移行です。
- ポリシー適用にかかる時間:72% → 28%
- エラー率:45% → 15%
これは小さな最適化ではありません。ガバナンスが「関門」であるか「ガードレール」であるかの違いです。例外への対応に費やす時間が減り、安全なセルフサービスを可能にする時間が増えます。
「統合ガバナンスが定着するのは、回避策よりもワークフローの方が楽なときだけである。」—Taylor, Singh, & Green(2021)
導入の実態:技術者には定着しやすいが、それ以外の人には難しい
ユーザビリティのスコアは、データサイエンティスト、ビジネスアナリスト、IT管理者の間で高い値を示しました(4.2~4.7/5)。一方で、この論文は一般的な課題も指摘しています。技術者ではないユーザーには、よりシンプルなインターフェース、明確な定義、ガイド付きのワークフローが必要だということです。上記の数値を得たいのであれば、ツールだけでなく、教育や定着支援の予算を確保する必要があります。
主要指標の一覧
| 指標 | 結果 |
|---|---|
| ガバナンス効率の向上 | 最大40% |
| データ品質の向上 | 35% |
| GDPR・HIPAA準拠率 | 92% |
| ポリシー適用にかかる時間 | 72%(手動)対 28%(自動) |
| エラー率 | 45%(手動)対 15%(自動) |
| ユーザビリティ評価 | 5点満点中 4.2~4.7 |
| 処理時間の短縮 | 25% |
4) ツール、プロトタイプ、そして実装の厄介な現実
研究で行われたこと(平易に言えば)
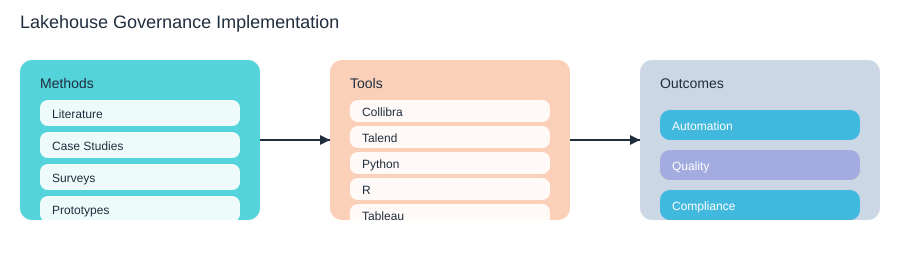
Stallion Journalの研究は、ガバナンスをスライドの問題として扱ったわけではありません。実務で見覚えのある4つの手法を用いています。すなわち、文献を読み(システマティックレビュー)、業界の事例研究を調べ、関係者にアンケートを行い、そしてプロトタイプを検証しました。最後の工程が重要です。レイクハウスのガバナンスは、ポリシーとパイプラインの隙間で破綻することが多く、特にデータの到着が速く、頻繁に変化し、多くのチームから発生する場合にはなおさらだからです。
プロトタイプの構成:実際に試したこと
実験では、ガバナンスと統合のパターンにCollibraとTalendを使用し、ユーザビリティと成果を検証するために分析ツール(Python、R、Tableau)を用いました。Databricksのガバナンス、Snowflakeのレイクハウス構成、あるいはKubernetes、Docker、Kafka、Postgres、PySpark、Elasticsearchを含む、より広範なクラウドネイティブなデータガバナンスを行う場合でも、このアプローチを参考にできます。
無理なく真似できる導入ステップ
導入の成功は、ツールによるガバナンスに加えて、スピード、複雑さ、リソースの制約に対応できる能力に左右されます。実践的な進め方は次のとおりです。
- カタログとRBACから始める:データカタログのベストプラクティス(明確なオーナーシップ、ビジネス用語、「ゴールデン」データセット)を採用します。そのうえで、RBACを使ってアクセスを対応付けます。
- リネージを追加する:上流・下流への影響を把握し、変更がアナリストや監査人を驚かせないようにします。
- 適用を自動化する:可能な範囲で手動承認からポリシー・アズ・コードへ移行し、監査証跡を残します。
Harris & Nguyen(2020):「RBACは紙の上では単純だが、役職ではなくチームに割り当てたその日から現実のものになる。」
日常的な敵:速度と一貫性のないデータストリーム
高速なフィード(Kafka型のストリームなど)では、「スキーマドリフト」、遅延イベント、重複レコードが発生します。ガバナンスが混乱しやすいのはここです。カタログでは項目が必須と定義されているのに、ストリームではその項目が欠落します。品質ルールでは1つのタイムスタンプを想定しているのに、プロデューサーは3つ送ってきます。この調査では、特にチームの人員が不足している場合に、これが繰り返し発生する障害として指摘されています。
ツールの乱立:システム間で食い違うとき
典型的な「スプリットブレイン」問題に注意してください。カタログではデータセットAが「制限付き」と表示されていても、IAMグループでは広範囲なアクセスが許可されたままになっていることがあります。あるいは、Databricks governanceのポリシーが、クラウドのIAMで設定された内容と一致していないこともあります。「単一の信頼できる情報源」はスローガンではなく、設計目標として扱ってください。
| 判断の観点 | シンプルに保つ |
|---|---|
| 購入か構築か | カタログとワークフローは購入し、構築するのは薄いコネクタとチェックだけにしましょう。 |
| ガバナンスの迷路を避ける | カタログは1つ、ポリシーモデルも1つ、カスタムロールは最小限にし、監査は自動化しましょう。 |
5) ガバナンスにおける主な課題と、その優先順位付け
ガバナンスが「本来あるべき」以上に難しいと感じるなら、それはあなただけではありません。調査のまとめによると、組織の78%が主要な課題としてメタデータ管理の難しさを挙げています。この数字に共感する方も多いのではないでしょうか。レイクハウスではすべてが速く動きます。メタデータは、道路がまだ建設中のなかで地図を更新しようとするようなものです。
なぜメタデータが最初に破綻し、そして壊れ続けるのか
メタデータが難しい理由は次のとおりです。
- 定義のずれ:「アクティブな顧客」は、財務部門とグロース部門では意味が異なります。
- 責任の所在が曖昧:新しい項目、新しいテーブル、新しい保持ルールを誰が承認するのかが明確ではありません。
- パイプラインが毎週変わる:新しいソース、新しい結合、新しいMLの機能が追加され、カタログやタグが追いつかなくなります。
それでも、ガバナンスに投資すれば測定可能な効果が得られます。88%がデータ品質ガバナンスの改善を報告し、81%がレイクハウスのセキュリティガバナンスの向上を報告しています。地味な作業に取り組む価値は、ここに表れています。
ガバナンスの優先順位付け:正しい順序で正しいことに取り組む
- まずメタデータと責任の所在:重要なデータ要素を定義し、データオーナーとスチュワードを割り当て、カタログでビジネス用語を標準化します。
- 次にアクセス制御:最小権限の原則に基づいてRBACを実装し、例外に対する明確な承認経路を用意します。
- リネージと監査証跡:データの出所、変更内容、そして誰がアクセスしたかを追跡します。GDPR、HIPAA、CCPAに関する質問に素早く答えられるようになるのは、この部分があるからです。
- 最後に自動化(ただし着実に):ポリシーチェック、タグ付け、異常検知を自動化し、ガバナンスの実施が英雄的な努力に頼らないようにします。
HIPAAとCCPAが交わるとき、何が破綻するのか?
想像してみてください。HIPAAの規制対象となる医療データセット(患者の受診記録)が、CCPAの対象となるマーケティングデータセット(Webでの行動)と結合されているレイクハウスです。最初に破綻するのは通常、分類と同意管理です。PHIのタグが欠落し、同意フラグが結合を経由して伝播せず、下流のダッシュボードが意図した以上の情報を公開してしまいます。リネージがなければデータの行き先を証明できず、RBACがなければ広範なアクセスを止められず、監査証跡とID管理がなければ説明責任を示せません。
「本当の課題は、AIをうまく機能させることではなく、既存のシステムの中で責任を持って機能させることです。」
— Dr. Fei-Fei Li
冷静さを保つためのシンプルな習慣:月次のガバナンス振り返り
IT、セキュリティ、ビジネスの各オーナーと、45分間の月次振り返りを行いましょう。確認する項目は、メタデータの主なギャップ3つ、アクセス例外の主なもの3つ、リネージの障害1件、自動化の成功事例1件です。アクションは共有トラッカーに記録し、項目ごとに担当者を1名割り当ててください。
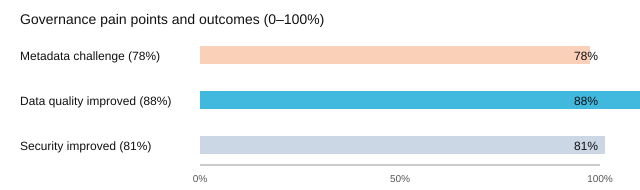
6) 過度に神経質にならないコンプライアンス:レイクハウスにおけるGDPR、HIPAA、CCPA
レイクハウスでは、コンプライアンスを直前に慌てて対応するものではなく、設計上の制約として扱ってください。取り込み、ストレージ、アクセスの各段階で最初から統制を組み込めば、GDPR・HIPAA コンプライアンスやCCPA データガバナンスは、緊急対応ではなく通常の運用として扱えるようになります。「Data Governance in Lakehouse」に関するStallion Journalの調査がその理由を示しています。メタデータ主導のガバナンス、自動化、MLを活用している組織では、GDPRとHIPAAのコンプライアンス遵守率が92%に上昇したと報告されています。これは目指すべき基準値として活用してください。保証された数字ではありません。
「セキュリティはプロダクトではなくプロセスであり、ガバナンスは、そのプロセスを誠実に保つための手段です。」
—Bruce Schneier
規制への統制のマッピング:コンプライアンスの基本ツールキット
「GDPR対応」や「HIPAA対応」は、ポリシーを書くだけでは実現できません。レイクハウス内で、要件を再現可能な統制に対応づける必要があります。
- RBAC(ロールベースのアクセス制御):PHI/PIIを閲覧できる人と、それをエクスポートできる人を制限します。
- レイクハウスの監査証跡:誰が、いつ、どこから、何にアクセスし、どのような操作をしたかを証明します。
- データリネージ:機微なフィールドの出所、変更の履歴、最終的な格納先を示します。
- ポリシーの適用:マスキング、保持、利用目的の制限を、各種ツール全体で一貫して適用します。
- メタデータ管理とカタログ:データを分類し、機密性のタグを付け、自動化を支えます。
| 規制 | 監査人が確認する事項 | レイクハウスでの統制 |
|---|---|---|
| GDPR | 適法なアクセス、最小化、保持 | RBAC、マスキング、保持ポリシー、リネージ |
| HIPAA | アクセスログ、安全管理措置、最小権限 | 監査証跡、RBAC、暗号化、監視 |
| CCPA | データインベントリ、アクセスと削除への対応 | カタログとメタデータ、リネージ、ポリシーのワークフロー |
次の課題:地域固有のルールとレガシー環境の制約
この論文では、今から計画しておくべき今後の課題として、地域固有のコンプライアンスと、レガシーまたは制約のある環境への適応性の向上が挙げられています。複数の州や国で事業を行う場合は、地域によって変えられるポリシーを構築してください(保持期間、同意ルール、侵害の報告など)。古いシステムを運用している場合は、対象範囲を小さく始め、段階的に統合してください。自動化は助けになりますが、複雑さは現実の問題です。
「監査の日」の流れ:提示が必要な資料
- データインベントリ:PII/PHIの保管場所、所有者、利用目的(
catalog + tags)。 - アクセスの証拠:RBACロール、承認記録、レイクハウスの監査証跡のエクスポート。
- リネージの証明:主要なデータセットと機微な列について、ソースからレポートまでの経路。
- ポリシーの証明:マスキング、保持、削除ワークフロー、および適用ログ。
- 関係者:データオーナー、セキュリティ担当、プラットフォーム管理者、コンプライアンス/法務担当、そしてデータを実際に使うアナリスト1名。
レーダービュー:ベースラインとガバナンスされたレイクハウスの比較
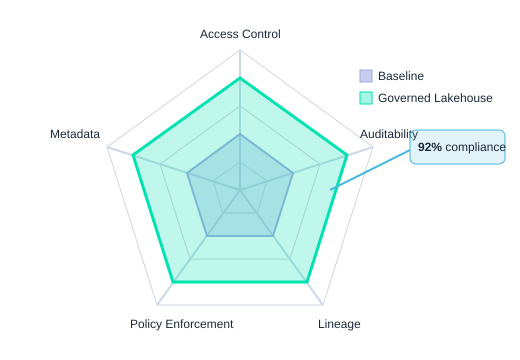
小さく正直な補足:組織の規模が小さい場合は、エンタープライズ向けツールを購入する前に、RBAC、ロギング、軽量なカタログといったシンプルなベースラインから始めてください。この研究が明らかにしているとおり、特にリソースが限られている場合、実装の複雑さは現実的な障壁になり得ます。
7) ベンダーのバイアス、政治的要因、ガバナンス資料が省略しがちな事柄
紙の上ではきれいなレイクハウスのガバナンスモデルを設計できても、データガバナンスツールが導入された途端に、その設計は歪みはじめます。現実は単純です。ツールやベンダーが「ベストプラクティス」の姿を形作っています。デモしやすく、購入しやすく、報告しやすいものが、その基準になるからです。
Stallion Journalのレイクハウス研究は、利益相反のセクションでこの点を直接取り上げています。ガバナンスプログラムには必ず存在すると想定すべき3つのバイアス源を指摘しています。ベンダーバイアス(Collibra Talend governanceのようなプラットフォームや、その他の商用スイートへの偏重)、組織の報告バイアス(「成功」の指標だけを共有すること)、そして財務上および規制上の圧力(自社のアーキテクチャに合うものではなく、監査人にとって安全に見えるものを選ぶこと)です。研究から得られる示唆は明確です。ガバナンスの選択をベンダーの語る物語に頼らず有用に保つには、透明性と情報開示が研究の信頼性を守るために不可欠です。
Satya Nadella:「信頼こそが究極の通貨です。データの世界では、何をしたのか、そしてなぜそうしたのかを明確に示すことで信頼を得られます。」
声に出して指摘すべきバイアスのリスク
ガバナンス研究とツールのバイアスリスク&ベンダーバイアス 40% レポートバイアス 35% 財務/規制 25% ベンダーバイアス レポートバイアス 財務/規制
バイアス対策チェックリスト(政治的ではなく、実践的に)
- サンプリング:AWS、Snowflake、Databricks、SAP、Oracle Cloud Infrastructureの各エコシステムについて、少なくとも1つの商用スイートと1つのオープンな選択肢を比較します。
- 情報開示:スポンサーの有無、ツール選定の理由、そしてテストしなかった項目を文書化します。
- 評価基準:リネージの深さ、RBAC/ABACへの適合性、監査証跡、APIアクセス、エクスポート形式、レイクハウスのテーブルとの統合性。
- 価値の検証(Proof-of-value):1つの領域で期間を区切ったパイロットを実施し、ポリシー適用にかかる時間、エラー率、ユーザーの負担を測定します。
- ベンダーロックインのリスク確認:ロックインがメタデータ、カタログ、ワークフロールールにどのように表れるかを確認します。
ミニストーリー:本当の意思決定を取りまとめるのはあなた
調達部門は「標準化」を理由に単一ベンダーへの統一を求めます。エンジニアは制御性を重視してオープンソースを望みます。コンプライアンス部門は「認定済み」の機能と明確な監査証跡を求めます。あなたの役割は、これらを橋渡しすることです。強力な統制と監査証跡でコンプライアンスの要件を満たし、APIとポータビリティでエンジニアの要望に応え、明確な投資対効果で調達部門を納得させます。ただし、どの部門にも「ツールが売っているものがガバナンスになる」という状態を許さないことが重要です。
もしツールが買収され、価格が3倍になったらどうしますか?
そうした事態は起こりうると想定してください。今のうちにポータビリティをテストしましょう。ビジネス用語集、データリネージ、ポリシールールを、実際に使える形式でエクスポートできますか? メタデータを移行できないなら、そのガバナンスはプログラムではなく、サブスクリプションに依存しているにすぎません。
8) 将来への備え:IoT、エッジ、分散型データ、そして引き継ぐことになるレイクハウス
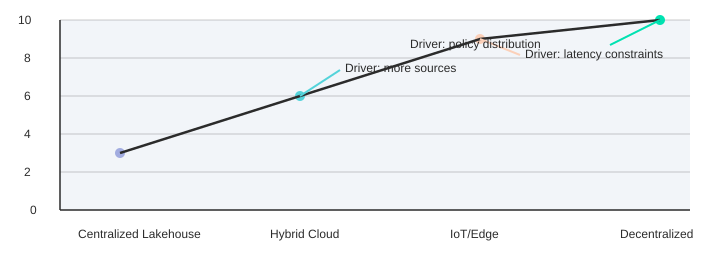
レイクハウスのガバナンスは、データが主に集中管理され、バッチ処理に適しており、少数のプラットフォームで制御されている場合に最もうまく機能します。IoTやエッジコンピューティングのガバナンスは、こうした前提を急速に崩します。具体的には、ソースが増え(デバイス、ゲートウェイ、アプリ)、中央による制御が弱まり(チームが独自にデプロイする)、レイテンシの制約が厳しくなる(アクセスや品質を判断するために「夜間のジョブを待つ」ことはできない)という課題に直面します。Stallion Journalの調査はこの圧力を明確に指摘し、IoTデータレイク、分散アーキテクチャ、エッジコンピューティングという3つの新しい領域に対するガバナンスの拡張を推奨しています。
IoTとエッジが現在のモデルに負荷をかける理由
IoTのストリームでは、同じ「顧客」イベントが、複数のセンサーから、異なる形式で、異なるタイミングで届くことがあります。ポリシーが単一の中央カタログの更新に依存していると、運用が遅くなるか、死角を受け入れることになります。また、エッジの拠点では速度と耐障害性のためにデータのローカルコピーが作られるため、監査証跡、リネージ、保持ルールはデータとともに移動する必要があります。単一のデータウェアハウス型の管理基盤に閉じ込められたままではいけません。
分散型データアーキテクチャにはポータブルなガバナンスが必要
分散型データアーキテクチャでは、ドメインがデータプロダクトを公開し、独自のスケジュールでスキーマを進化させます。これは提供スピードの面では健全ですが、「PII」「同意」「HIPAAの対象範囲」の定義が一貫していない場合にはリスクになります。将来に備えるとは、ガバナンスを共有サービスとして設計することです。拡張可能なメタデータ、バージョン管理されたポリシー、チームやリージョンをまたいで機能するID統制を整え、地域ごとのコンプライアンスへの適応性が必要だという論文の提言に沿うことが求められます。
継承できるクラウドネイティブの要素を基盤にする
この調査の周辺の参考資料は、実践的な構成要素を示しています。ポリシーサービスのパッケージングにはDocker、どこでも実行するにはKubernetes、ストリーミングによる実施フックにはKafka、高速な検索にはElasticsearch、ガバナンスされた処理にはPostgresとPySparkです。流行だからツールを選ぶのではなく、クラウド、オンプレミス、エッジのいずれでも同じ統制のもとで動かせるものを選ぶことが目的です。
「あらゆるものは常に故障する。ガバナンスは安定を前提にせず、変化を前提に設計せよ。」 — Werner Vogels
小さく賭けて前進するロードマップ
エッジのガバナンスを今日すべて解決する必要はありません。ただし、作り直さずに拡張できるメタデータとポリシーの仕組みは必要です。まず、ガバナンスのシグナル(スキーマのドリフト、通常と異なるアクセス経路、パターンから外れたエクスポート)に対するAIによる異常検知をパイロットとして始め、その後、取り込み時とクエリ時の自動ポリシーチェックへ広げてください。環境が拡大したら、より強固なID管理を追加し、重要な監査証跡についてはブロックチェーン的な改ざん検知の導入を検討し、リスクの区分に合わせた災害復旧計画を立ててください。
| 環境 | ガバナンスの複雑性指数(例示) |
|---|---|
| 集中型レイクハウス | 3 |
| ハイブリッドクラウド | 6 |
| IoT/エッジ | 9 |
| 分散型 | 10 |
ガバナンスの原則は、自分が交代することを前提に書いてください。明確な定義、ポータブルなポリシー、組織変更を生き延びる意思決定ログを用意します。後から引き継ぐレイクハウスは今より複雑になっているはずです。今のうちにそれを前提に設計しておけば、将来の自分も安心して眠れるでしょう。
Microsoft Fabric レイクハウス アーキテクチャ: 分析とデータ エンジニアリングのための Microsoft Fabric の理解
Microsoft Fabric のレイクハウスアーキテクチャとは何ですか?
Microsoft Fabric のレイクハウス アーキテクチャは、データ レイクとデータ ウェアハウスの要素を組み合わせた統合データ プラットフォームの設計です。生データと、構造化された変換済みのデータセットを 1 か所に保存できます。データ ボリュームには Azure Data Lake Storage を利用し、処理には Fabric のコンピューティング エンジンを使います。また、メダリオン アーキテクチャのパターンで生データ、拡充済みデータ、キュレーション済みデータの各レイヤーを管理するため、データを複製せずに、チームはデータの分析、データ サイエンスのワークロードの実行、Power BI でのレポート作成を行えます。
Fabric のレイクハウスでメダリオン アーキテクチャはどのように機能しますか?
Fabric のメダリオン アーキテクチャでは、データを一般的にブロンズ(生データ)、シルバー(クレンジングおよび拡充済み)、ゴールド(キュレーション済みで分析や BI にすぐ使える状態)のレイヤーに整理します。Fabric にはデータの取り込みと変換のツールが統合されており、レイヤー間でデータを移動および変換できます。これにより、データ エンジニアリングとデータ準備のワークフローを実現しつつ、データのコピーは 1 つに保ち、データの重複を抑えながら、分析やデータ サイエンスをサポートできます。
Microsoft Fabric でレイクハウスを実装し、作成するにはどうすればよいですか?
Microsoft Fabric でレイクハウスを実装するには、まずデータ ソースに接続し、Fabric のデータ取り込み機能を使ってデータを Azure Data Lake に取り込みます。次に、Fabric のコンピューティング エンジンまたはデータフローによる変換を使ってメダリオン アーキテクチャの処理を適用し、OneLake でデータセットをカタログ化して、アクセスを保護します。レポート作成には Power BI などの分析ツールを統合します。このプラットフォームはデータ管理を簡素化し、既存データやビッグデータをまたぐデータ統合をサポートします。さらに、不必要なデータ移動を避けたままデータを変換できます。
Microsoft Fabric におけるレイクハウスと従来のデータ ウェアハウスの違いは何ですか?
レイクハウスは、生データや半構造化データに対するデータ レイクの柔軟性と、データ ウェアハウスのパフォーマンスやスキーマ管理を兼ね備えています。Microsoft Fabric では、データを Azure Data Lake Storage に保存しながら、Fabric のコンピューティング エンジンを通じてウェアハウスに近いクエリ パフォーマンスを得られます。これにより、分析向けのキュレーション済みで構造化されたデータといったデータ ウェアハウスの機能を活用しつつ、最新のデータやデータ エンジニアリングのタスクに対してデータ レイクの柔軟性も維持できます。
Fabric ではデータの取り込みをどのように処理し、データの重複をどう避けるのですか?
Fabric は、ストリーミング、バッチ、エンタープライズ データ ソースへのコネクタといった複数のデータ取り込みパターンをサポートし、データを中央のレイク(Azure Data Lake)に取り込みます。メダリオン アーキテクチャと OneLake を使うことで、Fabric は物理的なコピーを複製するのではなく、データのコピーを 1 つに保ち、論理的なデータセットとして扱うことを促進します。データ統合と変換のツールを使うと、データを取り込み、その場で変換し、分析やデータ サイエンスのワークロードに一貫したデータ アクセスを提供できます。システム間のデータ複製を最小限に抑えられます。
既存のデータ ウェアハウスや Azure のデータを Fabric のレイクハウスと併用できますか?
はい、併用できます。Fabric は Microsoft 製品やサードパーティ製のシステムと統合でき、既存のデータ ウェアハウス、Synapse、Azure Data Lake Storage に対してクエリをフェデレーションできます。これにより、データ環境全体へのアクセスを統合できます。既存データを取り込むことも、参照することもできます。データ メッシュのパターンを実装することも可能です。ガバナンス、コスト、パフォーマンスの要件に応じて、データをレイクハウスに移動するか、直接アクセスするかを選べます。
分析やデータ サイエンスにおける Fabric のレイクハウスの一般的なユース ケースは何ですか?
一般的なユース ケースには、Power BI による BI 向けの統合データ管理、機械学習やデータ サイエンス向けの大量の生データの準備、メダリオン アーキテクチャを使った ELT パイプラインの構築、エンタープライズ システム全体にわたるデータの分析、構造化データと非構造化データを 1 か所にまとめることなどがあります。Fabric はデータ処理を簡素化し、拡張性の高いデータ分析を可能にします。また、データ メッシュやエンタープライズ データ カタログといった最新のデータ アーキテクチャもサポートします。
Fabric のレイクハウスではセキュリティ、ガバナンス、データ アクセスはどのように機能しますか?
Fabric は、ロールベースのアクセス制御、データ ポリシー、そしてガバナンスとデータ系列のための Microsoft Purview および Azure Active Directory との統合を提供します。OneLake とレイクハウスの構成要素により、Azure Data Lake Storage に保存されたデータに対してきめ細かいアクセス許可を設定できます。これにより、安全なデータ アクセス、コンプライアンス、管理されたデータ準備のワークフローを確保しつつ、データ取り込みや変換の各ステップで監査可能性を維持できます。
レイクハウスのさまざまなワークロードには、どの Fabric コンピューティング エンジンを使うべきですか?
Fabricには、特定のワークロードに最適化された複数のコンピュートエンジンが用意されています。分析やBI向けのインタラクティブなSQLクエリ、ビッグデータ処理やデータエンジニアリング向けのSpark、そしてリアルタイムの取り込みに特化したエンジンです。Fabricのコンピュートエンジンは、ワークロードの特性に基づいて選択してください。大規模な変換にはSpark、BIクエリにはWarehouse SQL、継続的な取り込みにはストリーミングエンジンを使うと、コスト、パフォーマンス、データ処理の要件のバランスを取りやすくなります。
Microsoft Fabricのレイクハウスアーキテクチャについて詳しく学び、始めるにはどこを見ればよいでしょうか。
始めるには、Microsoft Learnのチュートリアルに沿って学習し、Microsoft Fabricのレイクハウスアーキテクチャに関するドキュメントを確認して、Fabricでのメダリオンアーキテクチャの例を調べてみてください。まずデータソースに接続し、未加工のデータをAzure Data Lake Storageに取り込み、シンプルなメダリオンパイプラインを実装して、結果をPower BIで可視化します。これにより、Fabricがどのように統合されたデータ基盤上でレイクハウスの作成と分析の提供を簡素化するのかを理解できます。